Brauche ich für diesen Blog überhaupt WordPress und Kubernetes? Ein Hugo-Experiment, echte Zahlen und was eine Migration wirklich kostet
Ich habe einen Teil dieses Blogs in Hugo nachgebaut und mit WordPress auf K3s verglichen: Tempo, Hardware, Patchen, Sicherheit, Grafana, Ansible-Rollen und Migrationsaufwand. Die Entscheidung ist noch offen.
🌐 Auch auf: English · Français · Español
Update vom 6. November 2026: Inzwischen ist es entschieden und umgesetzt: Dieser Blog läuft jetzt auf Hugo. Was dabei passiert ist, steht hier.
Kurz gesagt: Dieser Blog besteht im Kern aus Text und Bildern, läuft aber auf Kubernetes mit Datenbank, PHP-Pool, Cache und zehn Plugins. Also habe ich einen Teil davon als statische Seite mit Hugo nachgebaut und beides verglichen. Das Ergebnis hat mich in beide Richtungen überrascht: Für die Leser ist der Tempogewinn kleiner als gedacht, für den Betrieb ist der Gewinn deutlich größer. Entschieden ist nichts. Dieser Blog läuft weiter auf WordPress.
In der Vergangenheit war mir Hugo zu umständlich, zu aufwendig und zu wenig benutzerfreundlich, sowohl in der Nutzung als auch beim Umbau von WordPress. Mit schneller KI-Unterstützung sieht das heute komplett anders aus: Umwandlung, Theme und Prüfskripte für diesen Test entstanden in kurzer Zeit. Deshalb stelle ich mir die Frage jetzt neu.
Dieser Beitrag sammelt alles, was ich vor einer Entscheidung wissen möchte: Messwerte, klar gekennzeichnete Schätzungen, die Folgen für jede Ansible-Rolle, Grafana, SELinux, die Frage nach einem neuen Repository, den echten Aufwand und eine Checkliste für den Fall, dass ich es wirklich mache.
Inhaltsverzeichnis
🧒 Für Nicht-ITler: Was ist der Unterschied?
WordPress baut eine Seite, wenn jemand sie aufruft: Ein Programm liest den Text aus einer Datenbank und setzt die Seite zusammen, ein Cache hebt das fertige Ergebnis eine Weile auf. Hugo baut alle Seiten einmal im Voraus auf meinem eigenen Rechner. Der Server gibt danach nur noch fertige Dateien aus. Für einen Besucher läuft kein Programm, es gibt keine Datenbank und keine Login-Seite, die jemand angreifen könnte.
Der Preis: Es gibt keinen bequemen Editor im Browser mehr. Ein Beitrag ist eine Textdatei, und Veröffentlichen heißt bauen und hochladen.
Was man mitnimmt: WordPress ist ein laufendes Programm, das Seiten ausliefert. Hugo ist ein Werkzeug, das Dateien erzeugt. Fast jeder Unterschied in diesem Beitrag folgt daraus.
🧪 Das Experiment: drei Beiträge, alle Seiten, vier Sprachen
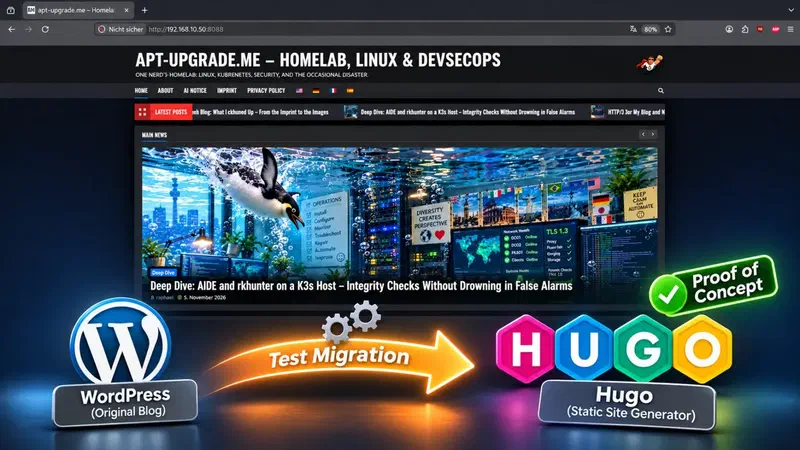
Ich habe die drei neuesten Beiträge und alle statischen Seiten auf Englisch, Deutsch, Französisch und Spanisch nach Markdown umgewandelt und ein kleines Theme mit denselben Farben, Schriften und demselben Seitenaufbau geschrieben. Ein Beitrag sieht auf der Platte jetzt so aus:
---
title: 'HTTP/3 für Blog und Nextcloud'
slug: http-3-fur-blog-und-nextcloud
date: '2026-11-03T19:59:27+01:00'
translationKey: wp3277
categories: [DevSecOps]
image: img/2026_11_no_http3.webp
---

**Update vom 4. November 2026:** HTTP/3 ist auf allen meinen Servern wieder aus.
Für Leser verhält sich die Seite gleich: gleiches Menü, Sprachflaggen, Laufband, Slider, Beitragsliste, Seitenleiste, Inhaltsverzeichnis und Suche. Die kleinen Unterschiede sieht man nur im direkten Vergleich. Das Theme ist ein eigener Nachbau und keine Kopie des WordPress-Themes, deshalb weichen einzelne Pixel ab.
Ähnliches Aussehen beweist wenig. Deshalb hat ein Skript jede Seite mit dem Original verglichen:
| Geprüft | Ergebnis |
|---|---|
| Seiten im Vergleich mit dem WordPress-Original | 28 von 28 im Text identisch |
| Code-Blöcke, Zeichen für Zeichen | 24, kein Unterschied |
| Tabellen, Überschriften, Listenpunkte | 20, 251 und 300, Anzahl identisch |
| Links im Artikeltext | 84, alle korrekt |
| Adressen, Canonical, hreflang, noindex | Auf allen 28 Seiten identisch |
| Interne Verweise im gesamten Build | 7.740 in 225 HTML-Dateien, 0 kaputt |
| Bauzeit | 1,9 s beim ersten Mal, danach 0,14 s |
| Umfang von Theme und Werkzeugen | 561 Zeilen Theme, 217 Zeilen Python |
Der Test hat auch die Fehler gefunden, für die er gedacht ist. Hugo ersetzte tel:-Links in meinem Impressum stillschweigend durch #ZgotmplZ. Monatsarchive in den anderen Sprachen landeten im englischen Pfad. Meine erste Fassung zeigte die Meta-Beschreibung statt des echten Einleitungstextes. Und das Logo war gespiegelt. Den ersten Fehler fand nur das Vergleichsskript; einen Telefon-Link hätte ich nie angeklickt.
Was man mitnimmt: Eine Migration ist nur so gut wie ihr automatischer Vergleich. Eine Seite, die richtig aussieht, kann trotzdem kaputten Inhalt haben.
⚡ Tempo: was ich gemessen habe und was ich nur schätze
Zuerst die Messwerte. Sie liefen von meinem Heimserver gegen den echten Blog, 14 Anfragen pro Zeile, gemessen wurde die Zeit bis zum ersten Byte. Eine statische Datei auf dem Live-Server steht dabei stellvertretend für das, was eine Hugo-Seite liefern würde.
| Anfrage | Median | Spanne |
|---|---|---|
| Statische Datei | 57 ms | 50–59 ms |
| Startseite aus dem WordPress-Seitencache | 58 ms | 55–62 ms |
| Beitrag aus dem WordPress-Seitencache | 60 ms | 56–63 ms |
| Derselbe Beitrag, von PHP erzeugt (Cache umgangen) | 146 ms | 134–163 ms |
Das ist die Überraschung: Eine gecachte WordPress-Seite ist so schnell wie eine statische Datei. Der Cache macht seine Arbeit bereits. Der Unterschied zeigt sich erst, wenn der Cache nicht greift.
Klarer ist der Gewinn bei der Menge, die ein Browser laden muss, ohne Bilder und Schriften:
| Startseite, komprimiert | WordPress | Hugo | Änderung |
|---|---|---|---|
| HTML | 19,4 KB | 4,9 KB | −75 % |
| CSS | 8 Dateien, 67,7 KB | 1 Datei, 3,6 KB | −95 % |
| JavaScript | 16 Dateien, 111,1 KB | 1 Datei, 1,0 KB | −99 % |
| Gesamt | 25 Dateien, 198 KB | 3 Dateien, 9,5 KB | −95 % |
Jetzt die Schätzungen. Das sind meine Erwartungen, keine Messungen. Einen echten Browser-Test unter realistischen Bedingungen habe ich noch nicht gemacht.
| Situation | Erwarteter Gewinn | Grundlage |
|---|---|---|
| Seite liegt schon im WordPress-Cache | Etwa 0 % | Gemessen: 57 gegen 58 ms |
| Seite liegt nicht im Cache | Etwa 60 % kürzere Wartezeit, rund 2,5-mal so schnell | Gemessen: 146 gegen 57 ms |
| Erster Besuch mit dem Handy bei mäßiger Verbindung | Grob 20–40 % schneller, bis die Seite nutzbar ist | Schätzung aus 95 % weniger CSS und JavaScript |
| Weitere Seiten im selben Besuch | Gering | Dateien liegen schon im Browser-Cache |
| Besucherspitze | Deutlich robuster | Kein Worker-Limit und keine Datenbank im Weg |
Was man mitnimmt: Tempo allein würde eine Migration nicht rechtfertigen. Ein gut gecachtes WordPress ist bereits schnell. Leser gewinnen vor allem durch weniger Code zum Herunterladen, am meisten auf dem Handy.
🖥️ Hardware: was der Server wirklich bräuchte
Das sind die heutigen Werte des Blog-Servers und meine Schätzung für eine statische Seite. Grafana und das gesamte Monitoring bleiben in beiden Fällen, weil ich sie behalten will.
| Wert | WordPress auf K3s (gemessen) | Hugo (Schätzung) |
|---|---|---|
| CPU | 4 Kerne, Last etwa 0,2 | 1–2 Kerne |
| Belegter Arbeitsspeicher | 2,7 GB von 7,5 GB | Etwa 1,0–1,2 GB |
| Sinnvolle Servergröße | 4 GB oder mehr | 2 GB |
| Kubernetes-Daten auf der Platte | 7,1 GB | 0 |
| Website auf der Platte | 375 MB Anwendung und Medien | Unter 500 MB für alle Beiträge |
| Laufende Pods / Container-Images | 17 / 14 | 0 / 0 |
| Hintergrundjob alle paar Minuten | wp-cron | Keiner |
| Firewall-Regeln (Ausgabe von nftables) | 7.760 Zeilen, meist von K3s | Einige hundert Zeilen |
Wohin der Speicher heute geht, nach belegtem Speicher pro Prozess. Die Werte überschneiden sich, ihre Summe liegt also über dem echten Verbrauch:
| Teil | Speicher | Mit Hugo |
|---|---|---|
| k3s-server | 847 MB | Fällt weg |
| containerd und seine Shims | 383 MB | Fällt weg |
| php-fpm | 349 MB | Fällt weg |
| MariaDB | 249 MB | Fällt weg |
| Ingress (nginx und Controller) | 316 MB | Ersetzt durch ein kleines nginx |
| Grafana | 357 MB | Bleibt |
| Alloy | 273 MB | Bleibt |
| Loki | 179 MB | Bleibt |
| Prometheus | 175 MB | Bleibt |
Was man mitnimmt: Die Website selbst bräuchte fast nichts. Das Monitoring wäre mit rund 1 GB der größte Posten auf dem Server und bestimmt dann die Mindestgröße.
📅 Täglicher Aufwand und Patchen
Seit dem 1. September gab es in diesem Repository 256 Commits, 76 davon berührten die drei großen Blog-Rollen. Das ist nicht alles Wartung, denn vieles war Aufbau. Es zeigt aber, wohin die Aufmerksamkeit geht. Der Update-Tag und die zwei PHP-Lücken an einem Tag zeigen gut, was das praktisch bedeutet.
| Aufgabe | WordPress auf K3s | Hugo |
|---|---|---|
| Betriebssystem-Updates | Ja | Ja |
| K3s, Helm, Ingress, cert-manager | Ja | Entfällt |
| WordPress, 10 Plugins, Theme | Ja, automatisch mit Prüfungen | Entfällt |
| PHP, auch Notfall-Patches | Ja | Auf dem Server entfällt es |
| MariaDB und Redis | Ja | Entfällt |
| Festgelegte Versionen für den Blog | 9 von 30 Einträgen, dazu der gemeinsame K3s-Stack | nginx aus dem System, Hugo auf meinem Rechner |
| Nächtlicher Image-Scan und seine Befunde | Ja, siehe Trivy | Entfällt; die Systempakete bleiben |
| Alarme zu Workern, Pods, Datenbank | Ja | Entfällt |
| Caches leeren nach einer Änderung | Seiten-, Objekt- und Optimierer-Cache | Entfällt |
| Monitoring- und Sicherheits-Mails lesen | Ja | Ja, mit viel weniger Anlässen |
| Einen Beitrag schreiben | Editor im Browser | Textdatei, Git, bauen, hochladen |
| Wenn ein Update etwas zerstört | Die Live-Seite kann ausfallen | Der Build schlägt fehl, die Live-Seite bleibt, wie sie ist |
| Rückweg | Datenbank-Dump und Dateien zurückspielen | Vorherigen Build hochladen |
Die Nextclouds bleiben auf K3s, mein Update-Tag verschwindet also nicht. Er wird nur kürzer.
Was man mitnimmt: Das ist der eigentliche Gewinn. Ganze Klassen von Updates, Notfällen und Alarmen verschwinden, weil die Software auf dem Server nicht mehr existiert.
🔐 Sicherheit: eine ehrliche Bewertung
Diese Bewertung ist meine Einschätzung, keine Messung. „Hoch“ bedeutet hier hohes Risiko.
| Bedrohung | WordPress auf K3s | Hugo | Warum |
|---|---|---|---|
| Lücke in Plugin oder Core | Mittel bis hoch | Keine | Auf dem Server läuft kein Code |
| Remote Code Execution in PHP | Mittel | Keine | Kein PHP |
| SQL-Injection | Niedrig bis mittel | Keine | Keine Datenbank |
| Gestohlener Admin-Login | Niedrig, dank 2FA und Geo-Filter | Keine | Es gibt keinen Web-Login |
| Datenverlust nach einem Einbruch | Mittel | Niedrig | Keine Nutzerdaten; ein sauberer Neuaufbau genügt |
| Lücke in nginx | Mittel | Mittel | Bleibt |
| Kernel oder Betriebssystem | Mittel | Mittel | Bleibt |
| SSH oder Deploy-Schlüssel | Niedrig | Niedrig bis mittel | Der Deploy-Schlüssel wird das wertvolle Geheimnis |
| Build-Kette (Hugo, Theme, mein Rechner) | Nicht relevant | Niedrig bis mittel | Neu: Ein vergifteter Build würde veröffentlicht |
| Grafana-Login | Niedrig bis mittel | Niedrig bis mittel | Bleibt und wird zum größten Web-Ziel |
| Kubernetes als Angriffsfläche | Niedrig bis mittel | Keine | Kein API-Server |
Zwei unbequeme Punkte. Erstens heißt „statisch“ nicht „sicher“: Server, SSH, nginx und DNS brauchen dieselbe Sorgfalt, und meine neun Schutzschichten werden nicht überflüssig. Zweitens ist der Host mit Grafana eben nicht rein statisch. Dort gibt es weiterhin einen Login, und der verdient die größte Aufmerksamkeit.
Was man mitnimmt: Die Angriffsfläche schrumpft deutlich, weil mehrere Angriffsklassen nichts mehr treffen. Die verbleibenden Risiken wandern zum Deploy-Schlüssel und zu Grafana.
🧱 Brauche ich auf dem Blog-Server noch K3s?
Technisch nein. Warum ich es gewählt habe, erklären der K3s-Deep-Dive und der Beitrag zu WordPress auf Kubernetes. Ein einzelnes nginx mit einem Ordner voller Dateien braucht keinen Orchestrator. K3s hat aber Vorteile, die ich wirklich verlieren würde:
| Aspekt | Mit K3s | Ohne K3s |
|---|---|---|
| Speicher und Platte | ➖ Etwa 1,2 GB RAM und 7,1 GB Platte | ➕ Nichts |
| Bewegliche Teile | ➖ API-Server, Kubelet, containerd, CNI, Ingress, cert-manager | ➕ Ein Dienst |
| Firewall | ➖ K3s fügt Tausende Zeilen hinzu; Vorsicht bei jeder Änderung | ➕ Nur meine eigenen Regeln |
| Updates | ➖ K3s, Charts und Images | ➕ Systempakete |
| Hochverfügbarkeit | ➖ Auf einem Knoten ohnehin keine | ➖ Auch keine |
| Trennung der Teile | ➕ Pods, NetworkPolicies | ➖ Bei einem Dienst kaum nötig |
| Updates ohne Ausfall | ➕ Rolling Updates eingebaut | ➕ Ersetzt durch atomaren Ordnerwechsel |
| Dieselben Werkzeuge wie auf den Nextclouds | ➕ Eine Arbeitsweise | ➖ Zwei Arbeitsweisen |
| Testfeld für die Nextclouds | ➕ Kleiner Host bekommt K3s-Updates zuerst | ➖ Fällt weg; eine Test-VM müsste das übernehmen |
| Lernwert und Blogstoff | ➕ Hoch | ➖ Auf diesem Host geringer |
Die Nextclouds sind ein anderer Fall: PHP, Collabora, Push und Cron-Jobs sind dort wirklich mehrere zusammenarbeitende Dienste.
Was man mitnimmt: Auf dem Blog rechtfertigt sich K3s nicht mehr durch technische Notwendigkeit, sondern durch Einheitlichkeit, Testen und Lernen. Das sind legitime Gründe, man sollte sie aber ehrlich so nennen.
📝 Welche Daseinsberechtigung WordPress weiterhin hat
Es wäre leicht, WordPress hier abzuschreiben. Das wäre falsch, denn es löst echte Probleme, die Hugo nicht löst:
| Stärke von WordPress | Mit Hugo |
|---|---|
| Editor im Browser, für jeden nutzbar | Texteditor und Git oder ein zusätzliches CMS-Werkzeug |
| Schreiben und Veröffentlichen vom Handy | Ohne Zusatzwerkzeuge umständlich |
| Mediathek mit Upload und Suche | Dateien in einem Ordner |
| Mehrere Autoren mit Rollen | Nur über Git oder ein Zusatzwerkzeug |
| Kommentare und Formulare | Externer Dienst nötig |
| Geplantes Veröffentlichen | Nur mit zeitgesteuertem Build |
| Plugins für fast alles | Selbst bauen |
| SEO-Analyse beim Schreiben (Yoast) | Meta-Tags ja, Live-Analyse nein |
| Übergabe an Nicht-Techniker | Kaum möglich |
| Shop, Mitglieder, dynamische Inhalte | Nicht das richtige Werkzeug |
Das würde aus den heutigen Plugins:
| Plugin | Mit Hugo |
|---|---|
| Polylang | In Hugo eingebaut |
| Yoast SEO | Eigene Vorlagen: Titel, Meta, Open Graph, Schema, Sitemap. Einfacheres Schema, keine Analyse im Editor |
| Easy Table of Contents | In Hugo eingebaut |
| Autoptimize | In Hugo eingebaut (Minify) |
| CompressX | Hugo-Bildverarbeitung beim Bauen |
| WP Super Cache, Redis Cache | Nicht nötig |
| Two Factor, Limit Login Attempts | Ohne Login nicht nötig |
| Classic Editor | Entfällt |
Dazu kommt ein persönlicher Punkt. Die meisten meiner letzten Beiträge entstehen mit KI-Unterstützung, der bequeme Editor zählt für mich also weniger als für die meisten Blogger. Für eine Markdown-Datei und einen Git-Commit wäre die Arbeit mit einem KI-Assistenten sogar einfacher als heute. Abhängig wäre ich trotzdem nicht: Markdown lässt sich mit jedem Texteditor bearbeiten.
Was man mitnimmt: WordPress bleibt die richtige Wahl, wenn andere Menschen schreiben, wenn man unterwegs veröffentlicht oder wenn die Seite mehr tut, als Inhalte anzuzeigen. Das falsche Werkzeug ist es nur, wenn nichts davon zutrifft.
📈 Wie viele WordPress-Seiten, wie viele Hugo-Seiten?
Hugo ist am Markt eine kleine Nische. Laut W3Techs, Stand 5. November 2026:
| Kennzahl | WordPress | Hugo |
|---|---|---|
| Anteil an allen Websites | 39,5 % | 0,1 % |
| Anteil an Websites mit bekanntem CMS | 58,2 % | 0,2 % |
| Verhältnis bei allen Websites | Etwa 400 : 1 | 1 |
| Sterne auf GitHub | 21.519 (ein Spiegel; entwickelt wird anderswo) | 90.379 |
| Lizenz | GPL | Apache 2.0 |
Diese Zahlen sind mit Vorsicht zu lesen. W3Techs nennt Anteile und keine absoluten Zahlen und erkennt statische Seiten nicht zuverlässig, Hugo ist also vermutlich untererfasst. Sterne messen das Interesse unter Entwicklern, nicht laufende Websites, und das WordPress-Repository ist nur ein Spiegel. Direkt vergleichen sollte man die beiden Werte nicht.
Etwas zeigen die Zahlen trotzdem: Millionen Menschen nutzen WordPress, ohne je ein Git-Repository gesehen zu haben, während Hugo gemessen an seinem Marktanteil eine ungewöhnlich große Anhängerschaft hat. Mein Eindruck, ohne harte Daten: Diesen Weg gehen vor allem die Nerds, und zwar aus Gründen, die zu diesem Beitrag passen: kein PHP, keine Datenbank, kein Login, wenig Angriffsfläche, Markdown und Git statt einer Weboberfläche. Eine schnelle Seite ist ein schöner Nebeneffekt. Bei vielen ist es vermutlich auch einfach die Freude an einem Aufbau, den man ganz versteht.
Was man mitnimmt: WordPress ist der sichere Mainstream mit dem größten Ökosystem, Hugo eine bewusst gewählte Nische. In der Minderheit zu sein ist in keine Richtung ein Argument.
🛡️ Würde SELinux einfacher?
Ja, im Web-Teil deutlich, verschwinden wird es aber nicht. Der SELinux-Deep-Dive zeigt, wie viel Arbeit darin steckt.
| Thema | WordPress auf K3s | Hugo auf AlmaLinux |
|---|---|---|
| Paket für Container-Regeln | k3s-selinux, für AlmaLinux 10 noch nicht stabil | Nicht nötig |
| Domänen für den Web-Teil | Container mit eigenen Kategorien | nginx im gut getesteten httpd_t |
| Dateien | Volumes und Container-Labels | Ein Ordner als httpd_sys_content_t |
| Relabeln nach einem K3s-Download | Pflicht | Entfällt |
| Proxy zu Grafana | Über den Ingress im Pod | Ein Boolean oder ein gelabelter Port |
Eigene Monitoring-Domänen (homelab_*) | Bleiben | Bleiben |
| Versteckte Verweigerungen durch dontaudit | Müssen geprüft werden | Müssen geprüft werden |
| Aufwand beim Umstieg | — | Neue Lernphase für nginx auf dem Host |
Auf FreeBSD stellt sich die Frage ganz anders, denn dort gibt es kein SELinux. An seine Stelle treten Jails und das MAC-Framework.
Was man mitnimmt: Der schwierigste SELinux-Teil, Container samt ihrem Paket, fällt weg. Der Enforcing-Modus bleibt, und auch die Pflicht, die tatsächliche Domäne jedes Dienstes zu prüfen.
📊 Grafana bleibt. Was bedeutet das?
Grafana läuft heute als normaler Systemdienst, ist aber über den K3s-Ingress erreichbar. Das ist die wichtigste Abhängigkeit:
| Teil | Heute | Mit Hugo | Aufwand |
|---|---|---|---|
| Grafana-Dienst | Systemdienst | Unverändert | Keiner |
| Zugriff über /grafana/ | K3s-Ingress | Reverse Proxy im nginx des Hosts, mit WebSocket-Unterstützung | Klein |
| Geo-Filter für den Login | Im Ingress | Umzug ins nginx des Hosts | Klein |
| fail2ban für den Grafana-Login | Liest Pod-Logs | Liest das nginx-Log, braucht neuen Pfad und Filter | Klein |
| Prometheus | Node, Kubelet, kube-state, MariaDB, PHP-FPM | Node und ein nginx-Exporter | Klein |
| Alloy und Loki | Lesen /var/log/pods | Lesen /var/log/nginx und das Journal | Mittel |
| Dashboard für Container | Vorhanden | Auf diesem Host nicht mehr | Entfernen |
| Dashboards für PHP-FPM, MariaDB, Redis | Vorhanden | Auf diesem Host nicht mehr | Entfernen |
| Alarme zu Workern, Pods, Datenbank | Aktiv | Entfernen, sonst melden sie NoData | Mittel |
| Neu: nginx-Anfragen und Fehler | Über den Ingress | Aus nginx-Exporter und Logs | Mittel |
| Neu: letzter erfolgreicher Deploy | — | Zeitstempel-Metrik mit Alarm | Klein |
| Ablauf der TLS-Zertifikate | Monit-Prüfung am Ingress | Monit-Prüfung am Host | Klein |
| Speicher | Etwa 1 GB | Etwa 1 GB | Bestimmt die Servergröße |
Eine frühere Lehre gilt hier direkt: Entferne ich Metriken und vergesse eine Regel, meldet sie vielleicht nichts mehr und sieht für immer grün aus. Nach einer Migration würde ich deshalb den Zustand jeder Regel prüfen, nicht das Ausbleiben von Mails.
Eine Alternative wäre ein zentrales Grafana zu Hause, das von allen Servern sammelt. Das nähme den letzten Login vom Blog-Host, ist aber eine eigene Entscheidung mit eigenen Risiken.
Was man mitnimmt: Grafana zu behalten ist kein Hindernis. Es bedeutet aber, dass Reverse Proxy, Geo-Filter und ein Login auf dem Host bleiben und dass das Monitoring auf nginx statt auf Pods umgebaut werden muss.
🎭 Die Ansible-Rollen im Einzelnen
Meine erste Annahme war, dass kaum Rollen übrig bleiben. Das war falsch. Die meisten Rollen schützen den Host und nicht WordPress, also bleiben die meisten auch. Das sind die 29 Rollen in blog.yml, mit der Zahl der Zeilen, die sich auf Kubernetes beziehen:
| Rolle | Zeilen | K8s-Zeilen | Mit Hugo |
|---|---|---|---|
| blog_k3s_deploy | 2.962 | 69 | ❌ Fällt weg |
| blog_wordpress | 1.473 | 45 | ❌ Fällt weg |
| common_k3s | 1.139 | 186 | ❌ Nicht auf diesem Host (Nextcloud behält sie) |
| common_kube_metrics | 214 | 5 | ❌ Nicht auf diesem Host |
| common_trivy | 406 | 14 | ❌ Nicht auf diesem Host (keine Images) |
| blog_packages | 222 | 0 | 🔄 Neu schreiben: nginx, ACME-Client, rsync |
| blog_verify | 478 | 13 | 🔄 Neu schreiben: Seite, Zertifikate, Links, Deploy |
| blog_visitor_stats | 237 | 3 | 🔄 Neuer Log-Pfad, gleiche Idee |
| common_version_check | 340 | 49 | 🔄 Neuer Blog-Zweig |
| common_version_active | 223 | 17 | 🔄 Neuer Blog-Zweig |
| common_fail2ban | 487 | 42 | 🔧 Neue Log-Pfade, WordPress-Jail entfällt |
| common_firewall | 1.179 | 18 | 🔧 Einfacher: keine K3s-Tabellen oder NodePorts |
| common_monit | 702 | 12 | 🔧 Keine Pod-Prüfung; nginx- und Deploy-Prüfung |
| common_grafana | 1.552 | 0 | 🔧 Weniger Dashboards und Alarme |
| common_loki | 843 | 7 | 🔧 Log-Dateien statt Pod-Logs |
| common_prometheus | 451 | 1 | 🔧 Andere Ziele |
| common_selinux | 220 | 6 | 🔧 Kein k3s-selinux; nginx-Regeln |
| common_selinux_monitoring | 399 | 0 | 🔧 Weniger Domänen |
| common_clamav | 261 | 0 | 🔧 Vermutlich aus: keine Uploads auf dem Server |
| common_cis_hardening | 571 | 8 | 🔧 K3s-Ausnahmen entfernen |
| common_auditd | 252 | 4 | 🔧 K3s-Pfade entfernen |
| common_sysctl | 313 | 2 | 🔧 K3s-Einstellungen entfernen |
| common_aide_refresh | 101 | 1 | 🔧 Web-Ordner bewusst ausgenommen |
| common_dnf_automatic | 225 | 1 | 🔧 Kleine Anpassung |
| common_ssh | 650 | 0 | ✅ Unverändert |
| common_msmtp | 138 | 0 | ✅ Unverändert |
| common_rkhunter | 187 | 0 | ✅ Unverändert |
| common_logrotate | 115 | 0 | ✅ Unverändert, nginx kommt dazu |
| common_node_exporter | 273 | 1 | ✅ Unverändert |
| Ergebnis | Rollen |
|---|---|
| ❌ Fällt auf diesem Host weg | 5 |
| 🔄 Neu schreiben | 5 |
| 🔧 Anpassen | 14 |
| ✅ Unverändert | 5 |
In Zeilen gerechnet, würden von den rund 16.600 Zeilen, die der Blog heute durchläuft, etwa 6.200 dort nicht mehr gebraucht, also 37 %. Nur rund 4.400 davon verschwänden wirklich aus dem Repository, denn den Rest brauchen die Nextclouds. Die Ansible-Tour zum Blog würde zum historischen Dokument.
Natürlich müsste auch einiges neu entstehen:
| Neu | Was es tut | Umfang |
|---|---|---|
| Rolle für die statische Seite | nginx auf dem Host, Sicherheits-Header, Weiterleitungen, Grafana-Proxy | Mittel |
| Zertifikate | ACME-Client mit Erneuerung und nginx-Reload statt cert-manager | Klein |
| Deploy | Eingeschränkter Nutzer, rsync, neuer Ordner pro Release, atomarer Wechsel, letzte Stände behalten | Klein bis mittel |
| nginx-Exporter | Anfragen und Fehler für Prometheus | Klein |
| Build-Pipeline | Hugo-Version festlegen, bauen, vergleichen, Suchindex, hochladen | Mittel |
| Prüfung | Link-Check und Inhaltsvergleich bei jedem Build | Aus dem Experiment vorhanden |
| Weiterleitungstabelle | Alte Adressen wie der Feed und Medienpfade | Klein |
| Backup | Vereinfacht: Inhalte in Git, dazu Server-Konfiguration und Logs | Klein |
Was man mitnimmt: Die teuren Rollen fallen weg, die Sicherheitsbasis bleibt. Das ist eine gute Nachricht: Die über Monate aufgebaute Härtung geht mit.
📦 Ein neues Repository?
Mein Repository enthält derzeit beide Stacks. Die gemeinsamen Rollen entscheiden über die Play-Variable stack, und meine Regel lautet, dass jede Änderung für beide funktionieren muss. Ein Umstieg auf Hugo wirft die Frage auf, wie man das aufteilt:
| Möglichkeit | Vorteil | Nachteil |
|---|---|---|
| A: Alles im bestehenden Repository | Ein Ort, eine Historie | Jeder Beitrag und jedes Bild landet in der Ansible-Historie und läuft durch deren Lint; das Repository wächst mit den Medien |
| B: Neues Repository für Inhalt, Theme und Build. Ansible bleibt | Saubere Trennung; keine Änderung an den gemeinsamen Rollen; eigene, einfache CI | Zwei Repositories; der Deploy muss sie verbinden |
| C: Komplette Trennung mit gemeinsamen Rollen als Collection | Sauber bei mehreren Nutzern | Versionen und Releases für nur zwei Nutzer; hoher Aufwand |
| D: Eigenes Ansible-Repository für den Blog mit kopierten Rollen | Völlig unabhängig | Jeder Sicherheitsfix doppelt; die Kopien laufen auseinander |
Ich würde Möglichkeit B wählen. Beiträge, Bilder, Theme und Build-Skripte kämen in ein neues Repository. Der Server bleibt im Ansible-Repository mit einem dritten Wert, stack: static. Die Rollen bleiben an einem Ort, und die Härtung muss nicht doppelt gepflegt werden. Zum Veröffentlichen reicht dann ein eingeschränkter Deploy-Schlüssel statt Zugriff auf den Ansible-Code und seinen Vault.
Der Preis ist aber real: Aus der Regel „funktioniert für beide Stacks“ wird „funktioniert für drei“. Umgekehrt verschwinden in vielen Rollen die WordPress-Zweige.
Was man mitnimmt: Inhalt und Infrastruktur ändern sich unterschiedlich schnell und tragen unterschiedliche Geheimnisse, gehören also in getrennte Repositories. Gemeinsame Härtung sollte man nicht kopieren.
🐡 Und auf FreeBSD?
Ich bin seit Jahren von FreeBSD begeistert, auch wenn es neben Linux eher ein Nischendasein führt. Es ist ein komplettes System aus einem Guss, mit sehr guter Dokumentation, Jails, ZFS und pf. Für diesen Blog hatte es trotzdem nie eine Chance, denn K3s hängt an Funktionen des Linux-Kernels und läuft dort nicht produktionsreif.
Genau das ändert Hugo. Ohne K3s, Container, PHP und Datenbank schrumpfen die Anforderungen auf nginx, einen ACME-Client, rsync und das Monitoring, und all das ist auf FreeBSD gewöhnliche Software. Die Komplexität, die mich an Linux gebunden hat, ist weg. Hier alle drei Varianten im Vergleich:
| Thema | WordPress auf K3s | Hugo auf AlmaLinux | Hugo auf FreeBSD |
|---|---|---|---|
| RAM mit vollem Monitoring (Schätzung) | 2,7 GB | Etwa 1,0–1,2 GB | Etwa 1,0–1,2 GB |
| Patchen | ➖ Viele Schichten | ➕ System und nginx | ➕ freebsd-update und pkg |
| Automatische Updates | ➕ Vorhanden | ➕ Vorhanden | ➖ Muss gebaut werden |
| Trennung der Dienste | ➕ SELinux und Pods | ➕ SELinux und systemd-Sandbox | ➖ Jails, gröber, aber einfach |
| Firewall und Sperren | ➕ Vorhanden | ➕ Vorhanden, einfacher | ➖ pf und fail2ban neu |
| Wiederverwendbare Rollen | Alle | 24 von 29, teils angepasst | Wenige; das meiste wäre neu |
| Grafana, Prometheus, Loki | ➕ Vorhanden | ➕ Vorhanden, angepasst | ➖ Pakete gibt es; Pfade und Regeln neu |
| Snapshots vor Updates | ➖ Keine | ➖ Standardmäßig keine | ➕ ZFS |
| Betrieb neben den Nextclouds | ➕ Gleich | ➕ Gleiches Betriebssystem | ➖ Zweite Plattform |
| Vorhandenes Wissen | ➕ Groß | ➕ Groß | ➖ Muss aufgebaut werden |
| Wert als Blogthema | Schon geschrieben | Mittel | ➕ Hoch |
Die entscheidende Frage ist, ob sich dieser Aufbau ähnlich gut absichern lässt wie der heutige. Ich habe das Schicht für Schicht bewertet. Das ist eine Bewertung auf dem Papier: Auf FreeBSD habe ich es weder gebaut noch getestet.
| Schicht | Heute auf AlmaLinux | Hugo auf FreeBSD | Bewertung |
|---|---|---|---|
| Paketfilter | nftables | pf mit Tables | 🟢 Gleichwertig |
| SSH-Härtung, Geo-Filter | sshd und nftables-Sets | sshd und pf-Tables | 🟢 Gleichwertig |
| Angreifer sperren | fail2ban | fail2ban mit pf | 🟢 Gleichwertig, neue Regeln nötig |
| nginx isolieren | SELinux und systemd-Sandbox | Jail, Inhalte nur lesend eingehängt | 🟢 Gut; einfach und leicht zu prüfen |
| Monitoring isolieren | Eigene SELinux-Domänen | Eine Jail pro Dienst | 🟡 Gröber, aber klare Grenzen |
| Feine Regeln pro Prozess | SELinux Type Enforcement | Keine direkte Entsprechung; MAC-Framework, Capsicum nur, wo die Software es unterstützt | 🔴 Schwächer |
| Angriffsfläche am Webserver | Mit WordPress: groß | Statische Dateien | 🟢 Viel kleiner als heute |
| Informationen zu Sicherheitslücken | dnf, Trivy | pkg audit und freebsd-update | 🟢 Gut |
| Audit-Log | auditd | OpenBSM | 🟡 Im Prinzip gleichwertig; Auswertung neu |
| Datei-Integrität, Rootkits | AIDE, rkhunter | AIDE, rkhunter, freebsd-update IDS | 🟢 Gleichwertig |
| Rückweg nach einem Update | Pakete, Wiederherstellung | ZFS-Snapshots und Boot Environments | 🟢 Besser |
| Härtungsbasis | CIS-Benchmark in meiner Rolle umgesetzt | Muss von Hand neu entstehen | 🟡 Aufwand; weniger fertiges Material |
| Grafana | Hinter Geo-Filter und fail2ban | Genauso, in einer eigenen Jail | 🟡 Bleibt das größte Ziel |
| Erfahrung aus echten Vorfällen | Monate voller echter Befunde | Beginnt bei null | 🔴 Anfangs schwächer |
Meine Einschätzung: Ja, für eine statische Seite ließe sich FreeBSD insgesamt ähnlich gut absichern, nur mit anderen Mitteln. Wirklich verlieren würde ich die feine Kontrolle von SELinux pro Prozess. Bei einem WordPress mit PHP und Plugins täte das weh. Bei einem nginx, das aus einer Jail nur lesend Dateien ausliefert, fällt es weit weniger ins Gewicht, weil ein Angreifer dort schlicht viel weniger tun kann. Dafür sind Jails einfach genug, um sie mit bloßem Auge zu prüfen. Die zwei echten Schwachstellen sind Grafana, das weiterhin einen Login braucht, und meine fehlende Praxis: Mein AlmaLinux-Aufbau ist durch Monate echter Fehler gegangen, ein FreeBSD-Aufbau wäre das noch nicht.
Ein offener Punkt: Die Pakete für Grafana, Prometheus, Loki und node_exporter gibt es meines Wissens in den FreeBSD-Ports, Alloy und die aktuellen Versionen müsste ich aber erst prüfen. Andernfalls bräuchte es einen anderen Log-Sammler.
Was man mitnimmt: Der große Gewinn kommt von Hugo, nicht vom Betriebssystem. Aber erst Hugo macht FreeBSD überhaupt möglich: Ist K3s weg, ist die Wahl keine technische mehr. Sie wäre eine Überzeugungsfrage, und für eine statische Seite eine vertretbare.
💶 Kosten und Nutzen
| Punkt | Kosten | Nutzen |
|---|---|---|
| Migration | Einmalig, siehe unten | — |
| Server | — | Kleinerer und günstigerer Server möglich |
| Wartung | Neue Build-Kette zu pflegen | Viel weniger Patchen und weniger Alarme |
| Sicherheit | Deploy-Schlüssel und Build schützen | Mehrere Angriffsklassen weg |
| Tempo | — | Weniger Download; besser bei Spitzen und ohne Cache-Treffer |
| Schreiben | Kein Editor, kein Handy-Workflow | Git-Historie, einfache Dateien, leicht mit KI |
| Backups | — | Viel einfacher |
| Übertragbarkeit | — | Markdown läuft überall; keine Datenbank-Bindung |
| Wissen | Testfeld für K3s fällt weg | Weniger Sonderfälle im Kopf |
| SEO | Risiko beim Umzug; keine Yoast-Analyse | Schnelle Seiten und volle Kontrolle |
| Blogstoff | Weniger Betriebsgeschichten von diesem Host | Eine gute Migrationsgeschichte |
Einen Serverpreis kann ich hier nicht sinnvoll nennen, das hängt vom Anbieter ab. Die Ersparnis ist in jedem Fall überschaubar. Die eigentliche Währung ist hier Aufmerksamkeit.
Was man mitnimmt: Man bezahlt diese Migration nicht mit Geld und bekommt sie auch nicht in Geld zurück. Es ist ein Tausch: Bequemlichkeit beim Schreiben gegen deutlich weniger Betriebsarbeit.
⏱️ Wie viel Arbeit wäre das?
Der Blog hat 143 Beiträge in je vier Sprachen, insgesamt 572, dazu 16 statische Seiten und rund 1.400 Mediendateien. Die folgenden Werte sind Schätzungen. Das Experiment lief mit KI-Unterstützung an etwa einem Abend, die Umwandlung ist also vermutlich der kleinste Teil.
| Phase | Mit KI-Unterstützung | Hinweis |
|---|---|---|
| Bestandsaufnahme: Plugins, Sonderblöcke, Downloads | 2–3 h | Export-Werkzeug vorhanden |
| Alle Beiträge und Medien umwandeln | 3–6 h | Skript vorhanden; ältere Beiträge bergen Überraschungen |
| Theme fertigstellen: Seitennavigation, Tags, Archive, Handy | 3–5 h | Grundlage vorhanden |
| SEO: Adressen, Weiterleitungen, Feed, Schema, Sitemap | 2–3 h | Automatischer Vergleich mit der heutigen Sitemap |
| Ansible: neue Rolle, 14 angepasst, 5 neu, Test-VM | 8–15 h | Der größte Teil |
| Monitoring und Grafana | 3–5 h | Jede Regel prüfen |
| Backup, Restore-Test, Doku in drei Sprachen, Datenschutztext | 3–5 h | Muss sorgfältig sein |
| Umstellung und aktive Beobachtung | 2–3 h | Danach zwei Wochen Beobachtung |
| Gesamt, Hugo auf AlmaLinux | Etwa 26–45 h | Praktisch verteilt auf 2–3 Wochen |
| Zusätzlich für FreeBSD | Etwa 15–30 h | Wenige Rollen wiederverwendbar |
| Ohne KI-Unterstützung (grobe Vermutung) | 3–5 Arbeitswochen | Vor allem Theme, Umwandlung und drei Sprachen |
Echte Läufe auf den Produktivservern, die Durchsicht jedes Diffs und die Entscheidungen bleiben bei mir. KI macht das Tippen schneller, nimmt aber nicht die Pflicht zum Prüfen ab.
Was man mitnimmt: Die meiste Arbeit steckt nicht in der Umwandlung, sondern in Ansible, Monitoring und Prüfung. Dort sollte man die Zeit einplanen.
✅ Was ich tun müsste, wenn ich mich für Hugo entscheide
- Anforderung klären: Kann ich ohne Browser-Editor und Handy-Workflow leben? Ohne diese Antwort ist alles andere egal.
- Plattform wählen: AlmaLinux als Standard, FreeBSD nur als bewusste Entscheidung.
- Vollständig sichern: Datenbank, Dateien und Medien. Die WordPress-Installation mehrere Wochen verfügbar halten.
- Inhalts-Repository anlegen mit Beiträgen, Medien, Theme und festgelegter Hugo-Version. Vor dem ersten Push alles auf Geheimnisse scannen.
- Alles umwandeln und jede Seite automatisch vergleichen: Text, Code-Blöcke samt Backslashes, Tabellen, Links, Alt-Texte, Titel und Beschreibungen.
- Jede Adresse behalten: Beiträge, Sprachen, Kategorien, Tags und auch
/wp-content/uploads/, weil Bilder von außen verlinkt sind. Gegen die heutige Sitemap vergleichen. - Weiterleitungen einrichten: Der RSS-Feed zieht ohne Konfiguration von
/feed/nach/index.xml. Auch?p=-Links und die alte Suchadresse prüfen. - Datenschutzerklärung neu schreiben und das Impressum prüfen. Der heutige Text beschreibt WordPress und seine Plugins. Auch den KI-Hinweis und die Lizenzen aller Downloads prüfen.
- Theme und SEO fertigstellen, samt Open-Graph-Bildern unter dem WhatsApp-Limit und
noindexfür die rechtlichen Seiten. - Den Ansible-Teil auf einer Test-VM bauen:
stack: static, die neue Rolle, die angepassten Rollen. Zweimal laufen lassen; der zweite Lauf musschanged=0zeigen. - SELinux wirklich prüfen: Domänen mit
ps -eZ, versteckte Verweigerungen mitsemodule -DBund das eigene Log jedes Dienstes. - Monitoring umbauen: Grafana hinter nginx mit Geo-Filter und fail2ban, neuer Exporter, alte Regeln entfernen, dann den Zustand jeder Regel prüfen.
- Den Deploy-Weg absichern: eingeschränkter Schlüssel, atomarer Wechsel, letzte Releases behalten und ein Alarm, wenn der Deploy fehlschlägt.
- Eine Wiederherstellung testen: einen sauberen Server nur aus den Repositories bauen, bevor Produktion angefasst wird.
- Alles drumherum anpassen: Backup-Skripte, Prüfung von außen, Update-Check, Drift-Check, Betriebshandbücher in drei Sprachen und ein Hinweis an den älteren Deep Dives.
- Die Umstellung planen: DNS-TTL senken, ruhige Zeit wählen, Rückweg bereithalten und danach Suchmaschinen und Logs auf 404-Fehler prüfen.
- Zwei Wochen beobachten und erst dann WordPress und K3s vom Host entfernen.
Was man mitnimmt: Die meisten Punkte haben gar nichts mit Hugo zu tun. Es geht darum, keine Adressen zu verlieren, rechtlich korrekt zu bleiben, das Monitoring zu erhalten und einen Rückweg zu haben.
🌐 Würde HTTP/3 einfacher?
Teilweise. Wie im HTTP/3-Beitrag beschrieben, habe ich es abgeschaltet, weil Verbindungen nach einem Reload hingen. Mit nginx direkt auf dem Host wäre die Einrichtung einfacher, weil der Umweg über den Ingress wegfällt. Die Ursache bleibt aber: Alte Worker halten die UDP-Sockets fest. Das ist eine Sache von nginx, nicht von K3s, und deshalb habe ich Issue #1937 eröffnet. Weniger lange Verbindungen und seltene Reloads würden das Problem abmildern. Getestet habe ich das nicht. Auf einer statischen Seite wäre der Nutzen ohnehin klein, ich würde es also vorerst auslassen.
Was man mitnimmt: Eine einfachere Einrichtung behebt keinen Fehler in der Schicht darunter.
🎯 Die Lehren
- Erst messen, dann glauben. Ich habe einen großen Tempogewinn erwartet. Ein gecachtes WordPress antwortete in 58 ms, eine statische Datei in 57 ms.
- Der meiste Nutzen liegt im Betrieb. Software, die es nicht mehr gibt, braucht keinen Patch, keinen Alarm und keinen Notfall.
- Härtung überlebt. Meine Annahme, dass kaum Rollen bleiben, war falsch: 24 von 29 bleiben zumindest teilweise, weil sie den Host schützen.
- „Statisch“ ist nicht automatisch „einfach“. Grafana, Deploy und Build-Kette bleiben, und das Risiko wandert zum Deploy-Schlüssel.
- Eine Migration braucht ein Vergleichswerkzeug. Ohne es hätte ich die kaputten Telefon-Links im Impressum übersehen.
🤔 Wo ich gerade stehe
Ich habe mich nicht entschieden. K3s und WordPress sind für diesen Blog technisch nicht mehr nötig, so viel ist klar. Ebenso klar ist, dass sie mich Aufmerksamkeit kosten, die Leser aber nichts. Auf der anderen Seite stehen der Editor, das K3s-Testfeld für die Nextclouds und ein Aufbau, der funktioniert und den ich sehr gut kenne.
Wenn ich es mache, dann mit Hugo und einem getrennten Inhalts-Repository, das Monitoring bleibt. AlmaLinux ist die vernünftige Wahl, weil fast alles mitgeht. FreeBSD ist die Wahl, die mich begeistert, und zum ersten Mal wäre sie auf diesem Blog eine realistische. Und wenn es so weit ist, gibt es einen zweiten Teil mit den echten Zahlen, einschließlich allem, was diese Schätzungen falsch vorhergesagt haben.