Der Blog läuft jetzt auf Hugo: ohne WordPress, ohne Kubernetes und mit stabilem HTTP/3
Dieser Blog läuft nicht mehr auf WordPress und K3s, sondern als statische Seite auf AlmaLinux 10. Was sich geändert hat, was beim Test schiefging und warum HTTP/3 wieder an ist.
🌐 Auch auf: English · Français · Español
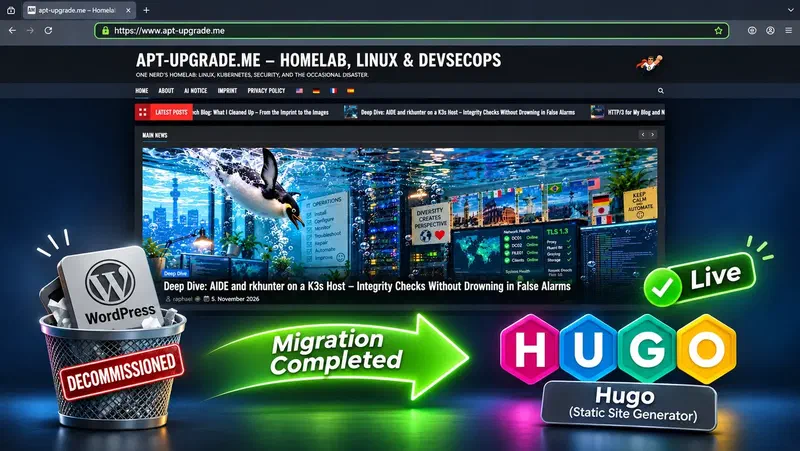
Kurz gesagt: Dieser Blog läuft nicht mehr auf WordPress und Kubernetes. Er besteht jetzt aus fertigen Dateien, die nginx auf einem gehärteten AlmaLinux 10 ausliefert. Im Hugo-Experiment vor wenigen Tagen war noch nichts entschieden, am 6. November 2026 habe ich umgestellt: Alle Beiträge in vier Sprachen liegen unter ihren alten Adressen, Grafana und die Härtung sind geblieben, PHP, Datenbank und Cluster sind weg. Und HTTP/3, das ich noch diese Woche abgeschaltet hatte, läuft wieder.
Dieser Beitrag beschreibt, was sich geändert hat, was beim Testen schiefging, wie sich die Leistung verändert hat und was der Umstieg für meinen Alltag und meine Backups bedeutet.
Inhaltsverzeichnis
🧒 Für Nicht-ITler: Was ist anders?
Bisher baute ein Programm jede Seite aus einer Datenbank zusammen, sobald jemand sie aufrief, und ein Cache hob das Ergebnis eine Weile auf. Jetzt baue ich alle Seiten einmal im Voraus auf meinem eigenen Rechner und lade sie fertig hoch. Der Server gibt nur noch Dateien aus. Für Besucher läuft dabei kein Programm mehr, es gibt keine Anmeldung und nichts, das ein Angreifer mit einer manipulierten Anfrage ausführen könnte.
Was man mitnimmt: Die Seite sieht gleich aus. Geändert hat sich, was dahinter läuft, und das ist heute deutlich weniger.
🔄 Was sich geändert hat
| Vorher | Jetzt | |
|---|---|---|
| Betriebssystem | AlmaLinux 9 mit K3s | AlmaLinux 10 ohne Kubernetes |
| Webserver | ingress-nginx im Cluster | nginx mainline 1.31.8 direkt auf dem Host |
| Inhalt | MariaDB und Medienordner | Dateien im privaten Git-Repository |
| Laufzeit für Besucher | PHP-FPM, Redis, Page-Cache | keine |
| Anmeldung | WordPress-Admin mit 2FA | nur noch Grafana, Veröffentlichen per SSH-Schlüssel |
| Suche | WordPress | Pagefind, läuft im Browser |
| HTTP/3 | abgeschaltet | an |
| Monitoring | Prometheus, Grafana, Loki, Monit | unverändert, nur ohne Cluster-Metriken |
Die Firewall habe ich dabei neu geordnet. Weiterleitung ist komplett aus, denn ohne Pod-Netz muss der Host nichts mehr routen, und rp_filter steht wieder auf streng. Alles, was es nur wegen K3s gab, ist weg: NodePort-Ketten, Pod-Ausnahmen, Audit-Regeln für den Cluster. fail2ban hat keine WordPress-Login-Regel mehr, Aufrufe von /wp-login.php zählen jetzt als Angriffsversuch. nginx darf nach außen keine Verbindung mehr öffnen, nur noch zu Grafana auf Loopback.
Was man mitnimmt: Ein Umbau ist die seltene Gelegenheit, Regeln wirklich zu löschen. Vieles davon war nur noch da, weil es einmal nötig war.
📦 Die neue Repository-Struktur
Aus einem Repository wurden drei:
www_hugo(öffentlich): Ansible für den Blog-Server. Eine einzigeansible-playbook-Zeile baut die Maschine von null auf.www_hugo_content(privat): Beiträge, Bilder, Theme, Build- und Deploy-Skripte.nextcloud_k3s(öffentlich): Der Nextcloud-Teil läuft dort unverändert weiter auf K3s.www_k3s: Das alte Repository ist archiviert und bleibt als Nachschlagewerk stehen.
Der Inhalt ist privat, weil Git nichts vergisst. Ein Bild, das ich später aus rechtlichen oder persönlichen Gründen entferne, bliebe in einem öffentlichen Repository dauerhaft in der Historie abrufbar.
Im Experiment-Beitrag hatte ich vor kopierten Rollen gewarnt, weil jeder Sicherheitsfix dann doppelt anfällt. Das bleibt der Preis dieser Lösung. Dagegen steht jetzt scripts/compare-roles.sh, das die Unterschiede der gemeinsamen Rollen anzeigt. Dass die Trennung auch Arbeit spart, zeigt die Zahl: Das Blog-Repository ist bei der Aufteilung um rund 34.800 Zeilen geschrumpft.
Was man mitnimmt: Ein getrenntes Repository löst nicht alles. Es tauscht die Regel „jede Änderung muss für beide Stacks passen“ gegen die Pflicht, Lehren aktiv zu übertragen.
✍️ Beiträge im Repository statt in der Datenbank
Ein Beitrag ist jetzt eine Markdown-Datei. Mein Alltag sieht damit so aus:
# Beitrag schreiben, Vorschau lokal ansehen, dann:
tools/build.sh                          # baut alle Seiten und den Suchindex
tools/deploy.sh <host>                  # Upload, dann atomarer Wechsel
tools/deploy.sh <host> 10022 rollback   # falls etwas nicht stimmt
Ein erneutes Deploy dauerte im Test 18 Sekunden. Der Wechsel selbst ist nur ein umgehängter Symlink, die letzten fünf Stände bleiben auf dem Server. Der Schlüssel dafür kann ausschließlich hochladen, aktivieren und zurückrollen. Andere Befehle lehnt der Server ab, das habe ich getestet.
Es gibt auch echte Nachteile, und die will ich nicht schönreden:
- Kein Schreiben mehr im Browser oder am Handy. Beiträge entstehen auf meinem Rechner.
- Keine Mediathek und keine automatische Bildoptimierung durch ein Plugin. Bilder laufen über Repository und Build.
- Geplante Beiträge erscheinen nicht von selbst, dafür bräuchte es einen eigenen Timer.
- Keine Yoast-Hinweise. Die Tags für Suchmaschinen erzeugt jetzt die Vorlage bei jedem Build, aber wenn eine Beschreibung fehlt, warnt mich niemand.
Was man mitnimmt: Ich tausche Komfort beim Schreiben gegen Einfachheit im Betrieb. Für einen Ein-Personen-Blog passt das, für eine Redaktion wäre es die falsche Entscheidung.
🚀 Leistung: alt gegen neu
Gemessen mit Chrome, jeweils Median aus sieben Läufen. Die alten Werte stammen vom Live-Blog, die neuen von der Testmaschine ohne Besucher und mit selbstsigniertem Zertifikat. Das ist also noch kein fairer Endvergleich.
| Messung | WordPress | Hugo |
|---|---|---|
| Handy, Beitrag: erste Inhalte sichtbar | 2,54 s | 0,71 s |
| Handy, Startseite: erste Inhalte sichtbar | 2,54 s | 0,59 s |
| Desktop, Beitrag: vollständig geladen | 451 ms | 140 ms |
| Beitrag: Anfragen | 42 | 13 |
| Beitrag: Datenmenge | 455 KB | 235 KB |
Direkt nach der Umstellung habe ich auf dem echten Server nachgemessen, mit echtem Zertifikat und von außen:
| Messung auf dem echten Server | WordPress | Hugo, HTTP/2 | Hugo, HTTP/3 |
|---|---|---|---|
| Handy, Beitrag: erste Inhalte sichtbar | 2,54 s | 0,80 s | 0,75 s |
| Handy, Startseite: erste Inhalte sichtbar | 2,54 s | 0,64 s | 0,58 s |
| Desktop, Beitrag: vollständig geladen | 451 ms | 386 ms | 315 ms |
| Desktop, Beitrag: Datenmenge | 455 KB | 178 KB | 178 KB |
Das Handy gewinnt deutlich, beim Desktop ist der Abstand kleiner als auf der Testmaschine. Das ist noch kein Dauerwert: Der Server war frisch und ohne normale Last.
Die erste Messung deckte noch einen Fehler in meinem neuen Theme auf: Der Slider lud fünf Bilder in voller Größe gleichzeitig, am Handy sogar, obwohl er dort ausgeblendet ist, und das eigentlich sichtbare Bild kam zuletzt. Nach der Korrektur erscheint das größte Element der Startseite am Handy nach 1,29 statt 2,25 Sekunden, die Datenmenge fiel dort von 545 auf 292 KB und am Desktop von 1,22 MB auf 606 KB. Die Tabelle oben zeigt den Stand danach.
Dazu der Blick von anderen Kontinenten: Gesamtzeit für denselben Beitrag über HTTP/2, Median aus je fünf Messstationen von Globalping, einmal abgerufen. Einen Vorher-Wert gibt es dafür nicht, ich habe unter WordPress nie so gemessen. Ob es dort schneller geworden ist, kann ich also nicht sagen.
| Region | Gesamtzeit |
|---|---|
| Europa | 0,26 s |
| Nordamerika | 0,56 s |
| Asien | 1,02 s |
| Südamerika | 1,06 s |
| Afrika | 1,15 s |
| Ozeanien | 1,72 s |
Der Server steht in Deutschland, und statische Dateien ändern nichts an der Entfernung. Mehr ginge hier nur mit einem CDN, das ich bewusst nicht nutze.
Was man mitnimmt: Der größte Gewinn kommt nicht von schnellerer Hardware, sondern davon, dass weniger Dateien und kein Programmlauf nötig sind.
🎢 HTTP/3: diese Woche aus, jetzt an
Vor wenigen Tagen schrieb ich in einem langen Beitrag, warum HTTP/3 bei mir aus bleibt: Nach einem nginx-Reload hält ein Worker wegen einer einzigen langen Verbindung noch die gemeinsamen UDP-Sockets, und etwa jede achte QUIC-Verbindung hängt. Der Upstream-Fix hieß quic_bpf, und ich hielt das Thema für erledigt, sogar mit einer gewissen Würde.
Dann kam der Umzug, und ohne Ingress-Controller konnte ich die nginx-Version zum ersten Mal frei wählen. Also noch ein Versuch, zur Sicherheit erst einmal mit der ruhigen, bewährten Version:
nginx mit quic_bpf | Hängende Verbindungen unter Reloads |
|---|---|
| 1.26 | keine Verbesserung |
| 1.30.6 | 40 von 1.000 |
| 1.31.8 (mainline) | 0 von 2.370 |
Der bewährte Weg war also der falsche. Die Lösung brauchte mainline, dazu die Capabilities CAP_BPF, CAP_PERFMON und CAP_NET_ADMIN für einen Dienst, den ich sonst nach Kräften einschränke, und ein eigenes SELinux-Modul, damit das BPF-Programm überhaupt laden darf. Dazu worker_shutdown_timeout 30s, damit ein alter Worker nicht ewig bleibt.
Zum Schluss wollte ich es mit echtem Chrome sehen. Ergebnis des ersten Laufs: 300 von 300 Seiten fehlgeschlagen, jede nach einem Sekundenbruchteil. Kurzer Schreck, dann die Erklärung: Für QUIC akzeptiert Chrome ein selbstsigniertes Zertifikat auch mit dem allgemeinen Ignorieren-Schalter nicht, der Fehler lag in meinem Testaufbau. Mit hinterlegtem Schlüssel-Hash kamen unter Dauerfeuer, also einem Reload alle fünf Sekunden plus offener Download-Verbindung, 298 von 300 Seiten über HTTP/3 an, im Median in 236 ms, die langsamste in 1,3 s. Ohne Reloads waren es 300 von 300. Gehangen hat in beiden Läufen keine Seite. Die zwei Abbrüche dürften also vom Reload kommen, und der ist im Alltag selten: Ein Deploy löst gar keinen aus.
Was man mitnimmt: Ein Befund ist eine Aussage über eine Version. „Geht nicht“ war diese Woche richtig und ist es jetzt nicht mehr. Und wenn ein Test zu 100 % scheitert, zuerst den Test prüfen.
🔧 Was der Test von null gefunden hat
Vor dem Plattmachen des echten Servers habe ich die Testmaschine frisch installieren lassen und das Playbook von null laufen lassen. Das hat sich sofort gelohnt, denn diese Fehler hätten mich sonst während der echten Umstellung erwischt:
- Der Neustart, der keiner war: Der erste Lauf startet den Server neu, damit SSH-Port und Firewall gemeinsam aktiv werden. Der Befehl lief mit
async: 1und begann mitsleep 2. Die aktuelle ansible-core 2.21 beendet den Job nach einer Sekunde und meldet trotzdemchanged. Das Playbook wartete fünf Minuten auf einen Port, der nie aufging. - Die leere PID-Datei: Die Prüfung
nginx -tlegt/run/nginx.pidleer an, wenn nginx noch nicht läuft, und zwar mit dem SELinux-Typvar_run_t. Danach darf der Dienst inhttpd_tdie Datei nicht öffnen und startet nicht. Das tritt bei jeder Erstinstallation auf. - fail2ban, das es noch nicht gab: Der Firewall-Handler startet fail2ban neu, auf einer frischen Maschine ist es zu diesem Zeitpunkt aber noch gar nicht installiert. Das fiel erst beim zweiten echten Lauf von null auf, vorher stand die Firewall schon und verdeckte es.
- Was WordPress nebenbei erledigte: Der Abgleich mit dem Live-Blog zeigte, dass
robots.txt, die alten Sitemap-Adressen undtwitter:cardfehlten. Das hatte alles Yoast mitgebracht. - Ausgesperrt von der eigenen Sicherheit: Die Domain steht auf der HSTS-Preload-Liste. Mein Firefox ließ mich die selbstsignierte Testseite deshalb nicht öffnen, auch nicht nach dem Löschen aller Daten. Die Regel ist fest im Browser eingebaut.
- Die rätselhaft langsame Testmaschine: Bei gleicher Ausstattung wie der Blog-Server lief sie zunächst um ein Vielfaches langsamer. Nach der nächsten Neuinstallation war der Unterschied weg, der Lauf von null dauerte rund 12 statt über 30 Minuten. Die Ursache kenne ich nicht, der Verdacht liegt beim Wirtsrechner. Das Playbook war es nicht, denn ich habe währenddessen minütlich mitgemessen.
Nach den Korrekturen zeigte der Prüflauf changed=0.
Was man mitnimmt: Ein Lauf auf einer vorhandenen Maschine beweist wenig. Der Lauf von null ist der eigentliche Test, und er muss vor dem Ernstfall stattfinden.
🚧 Was bei der echten Umstellung schiefging
Trotz aller Tests lief der Ernstfall nicht glatt, und das soll hier nicht fehlen. Der Blog war am 6. November von etwa 18:10 bis 19:52 Uhr nicht verfügbar, deutlich länger als die geplante halbe Stunde.
- Der fehlende Ordner: Auf der Testmaschine ließ sich Let’s Encrypt nicht prüfen, der Schritt lief also zum ersten Mal auf dem echten Server. Der Ordner für den Hook entsteht erst beim ersten
certbot-Lauf, das Playbook wollte vorher hineinschreiben und brach ab. Das war schnell behoben. Der Lauf von null wurde danach auf Port 10022 fortgesetzt und hat sofort ein gültiges Zertifikat geholt. - Selbst ausgesperrt: Ich wollte die alten SSH-Hostschlüssel behalten, damit andere Rechner den Server weiter erkennen. Sie hatten die Rechte
640mit der Gruppessh_keys, und die Gruppe ging beim Kopieren verloren.sshdlehnt solche Schlüssel ab und startete nicht mehr. Ich hatte ohnesshd -tneu gestartet, und damit war mein einziger Zugang weg. Die Rettung war einchmod 600über die Konsole des Anbieters. Auf der Testmaschine fiel das nicht auf, weil deren Schlüssel schon600hatten. - Leere Pressure-Grafik:
psi=1greift erst nach einem Neustart, und auf AlmaLinux 10 hat/proc/pressureden eigenen SELinux-Typproc_psi_t, den mein Modul fürnode_exporternicht kannte. - Kein Swap: Das hatte ich beim Umbau schlicht nicht bedacht. Ohne K3s spricht nichts mehr dagegen, jetzt gibt es eine kleine Swap-Datei.
Positiv: Alle 592 alten Adressen von Beiträgen und Seiten antworten unverändert, die Prüfsumme der Seite stimmt, und eine Sitemap-Falle fiel noch rechtzeitig auf: Sie enthielt Tag-Seiten mit noindex.
Was man mitnimmt: Ein Test beweist nur, was er auch berührt. Vor dem Neustart eines Dienstes, an dem der eigene Zugang hängt, gehört immer die Konfigurationsprüfung.
🛡️ Ist das unkritisch?
Die Angriffsfläche ist deutlich kleiner geworden. Es gibt kein PHP, keine Plugins, keine Datenbank und kein WordPress-Login mehr. Auf dem Server bleibt nur das Grafana-Login, geschützt durch Länderfilter, vorgeschaltete Anmeldung und fail2ban. Die regelmäßigen Sicherheitsupdates für WordPress, Plugins und den Cluster fallen weg. Verschwunden ist das Risiko aber nicht, es hat sich verlagert:
- GitHub-Konto: Es hält jetzt den gesamten Inhalt. Die WordPress-2FA ersetzt es nur, wenn es selbst gut geschützt ist.
- Build-Rechner: Wer ihn übernimmt, kann mit dem Deploy-Schlüssel die Seite ändern, aber nicht den Server.
- Zertifikat: Wegen HSTS-Preload kann kein Besucher eine Zertifikatswarnung wegklicken. Läuft die Verlängerung nicht, ist der Blog sofort nicht erreichbar. Das muss die Überwachung früh melden.
- HTTP/3 auf mainline: Ich fahre bewusst eine Entwicklungslinie mit erweiterten Rechten. Dafür lässt sich HTTP/3 mit einer einzigen Variable wieder abschalten.
- Der Umzug selbst: Ein Zurück gab es nur über die Vollsicherung. Deshalb habe ich sie vorher geprüft und die Zertifikate getrennt gesichert.
Was man mitnimmt: Statische Seiten sind nicht automatisch sicher. Das Risiko wandert vom Server zu Konten, Schlüsseln und Zertifikaten.
💾 Backup: weniger Daten, andere Fragen
Früher musste ich vor allem die Datenbank und die Medien sichern, sonst war der Blog weg. Jetzt ist die Webseite selbst eine Ableitung: Aus dem Inhalts-Repository lässt sie sich jederzeit neu bauen. Der Server ist es ebenfalls, denn ihn baut das Playbook. Wichtig bleibt, was sich nicht wiederherstellen lässt:
- Inhalts-Repository: Die eigentliche Quelle. Es liegt auf GitHub und zusätzlich im Homelab-Backup.
- Zertifikate: Damit ein Neuaufbau nicht vom nächsten erfolgreichen Abruf abhängt.
- SSH-Hostschlüssel: Sonst schlägt nach einem Restore jede Verbindung Alarm.
- Besucherstatistik: Die lässt sich aus nichts anderem neu erzeugen.
- Vault-Passwort: Ohne das nützt das Playbook beim Neuaufbau wenig, also getrennt aufbewahren.
Auch hier hat der Test sich gelohnt. Mein neues Backup hätte ohne rsync -H die per Hardlink verknüpften Stände vervielfacht, und rdiff-backup hätte auch abgebrochene Sicherungen versioniert, also Dateien als gelöscht verbucht. Beides ist behoben. Auf einer frisch installierten Testmaschine dauerte der Restore danach 16 Sekunden, die Prüfsumme über alle 18.837 Dateien stimmte mit dem Build überein, und die SSH-Hostschlüssel waren wieder die alten. Die alte WordPress-Sicherung samt Datenbank-Dump bleibt separat liegen.
Was man mitnimmt: Ein Backup zählt erst, wenn der Restore einmal echt gelaufen ist. Dass jetzt fast alles neu gebaut werden kann, macht ihn einfacher, aber nicht überflüssig.
🎯 Die Lehren
- Erst messen, dann glauben. Das gilt für „Hugo bringt Lesern wenig“ genauso wie für „HTTP/3 geht nicht“.
- Der Test von null findet, was jeder Lauf auf einer gewachsenen Maschine verdeckt.
- Ein Plugin wie Yoast erledigt mehr, als man merkt. Vor der Abschaltung gehört die Ausgabe Zeile für Zeile verglichen.
- Wer eine Komponente entfernt, muss auch ihre Ausnahmen entfernen: Firewall, Audit-Regeln, Alarme.
- Sicherheit verschiebt sich, sie verschwindet nicht. Nach dem Umbau zählt, wer den Schlüssel und das Konto hält.
- Vor dem Neustart von
sshdimmersshd -t, und einen zweiten Zugang bereithalten.
Wie sich das im Alltag und unter normaler Last bewährt, ergänze ich nach einigen Tagen Betrieb.