Deep Dive: Hugo – was ein Static Site Generator macht, was meine WordPress-Plugins ersetzt hat und wie Suche ohne Server funktioniert
Was Hugo ist und wie es sich von WordPress unterscheidet, wer die Aufgaben von Yoast, Polylang und den Cache-Plugins übernommen hat, wie ein Suchfeld auf einer Seite ohne Server funktioniert, wie ich einen Beitrag hinzufüge und Hugo aktualisiere – und welche Stolperfallen erst im Betrieb auftauchten.
🌐 Auch auf: English · Français · Español · Italiano · Português · Nederlands · Polski
Deep Dive aus der Reihe zur Ansible-Tour. Die Tour erklärt die Rollen, die Deep Dives die Technik darunter: wie sie funktioniert, warum sie hier so eingesetzt ist und was dabei schiefging.
Anfang November ist dieser Blog von WordPress auf Kubernetes zu Hugo umgezogen. Das Experiment mit echten Zahlen und der Umzug selbst sind an anderer Stelle erzählt. Dieser Beitrag ist der Überblick, den ich mir vor dem Start gewünscht hätte: was Hugo eigentlich ist, wer die Aufgaben der WordPress-Plugins übernommen hat, wie ein Suchfeld auf einer Seite ohne jeden serverseitigen Code funktioniert, was ich tue, wenn ich einen Beitrag hinzufüge oder Hugo aktualisiere, und wo es mich überrascht hat.
Inhaltsverzeichnis
🧭 Was Hugo ist
Eine Druckerpresse statt einer Küche
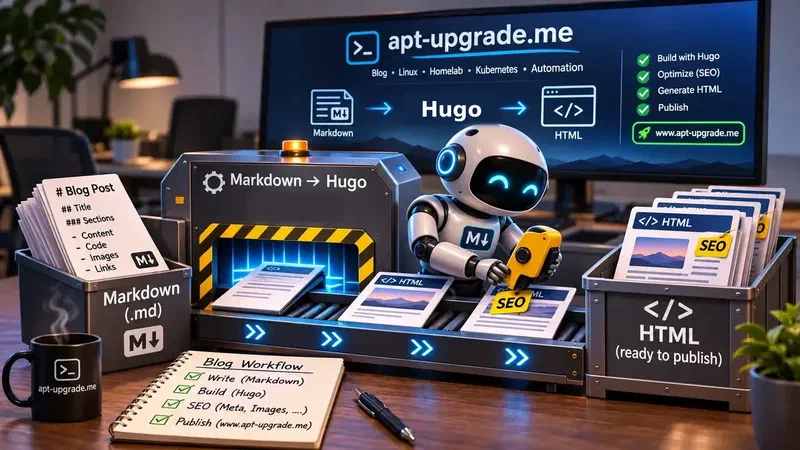
WordPress arbeitet wie eine Restaurantküche: Bei jeder Bestellung kocht PHP die Seite aus der Datenbank – außer ein Cache-Plugin hat schon einen Teller fertig. Hugo arbeitet wie eine Druckerpresse: Es druckt jede Seite einmal im Voraus, und der Webserver reicht nur noch fertige Exemplare heraus. Wenn ein Leser kommt, wird nichts gekocht.
Technisch ist Hugo ein Static Site Generator: ein einzelnes, in Go geschriebenes Programm, das Markdown-Dateien, Templates und Bilder liest und einen Ordner voller HTML, CSS, Bilder und Feeds schreibt. Dieser Ordner ist die Website. Jeder Webserver kann ihn ausliefern; hier ist es schlichtes nginx.
Ein Binary, zwei Editionen
Hugo ist eine einzige ausführbare Datei ohne Abhängigkeiten – kein PHP, keine Datenbank, kein Node.js. Es gibt eine Standard- und eine Extended-Edition; die Extended-Edition bringt zusätzlich WebP-Kodierung und Sass mit. Dieser Blog nutzt die Extended-Edition in Version 0.169.0, weil jedes Bild beim Build verkleinert und nach WebP umgewandelt wird.
Was man mitnimmt: Hugo verlagert die ganze Arbeit vom Moment des Besuchs auf den Moment des Veröffentlichens. Alles andere in diesem Beitrag folgt daraus.
⚖️ Hugo gegen WordPress
| Frage | WordPress | Hugo |
|---|---|---|
| Wann entsteht eine Seite? | Bei jedem Aufruf (oder aus einem Cache) | Einmal, beim Build |
| Was läuft auf dem Server? | PHP, MariaDB, oft Redis | Nur der Webserver |
| Angriffsfläche | Login, Admin, Plugins, XML-RPC, PHP | Statische Dateien |
| Regelmäßige Updates | Core, Plugins, Themes, PHP | nginx; Hugo nur auf dem Build-Rechner |
| Wo schreibe ich? | Editor im Browser | Texteditor, Git |
| Kommentare, Formulare | Eingebaut | Brauchen einen externen Dienst |
| Geschwindigkeit | Gecacht: 58 ms für die Startseite | 57 ms – kein Unterschied |
| Seitengewicht (Startseite, ohne Bilder) | 25 Dateien, 198 KB | 3 Dateien, 9,5 KB |
Die Zahlen stammen aus meinen eigenen Messungen vor dem Umzug. Geschwindigkeit war nicht der Grund: Ein gut gecachtes WordPress ist genauso schnell. Die Gründe waren der Rest der Tabelle – kein Login, den man angreifen kann, keine Plugin-Updates jede Woche, keine Datenbank, die gesichert werden muss, und eine Seite, die 95 % kleiner ist.
Was ich aufgegeben habe: den Editor im Browser, Kommentare und den Komfort, eine Funktion mit einem Klick zu installieren.
Was man mitnimmt: WordPress ist ein Programm, das eine Website erzeugt. Hugo erzeugt die Website einmal und tritt dann zur Seite. Ob das besser ist, hängt davon ab, ob du brauchst, was nur das laufende Programm kann.
🔧 Wie Hugo arbeitet
Inhalt: Markdown mit Front Matter
Jeder Beitrag ist eine Markdown-Datei. Oben steht das Front Matter, ein YAML-Block, den Hugo als Daten liest. Ein Beitrag auf diesem Blog beginnt so:
---
title: 'Zabbix in Containers Watches My Home Network'
slug: zabbix-in-containers-watches-my-home-network
date: '2026-11-13T15:40:00+01:00'
translationKey: zabbix-heimnetz-2026-11
description: 'Short summary for search results, at most about 155 characters.'
categories:
- linux
tags:
- zabbix
image: uploads/2026/11/zabbix-watchman.webp
imageAlt: What the picture shows, for screen readers and search engines
---
Unter dem zweiten --- folgt der Text. Markdown deckt Überschriften, Listen, Tabellen und Code ab; wo es nicht reicht, ist rohes HTML erlaubt (unsafe = true in den Goldmark-Einstellungen), was für die aus WordPress konvertierten Beiträge wichtig ist.
Ordner, Sections und Adressen
site/
├── content/en/posts/   posts in English (one folder per language)
├── content/de/posts/   posts in German, and so on for eight languages
├── layouts/            templates: the theme
├── assets/             CSS and JavaScript, processed by Hugo
├── uploads/            images and downloads
├── i18n/               interface words per language ("Read more", "Search")
├── data/               menus, flags, footer text as JSON
└── hugo.toml           configuration
hugo.toml legt die Adressen fest: posts = "/:year/:month/:day/:slug/" behält das URL-Schema bei, das WordPress verwendet hat, damit kein alter Link kaputtging. Kategorien und Tags sind Taxonomien; Hugo baut für jede Kategorie und jeden Tag von selbst eine Seite.
Templates
Die Templates nutzen die Template-Sprache von Go. baseof.html ist der Rahmen jeder Seite, page.html ein einzelner Beitrag, home.html die Startseite, und Partials sind wiederverwendbare Bausteine – der Header, die Sidebar, der <head> mit allen Meta-Tags. Ich nutze kein fertiges Theme: Die Layouts wurden so geschrieben, dass sie wie das alte WordPress-Theme aussehen.
Die Asset-Pipeline
Hugo verarbeitet Dateien selbst: resources.Get "css/main.css" | minify | fingerprint minifiziert das Stylesheet und schreibt einen Hash in seinen Dateinamen, sodass Browser es für immer cachen können. Bilder werden beim Build verkleinert – das Vorschaubild für soziale Medien zum Beispiel entsteht aus dem Beitragsbild mit 1200 px und wird so lange verkleinert, bis es unter 280 KB bleibt, der Grenze für WhatsApp-Vorschauen.
Mehrsprachig von Anfang an
Jede Sprache hat in hugo.toml ihren eigenen Content-Ordner, ihr Label und ihre Locale. Beiträge, die zusammengehören, teilen sich einen translationKey; daraus kennt Hugo die Übersetzungen jeder Seite und baut den Sprachumschalter und die hreflang-Links. Dieser Blog hat inzwischen acht Sprachen – Englisch, Deutsch, Französisch, Spanisch, Italienisch, Portugiesisch, Niederländisch und Polnisch.
Vorschau und Entwürfe
hugo server baut die Seite in den Arbeitsspeicher und liefert sie auf localhost:1313 aus; jede gespeicherte Datei lädt den Browser neu. draft: true hält einen Beitrag aus dem echten Build heraus, und ein Datum in der Zukunft tut das ebenfalls – dazu weiter unten mehr.
Was man mitnimmt: Inhalt, Templates und Konfiguration sind drei getrennte Arten von Dateien. Du kannst das Aussehen ändern, ohne einen einzigen Beitrag anzufassen, und einen Beitrag schreiben, ohne zu wissen, wie die Templates funktionieren.
🧩 Wo die Plugins geblieben sind
Unter WordPress war fast jede Funktion ein Plugin. Unter Hugo ist eine Funktion entweder eingebaut, ein paar Zeilen Template oder ein kleines Skript, das nach dem Build läuft.
| WordPress-Plugin | Aufgabe | Jetzt |
|---|---|---|
| Yoast SEO | Titel, Beschreibung, Canonical, Open Graph, strukturierte Daten | head.html (ein Template für alle Seiten) |
| Yoast SEO | Sitemap | In Hugo eingebaut, eigenes sitemap.xml-Template mit hreflang |
| Yoast SEO | „Dein Beitrag hat keine Beschreibung“ | check_posts.py: der Build bricht ab |
| Polylang | Sprachen, Sprachumschalter | In Hugo eingebaut |
| CompressX | WebP-Bilder, kleinere Größen | Bildverarbeitung von Hugo |
| Autoptimize | CSS, JS, HTML minifizieren | hugo --minify |
| WP Super Cache, Redis | Seiten- und Objekt-Cache | Nicht nötig – jede Seite ist schon eine Datei |
| Suche (WordPress) | Volltextsuche | Pagefind (nächster Abschnitt) |
SEO ohne Plugin
Yoast hat drei Dinge getan: Es hat Meta-Tags geschrieben, eine Sitemap gebaut und genörgelt. Die ersten beiden sind jetzt ein Partial, head.html. Für jede Seite schreibt es den Titel (oder einen kürzeren seoTitle aus dem Front Matter), die Beschreibung, einen Canonical-Link, einen hreflang-Link pro Übersetzung, die Open-Graph- und Twitter-Tags mit einem erzeugten Vorschaubild, die Artikeldaten und einen JSON-LD-Block mit denselben strukturierten Daten, die Yoast erzeugt hat (Article, WebPage, BreadcrumbList, Person). Es ist eine Datei, und sie ist für jede Seite gleich – keine Einstellungsseite pro Beitrag.
Das Nörgeln ist in den Build gewandert: tools/check_posts.py bricht den Build ab, wenn einem Beitrag Titel, Beschreibung, Bild, Bildtext, Translation Key oder Datum fehlen oder wenn die Bilddatei nicht existiert, und es warnt, wenn eine Beschreibung zu lang wird oder eine Übersetzung fehlt.
Erweiterungen in Hugo
Hugo hat keinen Plugin-Store, aber Erweiterungspunkte:
- Themes und Hugo Modules – komplette Looks oder Teile davon, eingebunden wie eine Abhängigkeit. Dieser Blog bindet seine eigenen Ordner über
module.mountsein (der Upload-Ordner ist zweimal eingehängt: einmal für die Bildverarbeitung, einmal als/wp-content/uploads/, damit die alten Bildadressen weiter funktionieren). - Shortcodes – kleine Templates, die du aus Markdown aufrufst, z. B. für ein Video oder einen Hinweiskasten.
- Render Hooks – ein eigenes Template für jeden Link, jedes Bild oder jede Überschrift, die Markdown erzeugt.
- Output Formats – derselbe Inhalt als HTML, RSS, JSON oder was auch immer.
- Werkzeuge nach dem Build – der Build ist nur ein Ordner, also kann jedes Programm daran weiterarbeiten. Hier ergänzt
imgattrs.pydie Bilder in alten Beiträgen umsrcsetund Lazy Loading, und Pagefind baut den Suchindex.
Was man mitnimmt: Die meisten Plugins haben Probleme gelöst, die eine statische Seite gar nicht hat. Der Rest wurde ein Template oder ein Skript, das ich vollständig lesen kann – was auch heißt, dass niemand anders sie für mich aktualisiert.
🔍 Wie Suche ohne Server funktioniert
Ein Suchfeld scheint einen Server zu brauchen: Irgendwer muss die Wörter nachschlagen. Pagefind verlagert auch diese Arbeit in den Build.
- Beim Build liest Pagefind jede fertige HTML-Seite. Es indiziert nur den Teil, der mit
data-pagefind-bodymarkiert ist (den Artikel), damit Menüs und Sidebars die Ergebnisse nicht verschmutzen, und überspringt alles, was mitdata-pagefind-ignoremarkiert ist. Die Sprache erkennt es amlang-Attribut und baut einen Index pro Sprache. - Der Index ist in viele kleine Dateien aufgeteilt unter
/pagefind/– insgesamt 18 MB für acht Sprachen. Niemand lädt alles herunter. - Im Browser wird nichts geladen, bis jemand tatsächlich sucht. Dann importieren ein paar Zeilen JavaScript Pagefind, das nur die Indexteile für die eingetippten Wörter und die Fragmente der passenden Seiten holt und Titel und Auszug anzeigt.
import('/pagefind/pagefind.js')
  .then(function (m) { return m.search(term); })
  .then(function (r) { return Promise.all(r.results.slice(0, 8).map(function (x) { return x.data(); })); })
Ein Nebeneffekt, den ich mag: Der Suchbegriff erreicht den Server nie als Query-String und landet damit auch in keinem Access-Log. Für Browser ohne JavaScript ist das Formular absichtlich ausgeblendet – ein normales Absenden des Formulars hätte den Begriff in die URL geschrieben.
Was man mitnimmt: „Statisch“ heißt nicht „keine Interaktion“. Es heißt, dass die Interaktion im Browser des Lesers stattfindet, mit Daten, die vorher vorbereitet wurden.
✍️ Mein Ablauf für einen neuen Beitrag
- Schreiben: die Markdown-Datei in
site/content/en/posts/<slug>.mdmit dem Front Matter von oben. Die Übersetzungen bekommen denselben Dateinamen, denselbentranslationKeyund Tags mit Sprachsuffix (hugo-de,hugo-fr, …). - Bild hinzufügen in
site/uploads/YYYY/MM/– WebP, höchstens 1536 px breit, unter 280 KB. Im Text werden Bilder als/wp-content/uploads/YYYY/MM/name.webpreferenziert, die Adresse, die WordPress verwendet hat. - Bauen:
tools/build.sh
Das Skript ruft check_posts.py auf, dann hugo --gc --minify, dann imgattrs.py, dann Pagefind. Hugo selbst braucht für die ganze Seite etwa zehn Sekunden.
- Veröffentlichen:
tools/deploy.sh <host> 10022
rsync lädt den Build in einen incoming/-Ordner hoch; der Server kopiert ihn dann in einen neuen Release-Ordner und schwenkt in einem Schritt einen Symlink darauf um. Die letzten fünf Releases bleiben erhalten, sodass tools/deploy.sh <host> 10022 rollback in einer Sekunde zurückgeht. Der Deploy-Schlüssel kann sonst nichts – der Server akzeptiert für ihn nur genau diese Befehle.
- Committen und pushen des Content-Repositorys.
Zwei Repositorys: offener Code, privater Inhalt
Der Server und die Build-Werkzeuge liegen in einem öffentlichen Repository, www_hugo, neben dem Ansible-Code für alles andere. Der Inhalt – Beiträge, Bilder, Templates, Entwürfe – liegt in einem privaten. Der Grund: Ein Repository merkt sich alles. Ein Bild, das ich offline nehme, bliebe für immer in der Historie eines öffentlichen Repos, und Entwürfe sind nicht für Leser gedacht. Der Server bekommt nur fertige Dateien über den Deploy-Schritt und sieht nie einen Entwurf; das öffentliche Repo sieht die Inhalte überhaupt nicht.
Was man mitnimmt: Veröffentlichen sind zwei unabhängige Schritte. Der Server zeigt, was zuletzt deployt wurde, Git behält, was zuletzt committet wurde – ich mache beides, in dieser Reihenfolge.
⬆️ Hugo aktualisieren
Hugo ist auf dem Server überhaupt nicht installiert. Es liegt als einzelnes Binary in .tools/ auf dem Rechner, der die Seite baut, zusammen mit Pagefind. Die Versionen sind in versions.yml des öffentlichen Repos gepinnt:
hugo_version:                "0.169.0"   # github.com/gohugoio/hugo/releases
pagefind_version:            "1.6.0"     # github.com/Pagefind/pagefind/releases
Ein Update folgt demselben Muster wie überall sonst hier:
- Die Release Notes lesen – Hugo erklärt ab und zu Template-Funktionen für veraltet und warnt davor in der Build-Ausgabe lange bevor es sie entfernt.
- Das Extended-Release für Linux herunterladen, seinen SHA-256 mit der Checksummen-Datei des Releases vergleichen,
.tools/hugoersetzen. - In einen separaten Ordner bauen und mit dem vorherigen Build vergleichen (
diff -r). Es sollten nur erwartete Unterschiede auftauchen. - Den Pin in
versions.ymländern, deployen, committen.
Weil der Server nur Dateien ausliefert, kann ein Hugo-Update die laufende Seite nie kaputtmachen. Der schlimmste Fall ist ein Build, der fehlschlägt oder anders aussieht – und das passiert auf meinem Rechner, nicht vor den Lesern.
Was man mitnimmt: Der Generator ist ein Build-Werkzeug, wie ein Compiler. Pinne ihn, aktualisiere ihn bewusst und vergleiche die Ausgabe.
🤖 Was Claude rund um Hugo macht
Den Großteil der Arbeit an diesem Blog erledige ich zusammen mit Claude (der KI von Anthropic) im Terminal. Nach Themen aufgeschlüsselt:
- Migration: Export aus WordPress, Umwandlung jedes Beitrags in Markdown mit Front Matter, alte Adressen und Bildpfade beibehalten, Weiterleitungen für geänderte Slugs.
- Templates und Aussehen: Nachbau des alten Themes in Hugo-Templates, der Slider, die Sidebar, die dunklen Ecken wie die Datumsarchivseiten.
- SEO: das Partial
head.html, die Sitemap mithreflang, strukturierte Daten, Vorschaubilder unter der WhatsApp-Grenze. - Schreiben und Übersetzen: Entwürfe in meinen Worten, Übersetzungen in alle acht Sprachen mit festen Regeln (Codeblöcke byte-identisch, Links pro Sprache umgeschrieben) und ein Prüfskript, das jede Übersetzung mit dem englischen Original vergleicht.
- Prüfungen: die Build-Prüfung, ein Linkcheck über alle erzeugten Seiten, ein Live-Check gegen die laufende Seite.
- Server und Deploy: die Ansible-Rolle für nginx, das atomare Deploy, SELinux, Monitoring.
- Fehlersuche: herausfinden, warum ein Beitrag nicht erschien (siehe nächster Abschnitt) oder warum eine Breadcrumb auf eine fehlende Seite zeigte.
Was bei mir bleibt: entscheiden, was geschrieben und veröffentlicht wird, jeden Entwurf lesen, die Playbooks laufen lassen, und jeder Push und jedes Deploy – Claude fragt vor jedem einzelnen.
Was man mitnimmt: Eine statische Seite besteht aus Textdateien und kleinen Skripten – genau das Material, mit dem ein KI-Assistent gut umgehen kann. Die Entscheidungen bleiben meine.
🐛 Stolperfallen, die erst im Betrieb auftauchten
- Ein Beitrag aus der Zukunft wird nicht gebaut. Ich habe das Datum eines Beitrags auf 15:50 gesetzt und um 15:44 gebaut – Hugo hat ihn stillschweigend weggelassen. Kein Fehler, der Beitrag fehlte einfach.
datemuss in der Vergangenheit liegen, oder der Build braucht--buildFuture. - Eine fehlende Tagesseite. Die Breadcrumb eines neuen Beitrags verlinkte auf sein Tagesarchiv (
/2026/11/13/), das nicht existierte, weil die Datumsseiten Content-Dateien sind, keine erzeugten. Der Linkcheck hat es gefunden; jetzt braucht ein neues Datum seine_index.md. Und beim Schreiben genau dieses Beitrags sind beide Fehler wieder passiert: Der Beitrag war auf 08:30 datiert und wurde um 08:22 gebaut, und seine neue Tagesseite trug 12:00 – eine Seite, die auf Mittag datiert ist, liegt den ganzen Vormittag in der Zukunft. - Konvertiertes HTML ist zerbrechlich. Aus WordPress importierte Beiträge sind eine Mischung aus Markdown und rohem HTML. In einigen davon klebten Wörter zusammen, oder ein verirrtes
**hatte überlebt. Erst eine Prüfung der gerenderten Seiten über alle Sprachen hat sie gefunden. - Typografie-Einstellungen zählen. Hugos Typographer macht aus
--standardmäßig einen Gedankenstrich. WordPress hat das nicht getan, also wären Befehle wie--checkin alten Beiträgen zu–checkgeworden. Die Einstellung betrifft jetzt nur noch Anführungszeichen und Apostrophe. - Nicht alles gehört in Suche und Feeds. Impressum und Datenschutzerklärung enthalten die Postadresse. Sie sind
noindex, bleiben aus den RSS-Feeds und aus dem Pagefind-Index heraus – ein Plugin hätte dafür jeweils eine Einstellung gebraucht, hier ist es eine Bedingung in den Templates. - Manche Adressen kommen aus dem Front Matter. Ein paar alte Beiträge tragen einen
url:-Schlüssel mit dem vollständigen Pfad. In Übersetzungen braucht er das Sprachpräfix, sonst beanspruchen alle Sprachen dieselbe Adresse.
Was man mitnimmt: Hugo tut genau, was man ihm sagt, und beschwert sich selten. Die Prüfungen, die WordPress-Plugins früher still erledigt haben, müssen aufgeschrieben werden – und dann laufen sie bei jedem Build.
📊 Gemessen
| Beiträge | 146, in 8 Sprachen |
| Erzeugte HTML-Seiten | etwa 23.000 (Beiträge, Tags, Kategorien, Archive) |
| Hugo-Build | etwa 10 s (ganze Seite) |
| Ausgabeordner | 498 MB, fast alles Bilder |
| Suchindex | 18 MB für 8 Sprachen, in kleinen Stücken geladen |
| Software auf dem Server für den Blog | nginx |
🎯 Die Lehren
- Entscheide, wo die Arbeit passiert: beim Besuch (WordPress) oder beim Veröffentlichen (Hugo).
- Prüfe, was ein Plugin wirklich getan hat, bevor du es ersetzt – das meiste ist ein Template, manches eine Prüfung, die du selbst schreiben musst.
- Suche, Feeds und Sitemaps funktionieren ohne Server, wenn der Build die Daten vorbereitet.
- Pinne den Generator wie jedes andere Build-Werkzeug und vergleiche die Ausgabe vor dem Deploy.
- Ein fehlender Beitrag ohne Fehlermeldung ist meistens ein Datum in der Zukunft.
- Halte Inhalt und Code getrennt, wenn der Code öffentlich ist.