
Acht Stunden für ein Backup: wie eine SMR-Platte, rdiff-backup und Hugo sich gegenseitig ausbremsten
Mein Backup-PC lief zuletzt über acht Stunden, obwohl sich kaum Daten geändert hatten. Die Spur führte zu einer Festplatte mit Dachziegeln, einem Werkzeug, das jede Datei einzeln festschreibt, und einem Blog, der bei jedem Build 70.000 Dateien neu schreibt.
🌐 Auch auf: English · Français · Español · Italiano · Português · Nederlands · Polski
Kurz gesagt: Mein Backup-PC brauchte zuletzt acht Stunden und 18 Minuten für einen Lauf – bei Datenmengen, die sich kaum geändert hatten. Die Ursache war keine einzelne, sondern drei, die sich gegenseitig verstärkten: eine SMR-Festplatte, die bei vielen kleinen Schreibvorgängen einbricht, rdiff-backup, das jede Datei einzeln auf die Platte zwingt, und mein Hugo-Blog, der bei jedem Build alle rund 70.000 Dateien neu schreibt. Jetzt sichere ich den Blog als ein einziges tar.gz-Archiv (38 Sekunden statt bis zu vier Stunden), rdiff-backup läuft mit --no-fsync, und Dinge, die sich neu erzeugen lassen, bleiben draußen.
Inhaltsverzeichnis
🐢 Das Symptom: acht Stunden für fast nichts
Mein Backup-PC ist ein alter Rechner, den ich einschalte, wenn gesichert werden soll: Er holt alles ab und fährt sich danach selbst wieder herunter. Er sichert vier Dinge nacheinander: Nextcloud, den Blog, die Freigaben vom NAS und mein Home-Verzeichnis auf dem Arbeitsrechner. Werkzeug für alles: rdiff-backup. Es hält einen aktuellen Spiegel und legt für jede geänderte Datei eine „Increment“-Datei mit dem alten Stand daneben – so kommt man an jede frühere Version.
Lange ging das schnell. Dann sah die Statistik so aus:
| Lauf | Nextcloud | Blog | NAS | Home | Gesamt |
|---|---|---|---|---|---|
| 12.11. | 15 min | 0 min | 1 min | 39 min | 56 min |
| 17.11. | 55 min | 169 min | 6 min | 167 min | 6 h 37 min |
| 19.11. | 4 min | 110 min | 186 min | 198 min | 8 h 18 min |
Gleiche Daten, gleiche Hardware, mal eine knappe Stunde, mal über acht. Mehr Speicherplatz hatte keiner der Läufe gebraucht. Es lag also nicht an der Menge, sondern an etwas anderem.
🏠 Erkenntnis 1: Die Festplatte hat ein Schindeldach
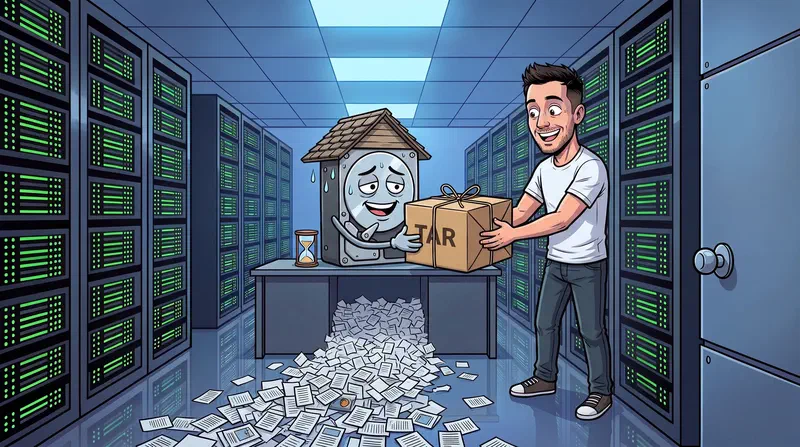
Erster Blick auf die Hardware: Die Backup-Platte ist eine Seagate Barracuda mit 8 TB. Das Modell arbeitet mit SMR (Shingled Magnetic Recording): Die Spuren überlappen sich wie Dachziegel. Das bringt mehr Daten auf die Scheibe, hat aber einen Haken. Wer eine Spur ändern will, überschreibt die halb darüberliegende Nachbarspur mit – die Platte muss deshalb ganze Bereiche (Bänder) lesen und neu schreiben.
Damit man das im Alltag nicht merkt, hat die Platte einen kleinen, normal beschriebenen Pufferbereich. Neue Daten landen erst dort, und die Platte sortiert sie in Ruhephasen in die Schindelbänder um. Große Dateien am Stück sind kein Problem. Viele kleine Schreibvorgänge dagegen füllen den Puffer schnell – und dann bricht die Schreibleistung von über 100 MB/s auf einen Bruchteil ein, weil die Platte gleichzeitig annimmt und umsortiert.
Bei einer Platte für Filme oder Fotos merkt man das nie. Bei einem Backup aus hunderttausenden kleiner Dateien merkt man es sehr deutlich.
💾 Erkenntnis 2: rdiff-backup schreibt jede Datei einzeln fest
Zweiter Blick: wie rdiff-backup schreibt. Für jede Datei, die es anlegt oder ersetzt, ruft es fsync auf – das zwingt das Betriebssystem, die Datei sofort physisch auf die Platte zu schreiben, statt sie im Arbeitsspeicher zu sammeln. Das ist gut gemeint: Stürzt der Rechner mitten im Lauf ab, ist jede bereits gesicherte Datei wirklich auf der Platte.
Auf einer SMR-Platte ist das allerdings der schlimmste Fall: Jede Datei ist ein einzelner, kleiner, synchroner Schreibvorgang. Ich habe in den Läufen Werte um 10 bis 15 Dateien pro Sekunde gemessen. Bei ein paar hundert geänderten Dateien egal. Bei 200.000 sind das vier Stunden.
🔁 Erkenntnis 3: Hugo schreibt bei jedem Build alles neu
Und wo kommen 200.000 geänderte Dateien her, wenn ich nur einen Beitrag ändere? Vom Wechsel auf Hugo. Mein Blog ist seitdem eine Sammlung statischer Dateien: rund 150 Beiträge in 8 Sprachen, dazu Schlagwortseiten, Kategorien, Seitennummerierung, Feeds, Suchindex und Bilder in mehreren Größen – zusammen etwa 70.000 Dateien.
Hugo baut bei jedem Deploy die ganze Seite neu und legt sie komplett neu ab, auch die Seiten, die sich gar nicht geändert haben. Für rdiff-backup ist damit nach jedem Deploy fast jede Datei geändert: neue Spiegelkopie plus eine Increment-Datei mit dem alten Stand. Je nachdem, wie viele Deploys seit dem letzten Lauf lagen, waren das 59.000 bis 214.000 neue Dateien pro Lauf. Mit 10 bis 15 Dateien pro Sekunde: 110 bis 234 Minuten nur für den Blog.
Unter WordPress war das kein Problem – da lag alles in einer Datenbank, und die Sicherung war ein einziger Dump.
🧩 Dasselbe Muster an zwei weiteren Stellen
Als das Prinzip klar war, fiel es auch woanders auf:
- NAS (186 Minuten am 19.11.): Am Vortag hatte ich meine Ablage aufgeräumt und viele Ordner verschoben. Für rdiff-backup ist eine verschobene Datei eine gelöschte plus eine neue – also zwei Schreibvorgänge pro Datei. Ein einmaliger Effekt; am 20.11. waren es wieder 54 Sekunden.
- Home-Verzeichnis (bis zu 198 Minuten): Von rund 420.000 Dateien sind etwa 360.000 Dinge, die sich jederzeit neu erzeugen lassen: Container-Images, Caches, Python-Umgebungen,
node_modules, die gebaute Website, Arbeitsdateien vom CD-Rippen. Die ändern sich ständig und sind im Ernstfall wertlos.
🛠️ Was ich geändert habe
1. Der Blog wird als ein Archiv gesichert. Statt 70.000 Einzeldateien mit rdiff-backup zu spiegeln, packt der Quellrechner den Stand per tar zusammen, komprimiert ihn mit gzip -1 und schickt ihn als einen Datenstrom auf den Backup-PC. Dort landet genau eine Datei. Das ist für jede Festplatte der Idealfall, für eine SMR-Platte ganz besonders.
ssh quelle "tar -C /storage --numeric-owner -cf - blog | gzip -1" > blog_2026-11-20_0814.tar.gz.part
tar -tzf blog_2026-11-20_0814.tar.gz.part | wc -l   # prüfen, erst dann umbenennen
Das Skript prüft vorher, ob die letzte Sicherung auf dem Quellrechner erfolgreich war, und danach, ob das Archiv lesbar ist und die Startseite enthält. Erst dann bekommt es seinen endgültigen Namen. gzip -1 reicht: Die Bilder sind schon komprimiert, eine höhere Stufe kostet nur Zeit.
Aufbewahrung: alle Archive der letzten 30 Tage, dazu das erste Archiv jedes Monats für ein Jahr. Das ist weniger fein als die Versionsgeschichte von rdiff-backup, aber für einen Blog, dessen Quelltext ohnehin in Git liegt, mehr als genug. Die alte rdiff-Historie bleibt für die Zeit davor liegen.
2. rdiff-backup ohne fsync für jede Datei. Für Nextcloud, NAS und Home läuft rdiff-backup jetzt mit --no-fsync. Ganz am Ende des Gesamtlaufs steht ein einziges sync, das alles auf die Platte schreibt. Das Risiko ist überschaubar: Stürzt der Backup-PC mitten im Lauf ab, ist dieser eine Lauf unvollständig – das passiert aber auch mit fsync, und rdiff-backup räumt einen abgebrochenen Lauf beim nächsten Start selbst auf (regress).
3. Was sich neu erzeugen lässt, bleibt draußen. Für das Home-Verzeichnis gibt es jetzt eine Ausschlussliste: Container-Speicher, .cache, .venvs, node_modules, .npm, die gebaute Website und Arbeitsordner. Alles davon lässt sich mit einem Befehl wiederherstellen.
📊 Das Ergebnis
Der erste Lauf mit allen Änderungen am 20.11.:
| Schritt | vorher (19.11.) | nachher (20.11.) |
|---|---|---|
| Nextcloud (810.000 Dateien) | 4 min 26 s | 2 min 29 s |
| Blog | 110 min | 38 s (ein Archiv, 888 MB, 113.002 Einträge) |
| NAS | 186 min | 54 s |
| Home | 198 min | 101 min 22 s |
| Gesamt | 8 h 18 min | 1 h 45 min |
Beim Home-Verzeichnis ist der erste Lauf ein Sonderfall: Die frisch ausgeschlossenen Dateien trägt rdiff-backup einmalig als „gelöscht“ ein – das sind ein letztes Mal hunderttausende Increment-Dateien. Ab dem nächsten Lauf fallen sie ganz weg.
💡 Hätte eine SSD das auch gelöst?
Die Frage habe ich mir auch gestellt. Eine SSD (oder eine Festplatte mit klassischem CMR) wäre bei vielen kleinen Dateien deutlich schneller, keine Frage. Aber sie hätte nur das Symptom gelindert: 200.000 Increment-Dateien pro Lauf für eine Website, die sich jederzeit aus Git neu bauen lässt, sind auch auf einer SSD Verschwendung. Erst die Zahl der Dateien senken, dann über Hardware nachdenken. Der Wechsel auf eine CMR-Platte oder auf Borg, das kleine Dateien in große Blöcke packt, bleibt als Option für später.
🤝 Wie die Analyse lief
Die Fehlersuche habe ich mit Claude Code gemacht: Ich habe nur gesagt „das Backup dauert acht Stunden, schau mal, ob du etwas optimieren kannst“ und ein paar Ideen dazugeschrieben (gepacktes Archiv, mehr im RAM puffern, rdiff-backup ersetzen, die Platte prüfen). Claude hat die Laufzeiten aus den Logs der letzten Wochen ausgewertet, das Plattenmodell als SMR erkannt, die Increment-Dateien pro Lauf gezählt und die Verbindung zum Hugo-Build hergestellt. Die Skripte hat es geschrieben; auf mein „wir machen das neu“ hat es den laufenden Backup-Lauf abgebrochen und mit der neuen Fassung neu gestartet.
🎯 Fazit: Nicht die Menge, die Anzahl
- Backup-Zeit hängt an der Zahl der Dateien, nicht an den Gigabytes. 888 MB am Stück: 38 Sekunden. Dieselben Daten als 200.000 Einzeldateien: vier Stunden.
- SMR-Platten sind für Backups aus vielen kleinen Dateien eine schlechte Wahl. Vor dem Kauf ins Datenblatt schauen – das Wort „SMR“ steht oft nur im Kleingedruckten.
- Statische Websites sichert man als Archiv, nicht Datei für Datei. Der Quelltext liegt ohnehin in Git.
- Was sich neu erzeugen lässt, gehört nicht ins Backup. Caches und Container-Images kosten Zeit und helfen im Ernstfall nicht.
- Erst messen, dann kaufen. Eine neue Platte hätte das Problem nur kleiner gemacht.
📚 Verwandte Beiträge: