Ce blog tourne désormais sur Hugo : sans WordPress, sans Kubernetes et avec un HTTP/3 stable
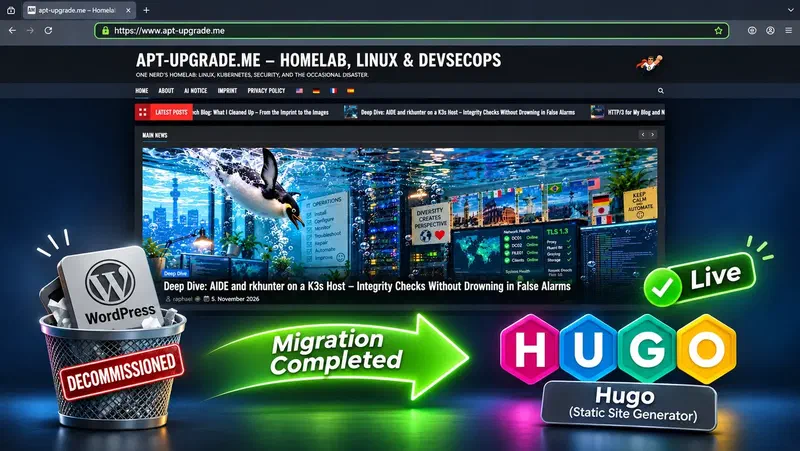
Ce blog ne tourne plus sur WordPress et K3s, mais en site statique sur AlmaLinux 10. Ce qui a changé, ce qui a mal tourné en test et pourquoi HTTP/3 est de retour.
🌐 Aussi en: English · Deutsch · Español
En bref : ce blog ne tourne plus sur WordPress et Kubernetes. Il se compose désormais de fichiers finis que nginx sert depuis un AlmaLinux 10 durci. Dans l’expérience Hugo d’il y a quelques jours, rien n’était encore décidé ; le 6 novembre 2026, j’ai fait la bascule. Tous les articles en quatre langues gardent leurs anciennes adresses, Grafana et le durcissement sont restés, PHP, la base de données et le cluster ont disparu. Et HTTP/3, que j’avais désactivé cette semaine encore, fonctionne de nouveau.
Cet article décrit ce qui a changé, ce qui a mal tourné pendant les tests, l’évolution des performances et ce que la bascule implique pour mon quotidien et mes sauvegardes.
Table des matières
🧒 Pour les non-informaticiens : qu’est-ce qui change ?
Jusqu’ici, un programme assemblait chaque page à partir d’une base de données dès qu’on la demandait, et un cache conservait le résultat un moment. Désormais, je construis toutes les pages une fois à l’avance sur mon propre ordinateur et je les envoie toutes prêtes. Le serveur ne fait plus que distribuer des fichiers. Aucun programme ne tourne pour les visiteurs, il n’y a pas de connexion, et rien qu’un attaquant puisse exécuter avec une requête manipulée.
À retenir : Le site a le même aspect. Ce qui a changé, c’est ce qui tourne derrière, et c’est bien moins qu’avant.
🔄 Ce qui a changé
| Avant | Maintenant | |
|---|---|---|
| Système d’exploitation | AlmaLinux 9 avec K3s | AlmaLinux 10 sans Kubernetes |
| Serveur web | ingress-nginx dans le cluster | nginx mainline 1.31.8 directement sur l’hôte |
| Contenu | MariaDB et dossier de médias | Fichiers dans un dépôt Git privé |
| Exécution pour les visiteurs | PHP-FPM, Redis, cache de pages | aucune |
| Connexion | Admin WordPress avec 2FA | Grafana uniquement, publication par clé SSH |
| Recherche | WordPress | Pagefind, dans le navigateur |
| HTTP/3 | désactivé | activé |
| Supervision | Prometheus, Grafana, Loki, Monit | inchangée, sans les métriques du cluster |
J’ai aussi réorganisé le pare-feu. Le routage est entièrement coupé, car sans réseau de pods l’hôte n’a plus rien à router, et rp_filter est de nouveau strict. Tout ce qui n’existait que pour K3s a disparu : chaînes NodePort, exceptions pour les pods, règles d’audit du cluster. fail2ban n’a plus de règle pour la connexion WordPress ; les requêtes vers /wp-login.php comptent désormais comme une tentative d’attaque. nginx ne peut plus ouvrir de connexion sortante, sauf vers Grafana sur la boucle locale.
À retenir : Une refonte est l’occasion rare de vraiment supprimer des règles. Beaucoup n’étaient encore là que parce qu’elles avaient été nécessaires un jour.
📦 La nouvelle structure des dépôts
Un dépôt en est devenu trois :
www_hugo(public) : Ansible pour le serveur du blog. Une seule ligneansible-playbookreconstruit la machine à partir de rien.www_hugo_content(privé) : articles, images, thème, scripts de build et de déploiement.nextcloud_k3s(public) : la partie Nextcloud continue là, sans changement, sur K3s.www_k3s: l’ancien dépôt est archivé et reste disponible pour référence.
Le contenu est privé parce que Git n’oublie rien. Une image que je retirerais plus tard pour des raisons juridiques ou personnelles resterait à jamais accessible dans l’historique d’un dépôt public.
Dans l’article sur l’expérience, je mettais en garde contre les rôles copiés, car chaque correctif de sécurité doit alors être fait deux fois. Cela reste le prix de cette solution. En face, il y a désormais scripts/compare-roles.sh, qui montre les différences entre les rôles communs. La séparation fait aussi gagner du travail : le dépôt du blog a perdu environ 34 800 lignes.
À retenir : Un dépôt séparé ne résout pas tout. Il échange la règle « chaque modification doit convenir aux deux piles » contre l’obligation de transmettre activement les leçons.
✍️ Des articles dans un dépôt plutôt que dans une base de données
Un article est maintenant un fichier Markdown. Mon quotidien ressemble à ceci :
# Écrire l'article, le prévisualiser en local, puis :
tools/build.sh                          # construit toutes les pages et l'index de recherche
tools/deploy.sh <host>                  # envoi, puis bascule atomique
tools/deploy.sh <host> 10022 rollback   # si quelque chose ne va pas
Un nouveau déploiement a pris 18 secondes en test. La bascule n’est qu’un lien symbolique déplacé, et les cinq dernières versions restent sur le serveur. La clé ne peut qu’envoyer, activer et revenir en arrière. Le serveur refuse tout le reste, et je l’ai testé.
Il y a aussi de vrais inconvénients, que je ne veux pas enjoliver :
- Plus d’écriture dans le navigateur ou sur le téléphone. Les articles naissent sur mon ordinateur.
- Plus de médiathèque ni d’optimisation automatique des images par une extension. Les images passent par le dépôt et le build.
- Les articles programmés ne paraissent pas tout seuls, il faudrait pour cela un minuteur dédié.
- Plus de conseils de Yoast. Le gabarit génère désormais les balises pour les moteurs de recherche à chaque build, mais personne ne me prévient si une description manque.
À retenir : J’échange le confort d’écriture contre la simplicité d’exploitation. Cela convient à un blog tenu par une seule personne ; pour une rédaction, ce serait le mauvais choix.
🚀 Performances : l’ancien contre le nouveau
Mesuré avec Chrome, médiane de sept passages à chaque fois. Les anciennes valeurs viennent du blog en ligne, les nouvelles de la machine de test, sans visiteurs et avec un certificat auto-signé. Ce n’est donc pas encore une comparaison finale équitable.
| Mesure | WordPress | Hugo |
|---|---|---|
| Téléphone, article : premier contenu visible | 2,54 s | 0,71 s |
| Téléphone, page d’accueil : premier contenu visible | 2,54 s | 0,59 s |
| Bureau, article : chargement complet | 451 ms | 140 ms |
| Article : requêtes | 42 | 13 |
| Article : données | 455 Ko | 235 Ko |
Juste après la bascule, j’ai mesuré sur le vrai serveur, avec un vrai certificat et depuis l’extérieur :
| Mesure sur le vrai serveur | WordPress | Hugo, HTTP/2 | Hugo, HTTP/3 |
|---|---|---|---|
| Téléphone, article : premier contenu visible | 2,54 s | 0,80 s | 0,75 s |
| Téléphone, page d’accueil : premier contenu visible | 2,54 s | 0,64 s | 0,58 s |
| Bureau, article : chargement complet | 451 ms | 386 ms | 315 ms |
| Bureau, article : données | 455 Ko | 178 Ko | 178 Ko |
Le téléphone gagne nettement ; sur ordinateur, l’écart est plus faible que sur la machine de test. Ce n’est pas encore une valeur durable : le serveur était neuf et sans charge normale.
La première mesure a aussi révélé un bug de mon nouveau thème : le carrousel chargeait cinq images en pleine taille en même temps, même sur téléphone où il est masqué, et l’image réellement visible arrivait en dernier. Après correction, le plus grand élément de la page d’accueil apparaît sur téléphone après 1,29 au lieu de 2,25 secondes, et les données passent de 545 à 292 Ko sur téléphone et de 1,22 Mo à 606 Ko sur ordinateur. Le tableau ci-dessus montre l’état après correction.
Voici aussi la vue depuis d’autres continents : temps total pour le même article en HTTP/2, médiane de cinq sondes Globalping à chaque fois, un seul passage. Il n’existe pas de valeur « avant », car je n’ai jamais mesuré ainsi sous WordPress. Je ne peux donc pas dire si c’est devenu plus rapide là-bas.
| Région | Temps total |
|---|---|
| Europe | 0,26 s |
| Amérique du Nord | 0,56 s |
| Asie | 1,02 s |
| Amérique du Sud | 1,06 s |
| Afrique | 1,15 s |
| Océanie | 1,72 s |
Le serveur est en Allemagne, et des fichiers statiques ne changent rien à la distance. Aller plus loin demanderait un CDN, que je n’utilise pas par choix.
À retenir : Le plus gros gain ne vient pas d’un matériel plus rapide, mais du fait qu’il faut moins de fichiers et aucune exécution de programme.
🎢 HTTP/3 : coupé cette semaine, actif maintenant
Il y a quelques jours, j’expliquais dans un long article pourquoi HTTP/3 restait coupé chez moi : après un rechargement de nginx, un worker maintenu en vie par une seule longue connexion garde les sockets UDP partagés, et environ une connexion QUIC sur huit reste bloquée. Le correctif en amont s’appelait quic_bpf, et je considérais l’affaire close, avec une certaine dignité même.
Puis est venu le déménagement, et sans contrôleur d’ingress, j’ai pu choisir librement la version de nginx pour la première fois. Donc encore un essai, d’abord avec la version calme et éprouvée, par prudence :
nginx avec quic_bpf | Connexions bloquées pendant les rechargements |
|---|---|
| 1.26 | aucune amélioration |
| 1.30.6 | 40 sur 1 000 |
| 1.31.8 (mainline) | 0 sur 2 370 |
La voie éprouvée était donc la mauvaise. La solution exigeait la mainline, plus les capacités CAP_BPF, CAP_PERFMON et CAP_NET_ADMIN pour un service que je restreins autant que possible par ailleurs, et un module SELinux dédié pour que le programme BPF puisse seulement se charger. S’y ajoute worker_shutdown_timeout 30s, pour qu’un ancien worker ne reste pas éternellement.
Pour finir, j’ai voulu le voir avec un vrai Chrome. Résultat du premier passage : 300 pages sur 300 en échec, chacune en une fraction de seconde. Brève frayeur, puis l’explication : pour QUIC, Chrome n’accepte pas de certificat auto-signé, même avec l’option générale d’ignorance, l’erreur était donc dans mon montage de test. Avec le hash de la clé renseigné et sous feu continu, soit un rechargement toutes les cinq secondes plus un téléchargement ouvert, 298 pages sur 300 sont arrivées en HTTP/3, avec une médiane de 236 ms et 1,3 s pour la plus lente. Sans rechargement, c’était 300 sur 300. Aucune page n’est restée bloquée, dans aucun des deux passages. Les deux abandons viennent donc probablement du rechargement, rare au quotidien : un déploiement n’en déclenche aucun.
À retenir : Un constat vaut pour une version donnée. « Ça ne marche pas » était vrai cette semaine et ne l’est plus. Et quand un test échoue à 100 %, il faut d’abord vérifier le test.
🔧 Ce que le test à partir de zéro a trouvé
Avant d’effacer le vrai serveur, j’ai fait réinstaller la machine de test et j’ai lancé le playbook à partir de zéro. Cela a tout de suite payé, car ces erreurs m’auraient sinon surpris pendant la vraie migration :
- Le redémarrage qui n’en était pas un : le premier passage redémarre le serveur pour que le port SSH et le pare-feu s’activent ensemble. La commande tournait avec
async: 1et commençait parsleep 2. L’actuel ansible-core 2.21 met fin à la tâche après une seconde et indique quand mêmechanged. Le playbook a attendu cinq minutes un port qui ne s’est jamais ouvert. - Le fichier PID vide : la vérification
nginx -tcrée un/run/nginx.pidvide quand nginx ne tourne pas encore, avec le type SELinuxvar_run_t. Le service danshttpd_tne peut alors pas ouvrir le fichier et ne démarre pas. Cela arrive à chaque première installation. - Un fail2ban qui n’existait pas encore : le handler du pare-feu redémarre fail2ban, mais sur une machine neuve il n’est pas encore installé à ce moment-là. Cela n’est apparu qu’au deuxième vrai passage à partir de zéro ; avant, le pare-feu était déjà en place et le masquait.
- Ce que WordPress faisait en passant : la comparaison avec le blog en ligne a montré qu’il manquait
robots.txt, les anciennes adresses de sitemap ettwitter:card. Yoast fournissait tout cela. - Enfermé dehors par ma propre sécurité : le domaine figure sur la liste de préchargement HSTS. Mon Firefox ne me laissait donc pas ouvrir le site de test auto-signé, même après suppression de toutes les données. La règle est intégrée au navigateur.
- La machine de test mystérieusement lente : à configuration égale avec le serveur du blog, elle a d’abord tourné bien plus lentement. Après la réinstallation suivante, l’écart avait disparu, et le passage à partir de zéro a pris environ 12 minutes au lieu de plus de 30. J’en ignore la cause, je soupçonne la machine hôte. Ce n’était pas le playbook, car j’ai mesuré chaque minute pendant le passage.
Après les corrections, le passage de contrôle a affiché changed=0.
À retenir : Un passage sur une machine existante ne prouve pas grand-chose. Le passage à partir de zéro est le vrai test, et il doit avoir lieu avant le jour J.
🚧 Ce qui a mal tourné pendant la vraie migration
Malgré tous les tests, le jour J n’a pas été sans accroc, et cela a sa place ici. Le blog a été indisponible le 6 novembre d’environ 18 h 10 à 19 h 52, bien plus longtemps que la demi-heure prévue.
- Le répertoire manquant : Let’s Encrypt ne pouvait pas être testé sur la machine de test, cette étape a donc tourné pour la première fois sur le vrai serveur. Le répertoire du hook n’apparaît qu’au premier passage de
certbot; le playbook voulait y écrire avant et s’est arrêté. Cela a vite été corrigé. Le passage a ensuite repris sur le port 10022 et a obtenu aussitôt un certificat valide. - Enfermé dehors par moi-même : je voulais garder les anciennes clés d’hôte SSH pour que les autres machines reconnaissent toujours le serveur. Elles avaient le mode
640avec le groupessh_keys, et le groupe s’est perdu à la copie.sshdrefuse de telles clés et n’a plus démarré. J’avais redémarré sanssshd -t, et mon seul accès avait disparu. Le sauvetage a été unchmod 600via la console de l’hébergeur. La machine de test ne l’a pas montré, car ses clés étaient déjà en600. - Graphique Pressure vide :
psi=1ne prend effet qu’après un redémarrage, et sur AlmaLinux 10,/proc/pressurea son propre type SELinuxproc_psi_t, que mon module pournode_exporterne connaissait pas. - Pas de swap : je n’y avais tout simplement pas pensé pendant la refonte. Sans K3s, plus rien ne s’y oppose, et il existe maintenant un petit fichier de swap.
Côté positif : les 592 anciennes adresses d’articles et de pages répondent toujours, la somme de contrôle du site est correcte, et un piège du sitemap a été repéré à temps : il contenait des pages de tags en noindex.
À retenir : un test ne prouve que ce qu’il touche. Avant de redémarrer un service dont dépend votre propre accès, lancez toujours la vérification de sa configuration.
🛡️ Est-ce sans risque ?
La surface d’attaque est devenue bien plus petite. Il n’y a plus de PHP, d’extensions, de base de données ni de connexion WordPress. Seule reste sur le serveur la connexion à Grafana, protégée par un filtre par pays, une authentification en amont et fail2ban. Les mises à jour de sécurité régulières de WordPress, des extensions et du cluster disparaissent. Mais le risque ne s’est pas envolé, il s’est déplacé :
- Compte GitHub : il détient maintenant tout le contenu. Il ne remplace la 2FA de WordPress que s’il est lui-même bien protégé.
- Machine de build : qui en prend le contrôle peut modifier le site avec la clé de déploiement, mais pas le serveur.
- Certificat : à cause du préchargement HSTS, aucun visiteur ne peut ignorer un avertissement de certificat. Si le renouvellement échoue, le blog est aussitôt inaccessible. La supervision doit le signaler tôt.
- HTTP/3 sur mainline : j’utilise sciemment une ligne de développement avec des droits étendus. En échange, une seule variable permet de couper HTTP/3.
- Le déménagement lui-même : le seul retour possible passait par la sauvegarde complète. Je l’ai donc vérifiée avant et j’ai sauvegardé les certificats à part.
À retenir : Les sites statiques ne sont pas automatiquement sûrs. Le risque passe du serveur aux comptes, aux clés et aux certificats.
💾 Sauvegarde : moins de données, d’autres questions
Avant, je devais surtout sauvegarder la base de données et les médias, sinon le blog était perdu. Désormais le site lui-même est un produit dérivé : il peut être reconstruit à tout moment à partir du dépôt de contenu. Il en va de même du serveur, que construit le playbook. Reste important ce qu’on ne peut pas recréer :
- Dépôt de contenu : la vraie source. Il se trouve sur GitHub et aussi dans la sauvegarde du homelab.
- Certificats : pour qu’une reconstruction ne dépende pas de la prochaine demande réussie.
- Clés d’hôte SSH : sinon chaque connexion donne l’alerte après une restauration.
- Statistiques de visites : impossibles à regénérer à partir d’autre chose.
- Mot de passe du vault : sans lui, le playbook ne sert pas à grand-chose lors d’une reconstruction, donc à conserver à part.
Là aussi, le test a payé. Sans rsync -H, ma nouvelle sauvegarde aurait multiplié les versions liées par liens physiques, et rdiff-backup aurait aussi versionné les sauvegardes interrompues, en comptant des fichiers comme supprimés. Les deux problèmes sont corrigés. Sur une machine de test fraîchement installée, la restauration a ensuite pris 16 secondes, la somme de contrôle sur les 18 837 fichiers correspondait au build, et les clés d’hôte SSH étaient de nouveau les anciennes. L’ancienne sauvegarde WordPress avec le dump de la base reste conservée à part.
À retenir : Une sauvegarde ne compte qu’une fois la restauration vraiment effectuée. Que presque tout puisse être reconstruit la rend plus simple, pas superflue.
🎯 Les leçons
- Mesurer d’abord, croire ensuite. Cela vaut pour « Hugo apporte peu aux lecteurs » comme pour « HTTP/3 ne marche pas ».
- Le test à partir de zéro trouve ce que masque tout passage sur une machine qui a vécu.
- Une extension comme Yoast fait plus qu’on ne le remarque. Avant de la couper, il faut comparer sa sortie ligne par ligne.
- Qui retire un composant doit aussi retirer ses exceptions : pare-feu, règles d’audit, alertes.
- La sécurité se déplace, elle ne disparaît pas. Après la refonte, ce qui compte, c’est qui détient la clé et le compte.
- Toujours
sshd -tavant de redémarrersshd, et garder un deuxième accès prêt.
J’ajouterai après quelques jours d’exploitation ce que cela donne au quotidien et sous charge normale.