Deep Dive : Hugo – ce que fait un générateur de site statique, ce qui a remplacé mes plugins WordPress, et comment la recherche fonctionne sans serveur
Ce qu'est Hugo et en quoi il diffère de WordPress, ce qui a repris le travail de Yoast, Polylang et des plugins de cache, comment un champ de recherche fonctionne sur un site sans serveur, comment j'ajoute un article et mets Hugo à jour – et quels pièges ne sont apparus qu'en exploitation.
🌐 Aussi en: English · Deutsch · Español · Italiano · Português · Nederlands · Polski
Deep Dive de la série autour de l’Ansible Tour. Le tour explique les rôles, les deep dives la technique en dessous : comment elle fonctionne, pourquoi elle est utilisée ainsi ici, et ce qui a mal tourné en chemin.
Début novembre, ce blog est passé de WordPress sur Kubernetes à Hugo. L’expérience avec de vrais chiffres et le déménagement lui-même sont racontés ailleurs. Cet article est la vue d’ensemble que j’aurais aimé avoir avant de commencer : ce qu’est réellement Hugo, ce qui a repris le travail des plugins WordPress, comment un champ de recherche fonctionne sur un site qui n’a aucun code côté serveur, ce que je fais quand j’ajoute un article ou mets Hugo à jour, et où il m’a surpris.
Table des matières
🧭 Ce qu’est Hugo
Une presse d’imprimerie au lieu d’une cuisine
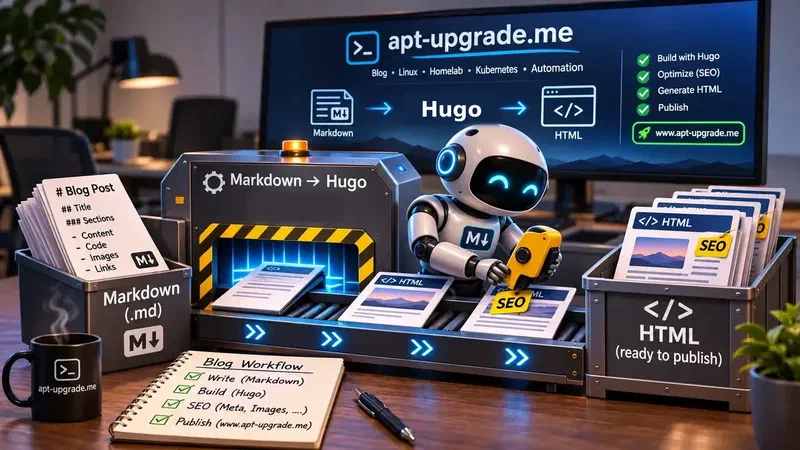
WordPress fonctionne comme une cuisine de restaurant : à chaque commande, PHP cuisine la page à partir de la base de données – sauf si un plugin de cache a déjà une assiette prête. Hugo fonctionne comme une presse d’imprimerie : il imprime chaque page une fois, à l’avance, et le serveur web ne fait que distribuer des exemplaires finis. Rien n’est cuisiné quand un lecteur arrive.
Techniquement, Hugo est un générateur de site statique : un seul programme écrit en Go qui lit des fichiers Markdown, des templates et des images, et écrit un dossier plein de HTML, de CSS, d’images et de flux. Ce dossier, c’est le site web. N’importe quel serveur web peut le servir ; ici, c’est un simple nginx.
Un binaire, deux éditions
Hugo est un seul exécutable sans dépendances – pas de PHP, pas de base de données, pas de Node.js. Il existe en édition standard et en édition extended ; l’édition extended ajoute l’encodage WebP et Sass. Ce blog utilise l’édition extended, version 0.169.0, parce que chaque image est redimensionnée et convertie en WebP pendant le build.
À retenir : Hugo déplace tout le travail du moment de la visite vers le moment de la publication. Tout le reste de cet article en découle.
⚖️ Hugo contre WordPress
| Question | WordPress | Hugo |
|---|---|---|
| Quand une page est-elle produite ? | À chaque requête (ou depuis un cache) | Une fois, au moment du build |
| Qu’est-ce qui tourne sur le serveur ? | PHP, MariaDB, souvent Redis | Seulement le serveur web |
| Surface d’attaque | Login, admin, plugins, XML-RPC, PHP | Fichiers statiques |
| Mises à jour régulières | Cœur, plugins, thèmes, PHP | nginx ; Hugo seulement sur la machine de build |
| Où est-ce que j’écris ? | Éditeur dans le navigateur | Éditeur de texte, Git |
| Commentaires, formulaires | Intégrés | Nécessitent un service externe |
| Vitesse | En cache : 58 ms pour la page d’accueil | 57 ms – aucune différence |
| Poids de la page (accueil, sans images) | 25 fichiers, 198 Ko | 3 fichiers, 9,5 Ko |
Les chiffres viennent de mes propres mesures avant le déménagement. La vitesse n’était pas la raison : un WordPress bien mis en cache est tout aussi rapide. Les raisons étaient le reste du tableau – pas de login à attaquer, pas de mises à jour de plugins chaque semaine, pas de base de données à sauvegarder, et une page 95 % plus légère.
Ce que j’ai abandonné : l’éditeur dans le navigateur, les commentaires et le confort d’installer une fonctionnalité en un clic.
À retenir : WordPress est un programme qui produit un site web. Hugo produit le site une fois et s’efface. Que ce soit mieux dépend de si tu as besoin de ce que seul le programme en marche sait faire.
🔧 Comment Hugo fonctionne
Le contenu : du Markdown avec un front matter
Chaque article est un fichier Markdown. En haut se trouve le front matter, un bloc YAML que Hugo lit comme des données. Un article de ce blog commence ainsi :
---
title: 'Zabbix in Containers Watches My Home Network'
slug: zabbix-in-containers-watches-my-home-network
date: '2026-11-13T15:40:00+01:00'
translationKey: zabbix-heimnetz-2026-11
description: 'Short summary for search results, at most about 155 characters.'
categories:
- linux
tags:
- zabbix
image: uploads/2026/11/zabbix-watchman.webp
imageAlt: What the picture shows, for screen readers and search engines
---
Sous le second --- vient le texte. Markdown couvre les titres, les listes, les tableaux et le code ; là où il ne suffit pas, le HTML brut est autorisé (unsafe = true dans les réglages de Goldmark), ce qui compte pour les articles convertis depuis WordPress.
Dossiers, sections et adresses
site/
├── content/en/posts/   posts in English (one folder per language)
├── content/de/posts/   posts in German, and so on for eight languages
├── layouts/            templates: the theme
├── assets/             CSS and JavaScript, processed by Hugo
├── uploads/            images and downloads
├── i18n/               interface words per language ("Read more", "Search")
├── data/               menus, flags, footer text as JSON
└── hugo.toml           configuration
hugo.toml décide des adresses : posts = "/:year/:month/:day/:slug/" conserve le schéma d’URL qu’utilisait WordPress, si bien qu’aucun ancien lien n’a cassé. Les catégories et les tags sont des taxonomies ; Hugo construit tout seul une page pour chaque catégorie et chaque tag.
Les templates
Les templates utilisent le langage de templates de Go. baseof.html est le cadre de chaque page, page.html un article seul, home.html la page d’accueil, et les partials sont des morceaux réutilisables – l’en-tête, la barre latérale, le <head> avec toutes les balises meta. Je n’utilise aucun thème tout fait : les layouts ont été écrits pour ressembler à l’ancien thème WordPress.
Le pipeline d’assets
Hugo traite lui-même les fichiers : resources.Get "css/main.css" | minify | fingerprint minifie la feuille de style et met un hash dans son nom de fichier, pour que les navigateurs puissent la garder en cache pour toujours. Les images sont redimensionnées pendant le build – l’image d’aperçu pour les réseaux sociaux, par exemple, est créée à partir de l’image de l’article à 1200 px puis réduite jusqu’à rester sous 280 Ko, la limite des aperçus WhatsApp.
Multilingue dès le départ
Chaque langue a son propre dossier de contenu, son libellé et sa locale dans hugo.toml. Les articles qui vont ensemble partagent une translationKey ; grâce à elle, Hugo connaît les traductions de chaque page et construit le sélecteur de langue et les liens hreflang. Ce blog compte désormais huit langues – anglais, allemand, français, espagnol, italien, portugais, néerlandais et polonais.
Aperçu et brouillons
hugo server construit le site en mémoire et le sert sur localhost:1313 ; chaque fichier enregistré recharge le navigateur. draft: true exclut un article du vrai build, et une date dans le futur aussi – plus de détails sur ce point plus bas.
À retenir : contenu, templates et configuration sont trois sortes de fichiers séparées. Tu peux changer l’apparence sans toucher un seul article, et écrire un article sans savoir comment les templates fonctionnent.
🧩 Où sont passés les plugins
Sous WordPress, presque chaque fonctionnalité était un plugin. Sous Hugo, une fonctionnalité est soit intégrée, soit quelques lignes de template, soit un petit script qui tourne après le build.
| Plugin WordPress | Rôle | Maintenant |
|---|---|---|
| Yoast SEO | Titre, description, canonical, Open Graph, données structurées | head.html (un template pour toutes les pages) |
| Yoast SEO | Sitemap | Intégré à Hugo, template sitemap.xml maison avec hreflang |
| Yoast SEO | « Ton article n’a pas de description » | check_posts.py : le build s’arrête |
| Polylang | Langues, sélecteur de langue | Intégré à Hugo |
| CompressX | Images WebP, tailles réduites | Traitement d’images de Hugo |
| Autoptimize | Minifier CSS, JS, HTML | hugo --minify |
| WP Super Cache, Redis | Cache de pages et d’objets | Inutile – chaque page est déjà un fichier |
| Recherche (WordPress) | Recherche plein texte | Pagefind (section suivante) |
Du SEO sans plugin
Yoast faisait trois choses : il écrivait les balises meta, il construisait un sitemap, et il râlait. Les deux premières sont maintenant un partial, head.html. Pour chaque page, il écrit le titre (ou un seoTitle plus court tiré du front matter), la description, un lien canonical, un lien hreflang par traduction, les balises Open Graph et Twitter avec une image d’aperçu générée, les dates de l’article, et un bloc JSON-LD avec les mêmes données structurées que produisait Yoast (Article, WebPage, BreadcrumbList, Person). C’est un seul fichier, et il est le même pour chaque page – pas d’écran de réglages par article.
Les râleries ont migré dans le build : tools/check_posts.py arrête le build si un article n’a pas de titre, de description, d’image, de texte d’image, de clé de traduction ou de date, ou si le fichier image n’existe pas, et il avertit quand une description devient trop longue ou qu’une traduction manque.
Les extensions dans Hugo
Hugo n’a pas de boutique de plugins, mais il a des points d’extension :
- Thèmes et Hugo Modules – des apparences complètes ou des morceaux, intégrés comme une dépendance. Ce blog monte ses propres dossiers via
module.mounts(le dossier des uploads est monté deux fois : une fois pour le traitement d’images, une fois en tant que/wp-content/uploads/pour que les anciennes adresses d’images continuent de fonctionner). - Shortcodes – de petits templates que tu appelles depuis le Markdown, par ex. pour une vidéo ou un encadré.
- Render hooks – ton propre template pour chaque lien, image ou titre que produit Markdown.
- Output formats – le même contenu en HTML, RSS, JSON ou n’importe quoi d’autre.
- Outils après le build – le build n’est qu’un dossier, donc n’importe quel programme peut travailler dessus. Ici,
imgattrs.pyajoutesrcsetet le lazy loading aux images des anciens articles, et Pagefind construit l’index de recherche.
À retenir : la plupart des plugins résolvaient des problèmes qu’un site statique n’a pas. Le reste est devenu un template ou un script que je peux lire en entier – ce qui veut aussi dire que personne d’autre ne les met à jour pour moi.
🔍 Comment la recherche fonctionne sans serveur
Un champ de recherche semble avoir besoin d’un serveur : il faut bien que quelqu’un cherche les mots. Pagefind déplace ce travail-là aussi dans le build.
- Au moment du build, Pagefind lit chaque page HTML finie. Il n’indexe que la partie marquée par
data-pagefind-body(l’article), pour que les menus et barres latérales ne polluent pas les résultats, et il ignore tout ce qui est marquédata-pagefind-ignore. Il détecte la langue grâce à l’attributlanget construit un index par langue. - L’index est découpé en de nombreux petits fichiers sous
/pagefind/– 18 Mo au total pour huit langues. Personne ne télécharge le tout. - Dans le navigateur, rien n’est chargé tant que personne ne cherche vraiment. Ensuite, quelques lignes de JavaScript importent Pagefind, qui ne récupère que les morceaux d’index des mots tapés et les fragments des pages correspondantes, et affiche le titre et l’extrait.
import('/pagefind/pagefind.js')
  .then(function (m) { return m.search(term); })
  .then(function (r) { return Promise.all(r.results.slice(0, 8).map(function (x) { return x.data(); })); })
Un effet de bord que j’aime bien : le terme recherché n’atteint jamais le serveur sous forme de query string, donc il ne finit dans aucun access log. Le formulaire est volontairement masqué pour les navigateurs sans JavaScript – un envoi classique du formulaire aurait mis le terme dans l’URL.
À retenir : « statique » ne veut pas dire « sans interaction ». Cela veut dire que l’interaction se passe dans le navigateur du lecteur, avec des données préparées à l’avance.
✍️ Mon flux de travail pour un nouvel article
- Écrire le fichier Markdown dans
site/content/en/posts/<slug>.mdavec le front matter ci-dessus. Les traductions reçoivent le même nom de fichier, la mêmetranslationKeyet des tags avec un suffixe de langue (hugo-de,hugo-fr, …). - Ajouter l’image dans
site/uploads/YYYY/MM/– en WebP, 1536 px de large au maximum, moins de 280 Ko. Dans le texte, les images sont référencées en/wp-content/uploads/YYYY/MM/name.webp, l’adresse qu’utilisait WordPress. - Construire :
tools/build.sh
Il lance check_posts.py, puis hugo --gc --minify, puis imgattrs.py, puis Pagefind. Hugo lui-même a besoin d’environ dix secondes pour tout le site.
- Publier :
tools/deploy.sh <host> 10022
rsync envoie le build dans un dossier incoming/ ; le serveur le copie ensuite dans un nouveau dossier de release et y bascule un lien symbolique en une seule étape. Les cinq dernières releases sont conservées, si bien que tools/deploy.sh <host> 10022 rollback revient en arrière en une seconde. La clé de déploiement ne peut rien faire d’autre – le serveur n’accepte pour elle que exactement ces commandes.
- Committer et pousser le dépôt de contenu.
Deux dépôts : code ouvert, contenu privé
Le serveur et les outils de build vivent dans un dépôt public, www_hugo, à côté du code Ansible pour tout le reste. Le contenu – articles, images, templates, brouillons – vit dans un dépôt privé. La raison : un dépôt se souvient de tout. Une image que je retire resterait pour toujours dans l’historique d’un dépôt public, et les brouillons ne sont pas destinés aux lecteurs. Le serveur ne reçoit que des fichiers finis via l’étape de déploiement et ne voit jamais un brouillon ; le dépôt public ne voit jamais le contenu.
À retenir : publier, ce sont deux étapes indépendantes. Le serveur montre ce qui a été déployé en dernier, Git garde ce qui a été commité en dernier – je fais les deux, dans cet ordre.
⬆️ Mettre Hugo à jour
Hugo n’est pas du tout installé sur le serveur. Il vit sous forme d’un binaire unique dans .tools/ sur la machine qui construit le site, avec Pagefind. Les versions sont épinglées dans le versions.yml du dépôt public :
hugo_version:                "0.169.0"   # github.com/gohugoio/hugo/releases
pagefind_version:            "1.6.0"     # github.com/Pagefind/pagefind/releases
Une mise à jour suit le même schéma que partout ailleurs ici :
- Lire les release notes – Hugo déprécie de temps en temps des fonctions de template et prévient dans la sortie du build bien avant de les supprimer.
- Télécharger la release extended pour Linux, comparer son SHA-256 avec le fichier de sommes de contrôle de la release, remplacer
.tools/hugo. - Construire dans un dossier séparé et comparer avec le build précédent (
diff -r). Seules des différences attendues doivent apparaître. - Changer l’épinglage dans
versions.yml, déployer, committer.
Comme le serveur ne fait que servir des fichiers, une mise à jour de Hugo ne peut jamais casser le site en ligne. Le pire cas est un build qui échoue ou qui a un autre aspect – et cela se passe sur ma machine, pas devant les lecteurs.
À retenir : le générateur est un outil de build, comme un compilateur. Épingle-le, mets-le à jour volontairement et compare la sortie.
🤖 Ce que Claude fait autour de Hugo
L’essentiel du travail sur ce blog se fait avec Claude (l’IA d’Anthropic) dans le terminal. Par thème :
- Migration : export depuis WordPress, conversion de chaque article en Markdown avec front matter, anciennes adresses et chemins d’images conservés, redirections pour les slugs modifiés.
- Templates et apparence : reconstruction de l’ancien thème en templates Hugo, le slider, la barre latérale, les recoins obscurs comme les pages d’archives par date.
- SEO : le partial
head.html, le sitemap avechreflang, les données structurées, les images d’aperçu sous la limite de WhatsApp. - Écriture et traduction : des brouillons avec mes mots, des traductions dans les huit langues selon des règles fixes (blocs de code identiques à l’octet près, liens réécrits par langue) et un vérificateur qui compare chaque traduction avec l’original anglais.
- Vérifications : le contrôle du build, une vérification des liens sur toutes les pages générées, un contrôle en direct du site en ligne.
- Serveur et déploiement : le rôle Ansible pour nginx, le déploiement atomique, SELinux, le monitoring.
- Dépannage : trouver pourquoi un article n’apparaissait pas (voir la section suivante) ou pourquoi un fil d’Ariane pointait vers une page manquante.
Ce qui reste de mon côté : décider de ce qui est écrit et publié, lire chaque brouillon, lancer les playbooks, et chaque push et chaque déploiement – Claude demande avant chacun.
À retenir : un site statique, ce sont des fichiers texte et de petits scripts – exactement le matériau qu’un assistant IA manie bien. Les décisions restent les miennes.
🐛 Les pièges apparus seulement en exploitation
- Un article venu du futur n’est pas construit. J’ai réglé la date d’un article sur 15:50 et lancé le build à 15:44 – Hugo l’a laissé de côté sans rien dire. Pas d’erreur, l’article manquait simplement.
datedoit être dans le passé, sinon le build a besoin de--buildFuture. - Une page de jour manquante. Le fil d’Ariane d’un nouvel article pointait vers son archive du jour (
/2026/11/13/), qui n’existait pas, parce que les pages de dates sont des fichiers de contenu et non des pages générées. La vérification des liens l’a trouvé ; désormais, une nouvelle date a besoin de son_index.md. Et en écrivant cet article précis, les deux erreurs se sont reproduites : l’article était daté de 08:30 et construit à 08:22, et sa nouvelle page de jour portait 12:00 – une page datée de midi est dans le futur toute la matinée. - Le HTML converti est fragile. Les articles importés de WordPress sont un mélange de Markdown et de HTML brut. Dans quelques-uns, des mots étaient collés ou un
**égaré avait survécu. Seule une vérification des pages rendues dans toutes les langues les a trouvés. - Les réglages typographiques comptent. Le typographer de Hugo transforme par défaut
--en tiret. WordPress ne le faisait pas, donc des commandes comme--checkseraient devenues–checkdans les anciens articles. Le réglage ne touche désormais que les guillemets et les apostrophes. - Tout n’a pas sa place dans la recherche et les flux. Les mentions légales et la politique de confidentialité contiennent l’adresse postale. Elles sont en
noindex, exclues des flux RSS et de l’index Pagefind – un plugin aurait eu besoin d’un réglage pour chacun de ces points, ici c’est une condition dans les templates. - Certaines adresses viennent du front matter. Quelques anciens articles portent une clé
url:avec le chemin complet. Dans les traductions, elle a besoin du préfixe de langue, sinon toutes les langues revendiquent la même adresse.
À retenir : Hugo fait exactement ce qu’on lui dit et se plaint rarement. Les vérifications que les plugins WordPress faisaient discrètement doivent être écrites noir sur blanc – et ensuite, elles tournent à chaque build.
📊 Mesures
| Articles | 146, en 8 langues |
| Pages HTML générées | environ 23 000 (articles, tags, catégories, archives) |
| Build Hugo | environ 10 s (site entier) |
| Dossier de sortie | 498 Mo, presque entièrement des images |
| Index de recherche | 18 Mo pour 8 langues, chargé en petits morceaux |
| Logiciel sur le serveur pour le blog | nginx |
🎯 Les leçons
- Décide où le travail se fait : à la visite (WordPress) ou à la publication (Hugo).
- Vérifie ce qu’un plugin faisait vraiment avant de le remplacer – l’essentiel tient dans un template, une partie est une vérification que tu dois écrire toi-même.
- Recherche, flux et sitemaps fonctionnent sans serveur quand le build prépare les données.
- Épingle le générateur comme n’importe quel autre outil de build et compare la sortie avant de déployer.
- Un article manquant sans message d’erreur, c’est généralement une date dans le futur.
- Garde contenu et code séparés quand le code est public.