
Huit heures pour une sauvegarde : comment un disque SMR, rdiff-backup et Hugo se freinaient mutuellement
Mon PC de sauvegarde tournait récemment plus de huit heures, alors que presque aucune donnée n'avait changé. La piste menait à un disque dur couvert de tuiles, à un outil qui inscrit chaque fichier séparément sur le disque et à un blog qui réécrit 70 000 fichiers à chaque build.
🌐 Aussi en: English · Deutsch · Español · Italiano · Português · Nederlands · Polski
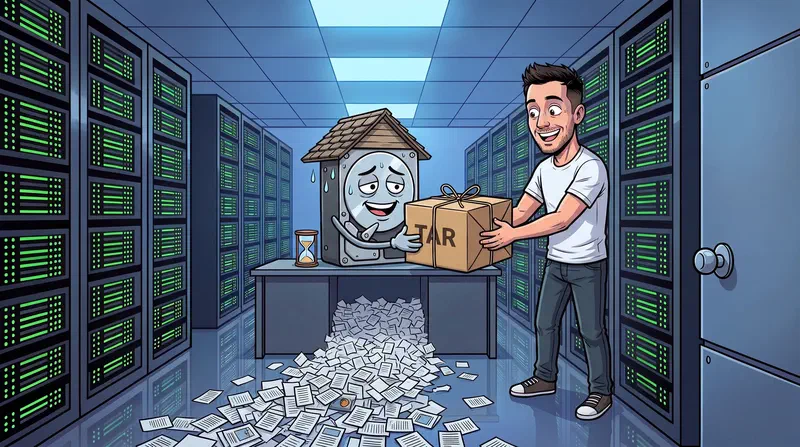
En bref : Mon PC de sauvegarde a récemment eu besoin de huit heures et 18 minutes pour un passage, pour des données qui n’avaient presque pas changé. Il n’y avait pas une cause, mais trois qui se renforçaient : un disque dur SMR, qui s’effondre sous de nombreuses petites écritures ; rdiff-backup, qui force chaque fichier sur le disque individuellement ; et mon blog Hugo, qui réécrit ses quelque 70 000 fichiers à chaque build. Désormais je sauvegarde le blog dans une seule archive tar.gz (38 secondes au lieu de jusqu’à quatre heures), rdiff-backup tourne avec --no-fsync, et ce qui peut être régénéré reste dehors.
Table des matières
🐢 Le symptôme : huit heures pour presque rien
Mon PC de sauvegarde est une vieille machine que j’allume quand il faut sauvegarder : elle récupère tout, puis s’éteint d’elle-même. Elle sauvegarde quatre choses l’une après l’autre : Nextcloud, le blog, les partages du NAS et mon répertoire personnel sur le poste de travail. L’outil pour tout : rdiff-backup. Il garde un miroir à jour et, pour chaque fichier modifié, dépose à côté un fichier « increment » avec l’ancien état ; on peut ainsi retrouver n’importe quelle version antérieure.
Longtemps, c’était rapide. Puis les statistiques ressemblaient à ceci :
| Passage | Nextcloud | Blog | NAS | Home | Total |
|---|---|---|---|---|---|
| 12/11 | 15 min | 0 min | 1 min | 39 min | 56 min |
| 17/11 | 55 min | 169 min | 6 min | 167 min | 6 h 37 min |
| 19/11 | 4 min | 110 min | 186 min | 198 min | 8 h 18 min |
Mêmes données, même matériel : tantôt un peu moins d’une heure, tantôt plus de huit. Aucun passage n’a demandé nettement plus de place. Ce n’était donc pas le volume, mais autre chose.
🏠 Constat 1 : le disque dur a un toit de tuiles
Premier regard sur le matériel : le disque de sauvegarde est un Seagate Barracuda de 8 To. Ce modèle utilise le SMR (Shingled Magnetic Recording) : les pistes se chevauchent comme des tuiles. On loge ainsi plus de données sur le plateau, mais il y a un piège : modifier une piste écrase aussi la piste voisine qui la recouvre à moitié ; le disque doit donc lire et réécrire des zones entières (des bandes).
Pour qu’on ne le remarque pas au quotidien, le disque possède une petite zone tampon écrite de façon classique. Les nouvelles données y arrivent d’abord, et le disque les range dans les bandes à tuiles pendant les moments calmes. Les gros fichiers d’un seul bloc ne posent aucun problème. Beaucoup de petites écritures, en revanche, remplissent vite le tampon, et le débit d’écriture tombe alors de plus de 100 Mo/s à une fraction, parce que le disque reçoit et réorganise en même temps.
Sur un disque pour films ou photos, on ne le remarque jamais. Sur une sauvegarde faite de centaines de milliers de petits fichiers, on le remarque très nettement.
💾 Constat 2 : rdiff-backup inscrit chaque fichier séparément
Deuxième regard : la façon dont rdiff-backup écrit. Pour chaque fichier qu’il crée ou remplace, il appelle fsync, qui oblige le système d’exploitation à écrire le fichier physiquement sur le disque tout de suite au lieu de le garder en mémoire. L’intention est bonne : si la machine plante en plein passage, chaque fichier déjà sauvegardé est réellement sur le disque.
Sur un disque SMR, c’est pourtant le pire des cas : chaque fichier est une petite écriture synchrone. J’ai mesuré dans les passages environ 10 à 15 fichiers par seconde. Pour quelques centaines de fichiers modifiés, peu importe. Pour 200 000, c’est quatre heures.
🔁 Constat 3 : Hugo réécrit tout à chaque build
Et d’où viennent 200 000 fichiers modifiés quand je ne change qu’un article ? Du passage à Hugo. Depuis, mon blog est une collection de fichiers statiques : environ 150 articles en 8 langues, plus les pages de mots-clés, les catégories, la pagination, les flux, l’index de recherche et les images en plusieurs tailles, soit environ 70 000 fichiers.
Hugo reconstruit tout le site à chaque déploiement et le remet en place entièrement, y compris les pages qui n’ont pas changé du tout. Pour rdiff-backup, après chaque déploiement presque chaque fichier a changé : nouvelle copie dans le miroir plus un fichier increment avec l’ancien état. Selon le nombre de déploiements depuis le dernier passage, cela faisait de 59 000 à 214 000 nouveaux fichiers par passage. À 10–15 fichiers par seconde : de 110 à 234 minutes rien que pour le blog.
Sous WordPress, ce n’était pas un problème : tout était dans une base de données, et la sauvegarde était un seul dump.
🧩 Le même schéma à deux autres endroits
Une fois le principe compris, il est apparu ailleurs aussi :
- NAS (186 minutes le 19/11) : la veille, j’avais rangé mes dossiers et déplacé beaucoup d’entre eux. Pour rdiff-backup, un fichier déplacé est un fichier supprimé plus un nouveau : deux écritures par fichier. Un effet ponctuel ; le 20/11, on était revenu à 54 secondes.
- Répertoire personnel (jusqu’à 198 minutes) : sur environ 420 000 fichiers, quelque 360 000 sont des choses qui peuvent être régénérées à tout moment : images de conteneurs, caches, environnements Python,
node_modules, le site web compilé, fichiers de travail de l’extraction de CD. Ils changent sans cesse et ne valent rien en cas d’urgence.
🛠️ Ce que j’ai changé
1. Le blog est sauvegardé dans une seule archive. Au lieu de recopier 70 000 fichiers individuels avec rdiff-backup, la machine source emballe l’état avec tar, le compresse avec gzip -1 et l’envoie au PC de sauvegarde sous forme d’un seul flux de données. Un seul fichier y arrive. C’est le cas idéal pour tout disque dur, et plus encore pour un disque SMR.
ssh source "tar -C /storage --numeric-owner -cf - blog | gzip -1" > blog_2026-11-20_0814.tar.gz.part
tar -tzf blog_2026-11-20_0814.tar.gz.part | wc -l   # vérifier d'abord, renommer ensuite
Avant, le script vérifie que la dernière sauvegarde sur la source a réussi ; après, que l’archive est lisible et contient la page d’accueil. Ce n’est qu’alors qu’elle reçoit son nom définitif. gzip -1 suffit : les images sont déjà compressées, un niveau plus élevé ne coûte que du temps.
Conservation : toutes les archives des 30 derniers jours, plus la première archive de chaque mois pendant un an. C’est moins fin que l’historique de versions de rdiff-backup, mais largement suffisant pour un blog dont le code source est de toute façon dans Git. L’ancien historique rdiff reste en place pour la période d’avant.
2. rdiff-backup sans fsync pour chaque fichier. Pour Nextcloud, le NAS et le répertoire personnel, rdiff-backup tourne désormais avec --no-fsync. Tout à la fin du passage complet, un seul sync écrit tout sur le disque. Le risque est limité : si le PC de sauvegarde plante en plein passage, ce passage est incomplet ; mais cela arrive aussi avec fsync, et rdiff-backup nettoie lui-même un passage interrompu au démarrage suivant (regress).
3. Ce qui peut être régénéré reste dehors. Le répertoire personnel a maintenant une liste d’exclusions : stockage des conteneurs, .cache, .venvs, node_modules, .npm, le site compilé et les dossiers de travail. Tout cela se restaure avec une commande.
📊 Le résultat
Le premier passage avec toutes les modifications, le 20/11 :
| Étape | avant (19/11) | après (20/11) |
|---|---|---|
| Nextcloud (810 000 fichiers) | 4 min 26 s | 2 min 29 s |
| Blog | 110 min | 38 s (une archive, 888 Mo, 113 002 entrées) |
| NAS | 186 min | 54 s |
| Home | 198 min | 101 min 22 s |
| Total | 8 h 18 min | 1 h 45 min |
Pour le répertoire personnel, le premier passage est un cas particulier : rdiff-backup enregistre une fois comme « supprimés » les fichiers nouvellement exclus, soit une dernière fois des centaines de milliers de fichiers increment. À partir du passage suivant, ils disparaissent complètement.
💡 Un SSD aurait-il aussi résolu le problème ?
Je me suis posé la même question. Un SSD (ou un disque CMR classique) serait nettement plus rapide avec beaucoup de petits fichiers, sans aucun doute. Mais il n’aurait fait qu’atténuer le symptôme : 200 000 fichiers increment par passage pour un site web qu’on peut reconstruire depuis Git à tout moment, c’est du gaspillage même sur un SSD. D’abord réduire le nombre de fichiers, ensuite penser au matériel. Passer à un disque CMR, ou à Borg, qui regroupe les petits fichiers en gros blocs, reste une option pour plus tard.
🤝 Comment s’est passée l’analyse
J’ai fait la recherche avec Claude Code : j’ai juste dit « la sauvegarde prend huit heures, regarde si tu peux optimiser quelque chose » en ajoutant quelques idées (archive compressée, plus de tampon en RAM, remplacer rdiff-backup, vérifier le disque). Claude a analysé les durées dans les logs des dernières semaines, identifié le modèle de disque comme SMR, compté les fichiers increment par passage et fait le lien avec le build Hugo. Il a écrit les scripts et, quand j’ai dit « on recommence », il a interrompu la sauvegarde en cours et l’a relancée avec la nouvelle version.
🎯 Conclusion : pas le volume, le nombre
- La durée de sauvegarde dépend du nombre de fichiers, pas des gigaoctets. 888 Mo d’un seul bloc : 38 secondes. Les mêmes données en 200 000 fichiers individuels : quatre heures.
- Les disques SMR sont un mauvais choix pour des sauvegardes de nombreux petits fichiers. Regardez la fiche technique avant d’acheter : « SMR » ne figure souvent qu’en petits caractères.
- On sauvegarde un site statique en archive, pas fichier par fichier. Le code source est de toute façon dans Git.
- Ce qui peut être régénéré n’a pas sa place dans la sauvegarde. Caches et images de conteneurs coûtent du temps et n’aident pas en cas d’urgence.
- D’abord mesurer, ensuite acheter. Un nouveau disque n’aurait fait que réduire le problème.
📚 Articles liés :