
Da bare metal a K3s: diario di battaglia di una migrazione Nextcloud
🌐 Anche in: English · Deutsch · Français · Español · Português · Nederlands · Polski
Oggi ho spostato un Nextcloud di produzione da un’accogliente installazione nativa su bare metal a uno stack nuovo di zecca K3s/container. Sulla carta: prendere un backup, ripristinarlo, cambiare il DNS, fatto. In pratica: una serie di piccole mine, ognuna invisibile finché non ci metti il piede sopra. Ecco il diario di battaglia. 🪖
Indice
Passo 1: spalare i dati 🚚
Il lavoro pesante è stato un rsync di ~360 GB di dati utente più un dump SQL da ~330 MB dalla macchina di backup al nuovo nodo. Siccome avevo già fatto una pre-sincronizzazione in giornata, l’esecuzione finale ha trasferito solo il delta — tutto si è ridotto a una rapida copia incrementale. Lezione vecchia come il mondo: prima pre-carichi, poi la sincronizzazione del cutover è minuscola.
Passo 2: la prova a ostacoli delle versioni major 🎮
Il backup era Nextcloud 32.x. Lo stack di destinazione gira con la 34.x. Nextcloud ha una regola ferrea: non puoi saltare una versione major. Quindi è una camminata, un passo alla volta:
32.0.14 → 33.0.9 → 34.0.4 (occ upgrade at every step)
Il colpo di scena dei container: il codice vive in un volume persistente, e Nextcloud si rifiuta di far girare codice più vecchio su una versione dei dati più nuova (“downgrade not supported”). Ripristinare un database v32 su un pod che aveva ancora codice v34 = rifiuto immediato. La soluzione è deliziosamente artigianale: fissare l’immagine alla versione corrispondente, dare un colpetto al version.php del volume del codice perché l’entrypoint ridistenda il codice giusto, e lasciare che ogni occ upgrade finisca (la sua readiness probe blocca finché la migrazione del DB non è conclusa — serve pazienza).
Le mine invisibili 💣
1. Il socket antivirus della rovina
Dopo il restore, l’app File lanciava un nudo “Internal Server Error” subito dopo il login — e il log restava vuoto, perché il crash avveniva sotto il logger di Nextcloud stesso. Causa: la config ripristinata aveva riattivato files_antivirus in modalità socket, puntando a un socket del demone ClamAV che esiste sulla vecchia macchina nativa ma non nel container. Soluzione: disattivare l’app (questo stack fa invece scansioni batch notturne). Diagnosticato solo accorgendosene, non grazie a una riga di log. Subdolo.
2. La prigione di Let’s Encrypt 🔒
Il DNS non puntava ancora alla nuova macchina, quindi cert-manager aveva passato giorni a fallire nell’emissione dei certificati. Quando finalmente ho cambiato il DNS, i certificati continuavano a non essere emessi. Perché? Dopo abbastanza fallimenti, cert-manager parcheggia il Certificate in un back-off esponenziale salvato nello status dell’oggetto — prossimo tentativo programmato a ~24 ore di distanza. Riavviare il controller? Ignorato. Cancellare il secret? Ignorato. La mossa che funziona davvero: cancellare l’oggetto Certificate e lasciare che l’ingress-shim lo ricrei da zero, senza storia di fallimenti → emissione immediata.
Trappola bonus: il controllo HTTP-01 di Let’s Encrypt preferisce IPv6. Se sposti solo il record A e ti dimentichi l’AAAA, la validazione continua a colpire il vecchio host e a fallire mentre tutto “sembra” cambiato. Spostali entrambi. Sempre entrambi.
L’evento principale: la casella che mentiva ☑️
Questa è quella che mi ha fatto grattare la testa più a lungo. Collabora (Nextcloud Office) si rifiutava di aprire i documenti: “Nextcloud Office could not be loaded.” Nel frattempo il test di connettività di Office nel pannello di amministrazione era rassicurantemente verde: “Collabora Online server is reachable.” Lato server tornava tutto — discovery 200, capabilities 200, certificati validi, URL WOPI corretto, header WebSocket presenti, identico a un host di riferimento sicuramente funzionante.
La differenza si è rivelata un’unica impostazione portata dal vecchio server: “Disable certificate verification (insecure)” era spuntata (disable_certificate_verification=yes in richdocuments). Sulla vecchia macchina aveva senso — certificati autofirmati. Ma ora, con certificati Let’s Encrypt validi, quella modalità “insecure” rompe la sessione WOPI del documento in richdocuments 11.x — lasciando perfettamente verde il test di connettività dell’admin, perché quel test usa un percorso di codice diverso dall’handshake vero del documento.
Perché penso che fosse lei la colpevole? Perché la soluzione è stata esattamente quella: togliere la spunta (cancellare la chiave), riprovare, e i documenti si sono aperti subito. La mia teoria: il percorso insecure/no-verify e lo scambio di token WOPI non vanno d’accordo appena entra in gioco un TLS vero, e il fallimento emerge solo nella sessione dell’editor — la classica situazione “l’health check è verde ma la funzione è morta” che mantiene umili i sysadmin. Con lei sono andate via altre due chiavi residue della vecchia produzione (public_wopi_url, doc_format), allineandosi alla config minimale dell’host di riferimento.
La falsa pista: “perché ci sono così tante app disattivate?” 🎣
Dopo l’upgrade, un mucchio di app risultava disattivato (dashboard, comments, external storage, …) e mi sono preparato a una maratona di riallineamento. Poi ho confrontato l’insieme attuale di app con lo stato del vecchio server (estratto dal dump del DB pre-upgrade). Colpo di scena: erano disattivate anche sulla vecchia macchina. La nuova istanza corrispondeva già alla produzione. L’unica vittima vera era metadata, che semplicemente non ha una versione compatibile con Nextcloud 34. A volte il diff che fa paura è solo… la verità.
Nativo vs. container: la parte onesta ⚖️
La nuova istanza sembra un filo più lenta di quella nativa. RAM e CPU si annoiano (margine in abbondanza), e i tempi di risposta lato server sono 50–210 ms — perfettamente sani. La differenza è architetturale: i container aggiungono passaggi (proxy dell’ingress, rete overlay, PHP-FPM↔nginx sulla rete dei pod, DB a cavallo del confine pod/host). Per richiesta sono millisecondi; sulle tante richieste che una pagina Nextcloud spara, si sommano in un “un po’ meno scattante”. È la tassa che paghi per riproducibilità, isolamento e upgrade indolori — e per una piccola organizzazione è uno scambio che vale la pena fare.
La grande pulizia del database 🗃️
Ripristinare un database da un vecchio server si porta dietro tutta la sua storia. L’indice della file cache conteneva i percorsi dei file del vecchio server sotto ID di storage superati — più un pacchetto OnlyOffice rimosso da tempo le cui 276k righe d’indice erano sopravvissute all’app. Risultato netto: una tabella oc_filecache con 1.053.373 righe, di cui ~il 93% era peso morto, e un database da 1 GB.
La pulizia, fatta con attenzione con un backup e valori di controllo (i file reali degli utenti e il numero di utenti non devono cambiare): eliminare le 7 tabelle orfane di OnlyOffice, cancellare i due storage obsoleti (il vecchio percorso nativo e una mappatura di container precedente) dopo aver verificato che contenessero zero file reali — solo app-data rigenerabili — poi OPTIMIZE per restituire al filesystem le pagine liberate. Risultato:
oc_filecache rows:  1,053,373  →  72,580
database size:          1 GB   →  282 MB   (-72%)
real user files:       56,183  →  56,183   (unchanged ✔)
users:                    151  →  151      (unchanged ✔)
E sul disco: 27 GB di miniature di anteprima orfane il cui indice era appena stato cancellato. Le anteprime sono una pura cache rigenerabile — cancellare l’albero orfano recupera lo spazio e Nextcloud ricostruisce le miniature su richiesta. (La lezione da una prova generale precedente: mai re-indicizzare le anteprime orfane — così si rispalano solo ~500k righe morte nella tabella che hai appena pulito. Cancellale invece.)
Gremlin bonus: i grafici di rete vuoti 📉
node_exporter riportava allegramente CPU, RAM e disco a Grafana — ma ogni pannello Network Traffic restava ostinatamente vuoto. La metrica node_network_receive_bytes_total semplicemente non c’era. L’indizio stava in node_scrape_collector_success{collector="netdev"} 0 e nella riga di log:
netdev: "couldn't get netstats: socket: address family not supported by protocol"
Il node_exporter moderno legge le statistiche delle schede di rete tramite un socket netlink — e l’hardening systemd del servizio aveva RestrictAddressFamilies=AF_INET AF_INET6, che vieta in silenzio AF_NETLINK. Il collector fallisce senza dire niente, la metrica non compare mai, il grafico resta vuoto. Aggiungi AF_NETLINK alla allow-list, reload, restart — e le curve del traffico prendono vita. (Déjà vu bonus: la stessa identica dimenticanza di AF_NETLINK aveva già morso l’hardening di MariaDB in questo progetto. La sandbox dà sicurezza e toglie netlink.)
Guardare la macchina che pensa 📊
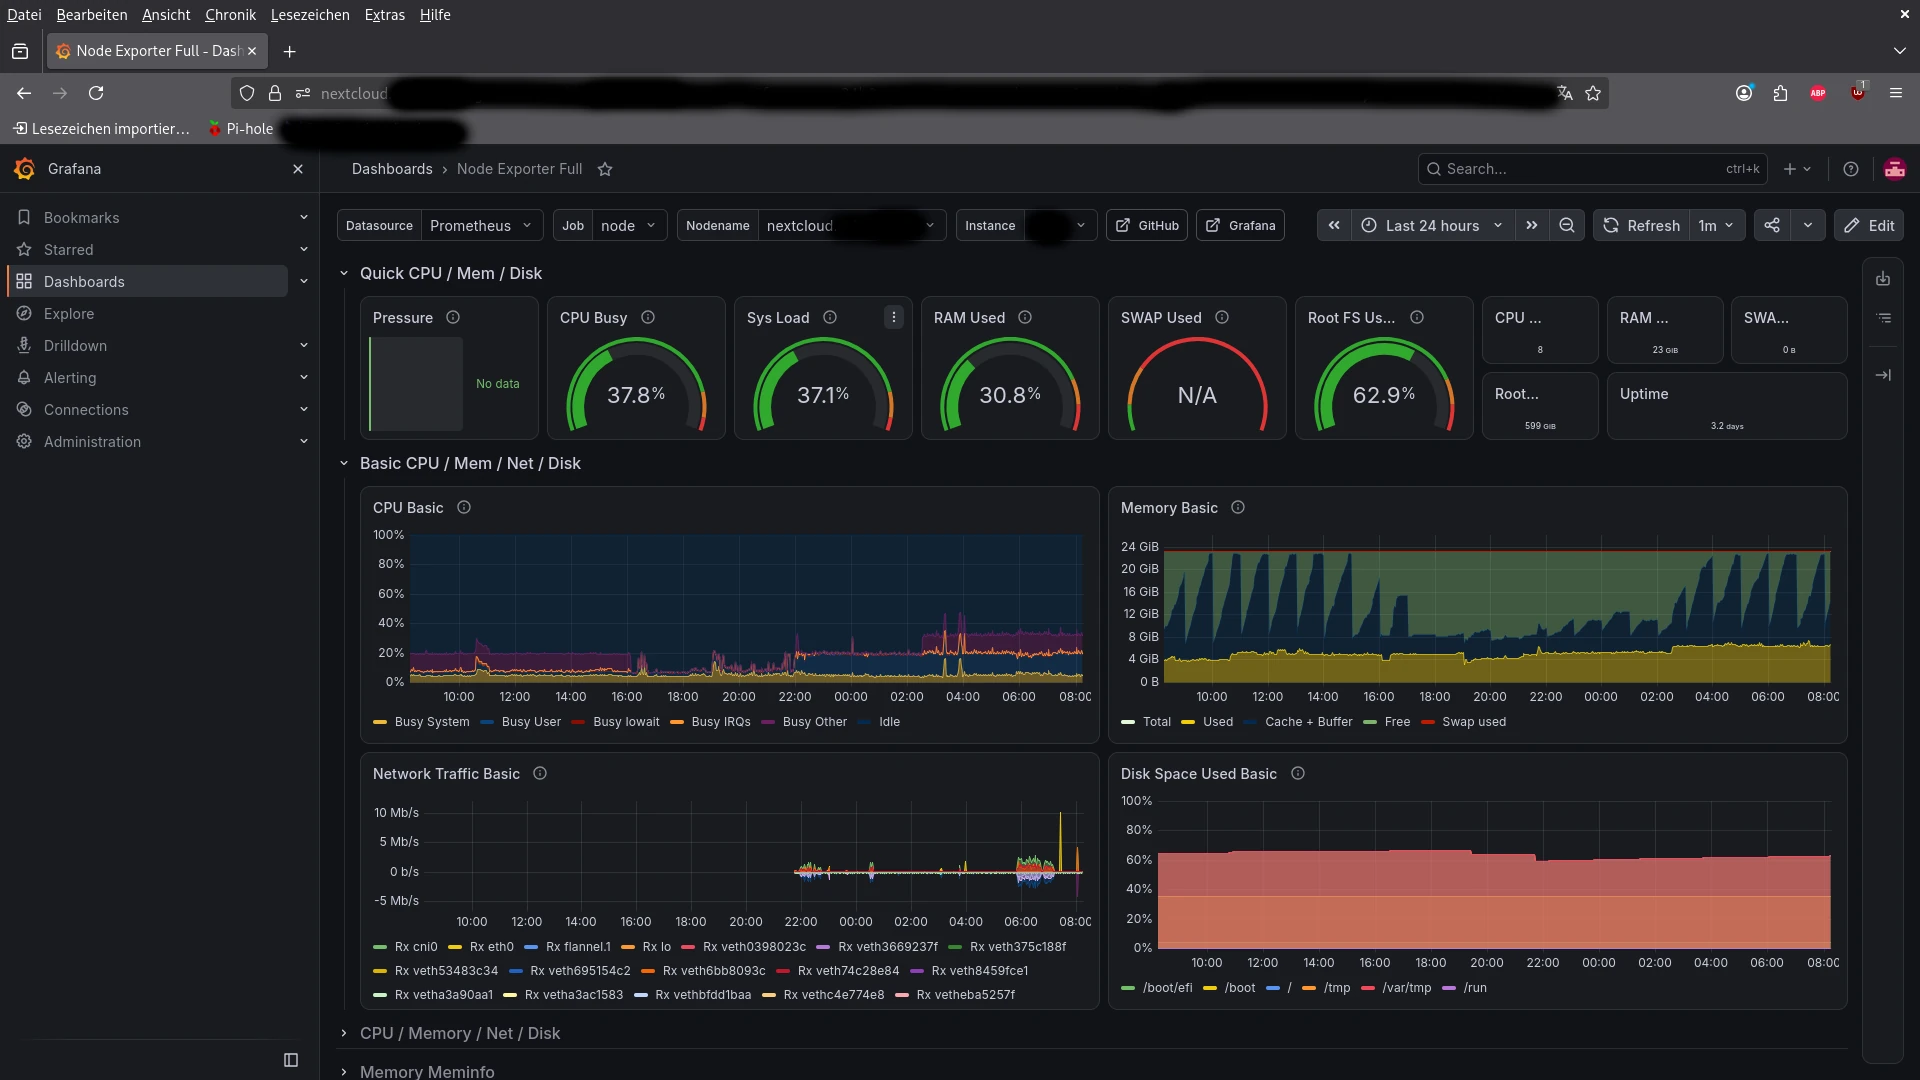
Due mosse di manutenzione collegate hanno completato il quadro. Prima ho cancellato i 27 GB di miniature di anteprima orfane (il loro indice era già sparito con la pulizia del DB qui sopra) — le anteprime sono una pura cache, quindi nessun danno. Poi, invece di far pagare a ogni primo tester la tassa del “genero questa miniatura mentre aspetti”, ho lanciato una rigenerazione completa con occ preview:generate-all. Quel job ha macinato tutta la notte, masticando ~35.000 immagini, PDF e video — la dashboard qui sopra lo coglie sul fatto, e lo scanner qui sotto è quella stessa esecuzione che ricostruisce le anteprime file per file.
Il che porta a una piccola confessione: non avevo mai avuto una dashboard del genere. Vedere CPU, carico, memoria e — ora che il gremlin del netlink è sistemato — il throughput di rete in tempo reale è stranamente appagante. Sono davvero curioso di vedere come sarà nell’uso quotidiano: avrò dei bei picchi puliti quando qualcuno carica in massa un intero servizio fotografico, o un gruppo scarica una galleria intera? Non lo so ancora — ed è metà del divertimento. Richiedimelo tra una settimana, quando avrò fissato questi grafici abbastanza a lungo da avere opinioni su percentili che non sapevo di avere. 😄
Postfazione: probe che riavviano davvero un pod inchiodato 🩺
Dopo un giorno sono tornato a sistemare una cosa che mi tormentava. I pod avevano readiness probe — Kubernetes sapeva quando non mandare traffico — ma il loro controllo di liveness era lo sdentato kill -0 1, che se ne accorge solo quando il PID 1 è già morto (a quel punto il container è comunque andato). Un processo ancora in esecuzione ma inchiodato — FPM bloccato, che non accetta più connessioni sul suo socket — sarebbe rimasto lì, rotto, finché un umano non se ne fosse accorto. Su un pod con una sola replica è proprio il caso che vuoi gestito in automatico.
La soluzione è un vero setup a tre probe su ogni container: una startupProbe che tiene ferme liveness e readiness finché l’app non ascolta davvero (fino a ~10 minuti di tolleranza, così un occ upgrade lento o una raffica di anteprime all’avvio non fanno mai scattare un loop di riavvii), una readinessProbe che regola il traffico, e una livenessProbe stretta — un vero connect tcpSocket, non un controllo del PID — che riavvia il container solo quando smette davvero di rispondere. Il cancello dell’avvio è il pezzo portante: senza di esso, una liveness probe abbastanza severa da beccare un blocco giustizierebbe anche un container che si sta semplicemente avviando con calma. Il blog gira sullo stesso stack, quindi ha ricevuto lo stesso identico trattamento per coerenza.
Postfazione: tarare sul ferro 🎛️
Una volta posata la polvere, è cominciata la parte divertente: guardare le nuove dashboard Grafana e tarare in base a quello che mostravano davvero, invece che a quello che avevo ipotizzato. La macchina si è rivelata avere molto più margine di quanto pensassi — 8 core, 23 GB di RAM, ~16 GB liberi a riposo — quindi ho smesso di fare il tirchio. Collabora è passato da 4 a 6 processi figli pre-forkati, e i suoi limiti da 3 a 6 GB e da 2 a 4 core, il che smussa l’occasionale singhiozzo di avvio a freddo la prima volta che qualcuno apre un documento dopo un periodo di inattività. Insieme sono arrivati altri ritocchi: filesystem root in sola lettura sui sidecar, un livello di log più sensato (solo-fatal nasconde proprio gli avvisi che vuoi vedere), e insegnare a node_exporter a smettere di riportare tre dozzine di interfacce virtuali dei container, così il grafico di rete mostra l’unica scheda che conta. Sta tutto nello stesso repo Ansible — riproducibile, versionato e noioso nel miglior senso possibile.
Indossare il cappello nero 🕵️
Prima di dichiararlo finito, ho fatto quello che ogni admin paranoico dovrebbe fare: ho attaccato la mia istanza dall’esterno. Niente port scan — a parte le porte web e una porta SSH solo-chiavi, il firewall scarta tutto in silenzio, quindi c’è poco da trovare — solo le richieste che un vero opportunista spara a un Nextcloud appena messo online, a caccia di un punto debole. In breve: non ce n’erano.
Ogni percorso sensibile è tornato con un secco 403 — config/, data/, .htaccess, .git/, 3rdparty/, tutto quanto. WebDAV e remote.php pretendono l’autenticazione (401) prima di dire qualsiasi cosa. L’header Server è un laconico nginx senza versione, niente X-Powered-By, nessuna impronta PHP da confrontare con un elenco di CVE. Il TLS è 1.3 con un certificato Let’s Encrypt valido; 1.0 e 1.1 vengono rifiutati d’ufficio. C’è il set completo di header di sicurezza — HSTS con preload, una CSP basata su nonce, nosniff, policy per frame e referrer, una permissions policy blindata e cookie __Host-. Il controllo d’integrità del codice di Nextcloud stesso riporta zero file modificati.
La parte che mi sta più a cuore: il throttling contro il brute force è attivo e — siccome la catena del reverse proxy inoltra correttamente il vero IP del client — rallenta l’attaccante, non il mio stesso ingress. È il modo di fallire che neutralizza in silenzio il rate limiting in un sacco di setup dietro proxy, quindi vale la pena verificarlo invece di darlo per scontato. Niente di tutto questo è esotico; sono per lo più i default noiosi e corretti più qualche tocco deliberato. Ed è proprio questo il punto — la cosa più scoraggiante che un attaccante possa trovare è un muro senza giunture. 🧱
Terzo giorno: legare i fili sciolti 🧹
La maratona delle anteprime di cui sopra è finalmente terminata all’alba del terzo giorno, dopo ben più di un giorno passato a masticare l’intera libreria. Con niente che scrivesse più nell’indice dei file, la manutenzione rimandata poteva girare — e un controllo completo end-to-end dopo ha fatto emergere due gremlin che si nascondevano in bella vista.
Le tabelle “vuote” che non lo erano
I miei appunti dicevano che le tabelle residue di app sparite da tempo (Talk, Polls, Collectives, Maps) erano vuote e pronte da eliminare. Prima di eliminare qualsiasi cosa ho contato comunque le righe. Non erano vuote: un paio di dozzine di pagine wiki, qualche sondaggio con voti, diverse dozzine di stanze di chat. Al momento nessuno può vederle, perché le app non sono installate — ma reinstalla un’app e lei si riprende subito le sue vecchie tabelle. Quindi restano. Cosa se n’è andato: gli ultimi resti su disco di OnlyOffice (prima archiviati, poi cancellati), più un OPTIMIZE completo che ha schiacciato la frammentazione da 59 MB a 2 MB in 17 secondi. Lezione: fidati del conteggio delle righe, non del tuo riassunto di ieri.
Push, non poll: notify_push 📡
I client di sincronizzazione di Nextcloud normalmente chiedono al server ogni ~30 secondi: “novità?” L’app notify_push (Client Push) ribalta la cosa — un piccolo demone Rust tiene aperto un WebSocket e il server annuncia le modifiche nel momento in cui avvengono. (Non c’entra niente con le notifiche sul telefono; quelle passano dal push proxy di Nextcloud e hanno sempre funzionato.) Su una macchina nativa sono tre pezzi: l’app, un servizio systemd e una location /push/ nel web server. Su K3s sono gli stessi tre pezzi con altri vestiti: l’app, un suo Deployment e una route dell’Ingress.
Il lato Ansible l’avevo costruito il giorno prima, spento. Rivederlo prima di girare l’interruttore ha fatto trovare quattro bug che avrebbero prodotto il peggior risultato possibile — un’esecuzione del playbook verde e una funzione morta, perché ogni passo era impostato per tollerare i fallimenti. occ girava come root (Nextcloud si rifiuta). Il binario veniva scelto con un glob — e in ordine alfabetico aarch64 viene prima di x86_64. Il container girava come root con tutte le capability rimosse, il che sembra sicuro finché non ti rendi conto che root senza CAP_DAC_OVERRIDE non può leggere un file 0640 di proprietà di www-data — come config.php. E l’ingress passava /push/… invariato, mentre il demone si aspetta /ws alla sua radice.
Anche con tutti e quattro sistemati, il primo self-test è tornato con un 404 — renderizzato da Nextcloud. La route esisteva; nginx semplicemente non la sceglieva mai. Le route di Nextcloud sono una regex catch-all, location ~ "^/", e in nginx una regex batte un semplice prefisso. Quindi anche la route del push doveva diventare una regex — e continuava a perdere, perché il controller dell’ingress emette le location regex in ordine alfabetico del nome dell’Ingress, e nginx prende la prima corrispondenza. notify-push-routes viene dopo nextcloud-routes; rinominata in nextcloud-push-routes (“p” prima di “r”), vince. Non è la correzione di cui vado più fiero, ma è documentata. Tutti e sei i self-test sono diventati verdi, e la prima sessione del browser è passata a un WebSocket (HTTP 101) e ha ricevuto i suoi primi eventi sui file. Verdetto onesto: per una manciata di client desktop è un di più carino — le modifiche arrivano in pochi secondi invece che fino a mezzo minuto — non una svolta.
Gremlin n. 1: l’hardening che ha buttato giù il database
Mentre un’esecuzione del playbook era in corso, Nextcloud ha risposto per poco 500. MariaDB era stato fermato — in modo pulito, nessun crash. Il journal ha raccontato la storia: due secondi prima, il ruolo di hardening del sistema operativo aveva rimosso il pacchetto rsync come “inutilizzato su questo host”. Era vero sull’host del blog, dove era stato verificato. Sull’host di Nextcloud, il pacchetto MariaDB-server richiede rsync — i suoi strumenti per il cluster Galera includono uno script di state transfer basato su rsync, anche su un singolo nodo che non entrerà mai in un cluster. Quindi dnf ha diligentemente rimosso MariaDB insieme a lui, il che ferma il servizio; un ruolo successivo li ha reinstallati entrambi, e un altro ha riavviato il database. Effetto netto: due o tre minuti di downtime a ogni singola esecuzione del playbook, invisibili a meno di guardare proprio nel momento giusto. La correzione è un’unica condizione: rimuovere rsync solo se rpm -e --test rsync dice che niente dipende da lui. “Verificato sull’host A” non è “vero sull’host B”.
Gremlin n. 2: gli allarmi che non potevano mai scattare
Le regole di allarme di Grafana — disco, memoria, CPU, nodo giù — sembravano perfette nell’interfaccia. Nel log, ognuna falliva a ogni valutazione con condition must not be empty: il codice di provisioning non diceva mai a Grafana quale query decide l’allarme. E siccome le regole trattavano gli errori di valutazione come “OK”, niente diventava mai rosso. Un campo mancante, "condition": "B", e ora vengono valutate come si deve. Un allarme che non può scattare sembra esattamente un sistema sano — il tipo di verde più pericoloso che ci sia. (Gli allarmi via mail di base con Monit erano attivi tutto il tempo, quindi la macchina non volava completamente alla cieca.)
Gremlin n. 3: il ban per port scan che non c’era
Una versione precedente proprio di questo post sosteneva che un port scan “ti fa guadagnare un timeout istantaneo di fail2ban”. Non era così. fail2ban reagisce solo alle righe di log, e il firewall registra i pacchetti scartati a un ritmo volutamente minuscolo, quindi una scansione spariva semplicemente nella policy di drop predefinita. Innocuo, ma non veniva bannato nessuno. Il firewall aveva persino una coppia di set etichettati “port-scanner blocklist”, e niente che riguardasse le scansioni li riempiva mai. Ora la correzione vive nel kernel: l’ultima regola prima del drop finale conta i tentativi di connessione per sorgente, e vede solo i pacchetti diretti a porte chiuse, quindi il traffico normale non viene mai contato. Una sorgente che continua a bussare viene scartata su tutte le porte per un po’. Niente log, niente demone, niente parsing.
Il rollout ha fatto emergere un’altra trappola. Il servizio nftables standard ricarica con flush ruleset, e sull’host di Nextcloud anche kube-proxy, flannel e Calico tengono le loro regole in nftables. Quindi ogni modifica al firewall aveva anche cancellato la rete di Kubernetes stessa, per fino a un minuto e mezzo, finché non si risincronizzava. Ora il ruleset sostituisce solo la propria tabella, in un unico passo atomico.
Dal quarto al sesto giorno: leggere i log come un detective 🔎
Una volta posata la polvere, il lavoro è passato da “farlo funzionare” a “continuare a tenerlo d’occhio”. Per un paio di giorni la routine è stata semplice: leggere nextcloud.log, i log dei container e il log dell’ingress, e per ogni riga che sembrava strana chiedersi perché finché non c’era una risposta. Una condizione preliminare l’ha resa possibile: il livello di log era stato alzato da 4 (solo fatal) a 2 (avvisi). Al livello 4, niente di quanto segue sarebbe comparso. Un log silenzioso non sempre è un server sano. A volte è solo un server col microfono spento.
Gremlin n. 4: la jail che guardava un file morto
fail2ban girava, le jail di nginx erano “attive” e la lista dei ban era vuota. Per giorni. Settimana tranquilla o jail rotta? Il controller dell’ingress scrive il suo access log in un file il cui nome finisce con un contatore (…/0.log, 1.log, …), e ogni riavvio del container ne inizia uno nuovo. fail2ban espande il glob di logpath solo quando la jail parte. Dopo un riavvio fail2ban si avvia prima del container dell’ingress, si aggancia al vecchio file e poi segue fedelmente un log in cui non scrive più nessuno, su entrambi gli host. La correzione è un piccolo timer systemd che si accorge quando cambia l’insieme dei file di log dell’ingress (e una volta dopo ogni avvio) e ricarica solo le jail di nginx. Uno strumento di sicurezza che riporta “tutto tranquillo” perché sta guardando il file sbagliato è peggio di niente, perché pensi di essere coperto.
Gremlin n. 5: il ping-pong delle proprietà
A ogni esecuzione del playbook, lo status.php di Nextcloud andava brevemente in errore e la directory dei dati falliva il suo controllo di scrivibilità, per poi guarire da sola più avanti nella stessa esecuzione. Il colpevole erano due ruoli in disaccordo. Il ruolo SELinux creava le directory hostPath come root:root, e il ruolo di deploy le impostava a 33:33 (www-data). Ogni esecuzione rimbalzava la proprietà avanti e indietro, e finché il ruolo successivo non la rimetteva a posto, Nextcloud si trovava davanti una directory dei dati in cui non poteva scrivere. Ora entrambi i ruoli impostano lo stesso proprietario e gli stessi permessi, e il ping-pong è finito. Due ruoli che fanno ognuno qualcosa di “corretto” possono comunque sommarsi in un bug.
Gremlin n. 6: le anteprime di Office e il muro di 1 MB
I file Word ed Excel piccoli avevano belle miniature nell’elenco dei file, quelli più grandi no. Nessun errore nell’interfaccia, solo l’icona generica. Il log dell’ingress aveva la risposta: 413 Request Entity Too Large a ogni chiamata convert-to a Collabora. Nextcloud genera le anteprime di Office caricando il documento su Collabora, e il limite predefinito di nginx per il corpo della richiesta è 1 MB. La route di Nextcloud aveva un limite generoso, ma la route di Collabora non l’aveva mai avuto. Una sola annotation (client-max-body-size: 2g) ha risolto, e le anteprime interessate si possono semplicemente rigenerare. I pochi errori convert-to rimasti sono documenti che Collabora davvero non riesce ad aprire, il che è un problema del file e non della configurazione.
Gremlin n. 7: la foto da 108 megapixel
Alcune foto restavano senza miniatura, e l’app continuava a ricevere un 404 per le loro anteprime. Venivano tutte da un unico telefono, con 108 megapixel e 12.032 pixel di larghezza. Decodificare un’immagine di quelle dimensioni richiede circa 430 MB di RAM, e il preview_max_memory di Nextcloud vale di default 256 MB. Oltre quel valore, Nextcloud non ci prova nemmeno. Salta l’anteprima in silenzio. Alzato a 512 (il limite di PHP stesso è molto più alto), e le foto hanno finalmente avuto le loro miniature.
Già che c’ero, anche le foto HEIC degli iPhone hanno avuto le anteprime. È una riga in enabledPreviewProviders, con un tranello: impostare quella chiave sostituisce l’elenco predefinito integrato invece di estenderlo, quindi i default (PNG, JPEG, GIF, testo, OpenDocument…) vanno ripetuti, altrimenti ti ritrovi con le anteprime HEIC e senza quelle JPEG. Quello che ora resta senza anteprima sono dati, non configurazione: qualche dozzina di avanzi da 400 byte di un upload fallito anni fa, alcuni file vuoti e una manciata di PNG più grandi di 50 MB.
Gremlin n. 8: la config che non arrivava mai
Verificare la correzione precedente dopo un’esecuzione del playbook ha fatto emergere qualcosa di peggio. I nuovi valori erano nella ConfigMap di Kubernetes, ma il custom.config.php dentro il pod in esecuzione era vecchio di un giorno. Il file è montato con subPath, e un mount subPath viene copiato una volta all’avvio del container e mai aggiornato. Kubernetes aggiorna dal vivo i volumi ConfigMap normali, ma non quelli subPath. Quindi ogni modifica di configurazione nel repo diventava effettiva solo al successivo riavvio accidentale del pod. (Nel frattempo la correzione delle anteprime funzionava solo perché era stata impostata anche via occ.)
La soluzione standard è un’annotation checksum/config sul template del pod: uno SHA-256 dei template di configurazione renderizzati. Cambi la config e cambia l’hash, il che fa rifare a Kubernetes il rollout del pod. Lasci stare la config e non succede niente. Il blog ha ricevuto lo stesso trattamento per le sue config di nginx e PHP. Lezione: “il playbook è girato verde” e “l’impostazione è attiva” sono due affermazioni diverse, quindi controlla il file dentro il container.
Com’è fatto un log sano 🩺
Dopo tutto questo, la revisione quotidiana è diventata noiosa, ed è proprio l’obiettivo. Una giornata tipo ora ha una manciata di righe in nextcloud.log: un’anteprima che non si è potuta aprire, un notice di PHP. Il resto è rumore che vale la pena conoscere a memoria, così non ti manda a caccia ogni mattina:
- Collabora “Broken pipe” / “Connection reset”, circa 60 all’ora, anche alle 3 di notte: l’altra parte ha chiuso la connessione prima che Collabora finisse di scrivere. Innocuo.
- nginx “access forbidden” su
/data/.ncdatae/.env: il primo è il controllo di sicurezza di Nextcloud stesso che verifica che la directory dei dati non sia raggiungibile dal web, il secondo è un bot. Entrambi bloccati di proposito. - “config differs from the latest version of this image” a ogni avvio del pod: quei file li gestisce il ruolo stesso (Redis con password, per esempio), quindi è previsto che siano diversi.
- notify_push “Self test failed” subito dopo un riavvio: il controllo TLS fallisce una volta con un errore di certificato (molto probabilmente l’ingress che per qualche secondo serve ancora il suo certificato di default prima che venga caricato quello vero). Un minuto dopo il self-test è verde 6/6.
Il senso di quell’elenco non sono le voci in sé. Una volta che sai com’è fatto l’innocuo, l’unica riga che non è innocua salta subito all’occhio. È tutto qui il trucco del monitoraggio dei log. Non è magia, è conoscere la linea di base.
Verdetto ✅
È online. Certificati validi, la modifica dei documenti Office funziona, dati intatti, utenti che non si sono accorti di niente. La migrazione in sé è stata il facile 20%; l’altro 80% è stata una caccia al tesoro di impostazioni e comportamenti che si comportano male solo esattamente nelle nuove condizioni. Come sempre: il problema non è mai stato il server — erano le supposizioni. 😄
Il terzo giorno ci ha aggiunto una nota a piè di pagina. I bug più cattivi non erano quelli che andavano in crash — erano quelli che restavano verdi: una casella, un playbook tollerante ai fallimenti, una regola d’allarme che non poteva scattare. Se questa migrazione mi ha insegnato un’abitudine, è controllare la cosa in sé, non la cosa che riferisce su di essa. 🔍
Un’ultima cosa: questo non è stato il mio unico rodeo con Nextcloud. Gestisco anche una seconda istanza di produzione come volontario — più piccola, con meno dati e meno utenti registrati — e tutto quello che ho imparato qui si è rivelato davvero utile. Quindi la prossima è quella: la migrerò sullo stesso stack K3s entro le prossime due settimane, sperando di pestare molte meno di queste mine la seconda volta. 🤞
L’intero stack Ansible dietro tutto questo — i ruoli WordPress e Nextcloud, l’ingress, cert-manager, il monitoraggio e ogni trucco di hardening citato sopra — vive su GitHub, con secret e dettagli degli host rimossi: github.com/aptupgrademe/www_k3s. Questa migrazione è la milestone v3.0.0, così puoi sfogliare lo stato esatto descritto in questo post invece di qualsiasi cosa sia HEAD oggi.
📚 Altro in questa serie: Nextcloud da bare metal a K3s