
L’iLO conosce la temperatura, ma non quella di ieri: costruire uno storico del calore per il rack del mio homelab
🌐 Anche in: English · Deutsch · Français · Español · Português · Nederlands · Polski
Tutto è iniziato con una domanda semplice in un pomeriggio pigro: quanto sono caldi, in realtà, i miei tre server? L’iLO ha risposto all’istante: aria in ingresso tra 22 e 25 °C, ventole al minimo al 6 %, tutto verde. Ottimo. Poi la domanda successiva: e durante l’ondata di caldo di luglio? Silenzio. L’iLO 5 mostra temperature e ventole solo in tempo reale. Niente storico, niente grafico, niente “martedì scorso”. Così me ne sono costruito uno, ed è su GitHub: aptupgrademe/ilo-thermal.
Stesso flusso di lavoro di sempre: io faccio le domande e prendo le decisioni, il mio co-amministratore IA (Claude) legge gli iLO via Redfish, scrive il codice e ricontrolla ogni numero di cui sta per fidarsi. Quest’ultima parte si è rivelata più importante del previsto.
Indice
🌡️ Primo sguardo: quale sensore significa davvero qualcosa?
Un iLO 5 su un DL20 Gen10 Plus espone una dozzina circa di sensori di temperatura. Non tutti sono utili, e due di loro mentono.
| Sensore | HP1 | HP2 | HP3 | Verdetto |
|---|---|---|---|---|
| 01-Inlet Ambient | 24 °C | 25 °C | 22 °C | Quello che conta: l’aria aspirata sul davanti |
| BMC (chip dell’iLO) | 69 °C | 71 °C | 77 °C | Sembra spaventoso, non lo è: autoriscaldamento del chip, limite 110 °C |
| CPU 1 | 40 °C | 40 °C | 40 °C | 🤨 identico su tutti e tre, con carico allo 0 % e all'11 % |
| AHCI HD Max | 40 °C | 40 °C | 40 °C | 🤨 stessa storia |
Tre server, carichi diversi, esattamente 40 °C ovunque? Puzzava di valore segnaposto, quindi abbiamo controllato i dischi da Windows via SMART: da 31 a 35 °C. L’iLO semplicemente non sa leggere dischi non HPE e ci mette una costante. Lezione numero uno: verifica un sensore prima di costruirci sopra degli allarmi.
🗺️ La mappa dei sensori: il davanti è y = 1, il retro la y più alta
La domanda successiva era quella interessante: mi accorgerei mai di un accumulo di calore dietro il rack? Questi modelli non hanno un sensore sull’uscita dell’aria. Ma il Redfish di HPE ti dice dove si trova ogni sensore: Oem.Hpe.LocationXmm e LocationYmm formano una griglia in cui y = 1 è l’aspirazione frontale e la y più alta il fondo del retro; x è la posizione lungo la larghezza. Nonostante il “mm” nel nome, sono celle della griglia, non millimetri: i valori vanno solo da circa 1 a 14 su un server largo 43 cm. Quanto è profonda la griglia dipende dal modello: sui DL20 la fila posteriore è y = 13–14, sul più compatto MicroServer la griglia finisce a y = 13. Sul retro ci sono due tipi di sensori:
- Sensori di chip (BMC, chip di rete LOM): dominati dal proprio calore, inutili per il flusso d’aria.
- Sensori di zona d’aria (
BMC Zone,PCI 1 Zone): misurano l’aria intorno a loro, con poco autoriscaldamento.BMC Zonestava a 28 °C su HP2, solo 3 °C sopra la sua aspirazione. È il mio sostituto del sensore di uscita.
Ed ecco l’intuizione chiave: la temperatura posteriore da sola non dice niente, perché segue la stanza. Un pomeriggio caldo alza davanti e dietro. Quello che rivela un accumulo è la differenza. Se retro meno davanti cresce dai suoi soliti +3 °C mentre aspirazione e carico restano uguali, l’aria calda non riesce a uscire. Il secondo indicatore precoce: ventole che accelerano anche se l’aspirazione non è più calda.
📍 Posizione, posizione, posizione: quattro gradi dal basso in alto
Le prime ore di storico hanno già reso ovvia una cosa: dove sta un server nel rack conta più di quale server sia. Stessa stanza, stesso rack, stesso carico a riposo, eppure l’aria in ingresso differisce di diversi gradi, in modo costante, in ogni singola lettura:
| Server | Posizione | Aspirazione (media) | Intervallo | Zona posteriore (media) |
|---|---|---|---|---|
| HP2 (DL20 Gen10 Plus) | in cima al rack | 25,9 °C | 25–26 °C | 28,9 °C |
| HP1 (DL20 Gen10 Plus) | al centro | 23,9 °C | 23–24 °C | 26,9 °C |
| HP3 (MicroServer Gen10 Plus v2) | vicino al fondo | 21,9 °C | 21–22 °C | 25,9 °C |
33 letture nelle prime cinque ore di una serata tranquilla; tutte le ventole al loro minimo del 6–8 %.
Dal basso verso l’alto, l’aspirazione sale a gradini puliti di due gradi: 21,9 → 23,9 → 25,9 °C. Sono quattro gradi tra il server vicino al fondo e quello in cima, con in mezzo nient’altro che l’altezza. La fisica è semplice: l’aria calda sale. L’uscita di tutto ciò che sta sotto si raccoglie in cima al rack e il server più in alto ne respira di nuovo una parte, soprattutto se il tetto del rack è chiuso o lo spazio sopra è stretto. Nota che la differenza tra retro e davanti è la stessa, +3–4 °C, su tutte e tre le macchine. I server in sé si comportano in modo identico; è l’aria che ricevono a essere diversa.
Perché è importante:
- Il server in cima raggiunge per primo ogni limite. In un pomeriggio d’estate a 30 °C, HP3 starebbe ancora comodo mentre HP2 starebbe già bussando alla soglia di avviso. Pianifica per il posto più caldo, non per la media.
- Confronta ogni server con se stesso. Un “normale” fisso per tutto il rack segnalerebbe HP2 come permanentemente sospetto. Per questo le regole di allarme usano la mediana a 7 giorni di ciascun server.
- Il posizionamento è una leva di ottimizzazione gratuita. Metti in basso la macchina che scalda di più o che conta di più, chiudi le unità rack inutilizzate con pannelli ciechi così che l’aria di uscita non possa tornare furtivamente sul davanti, e lascia respirare la parte alta del rack.
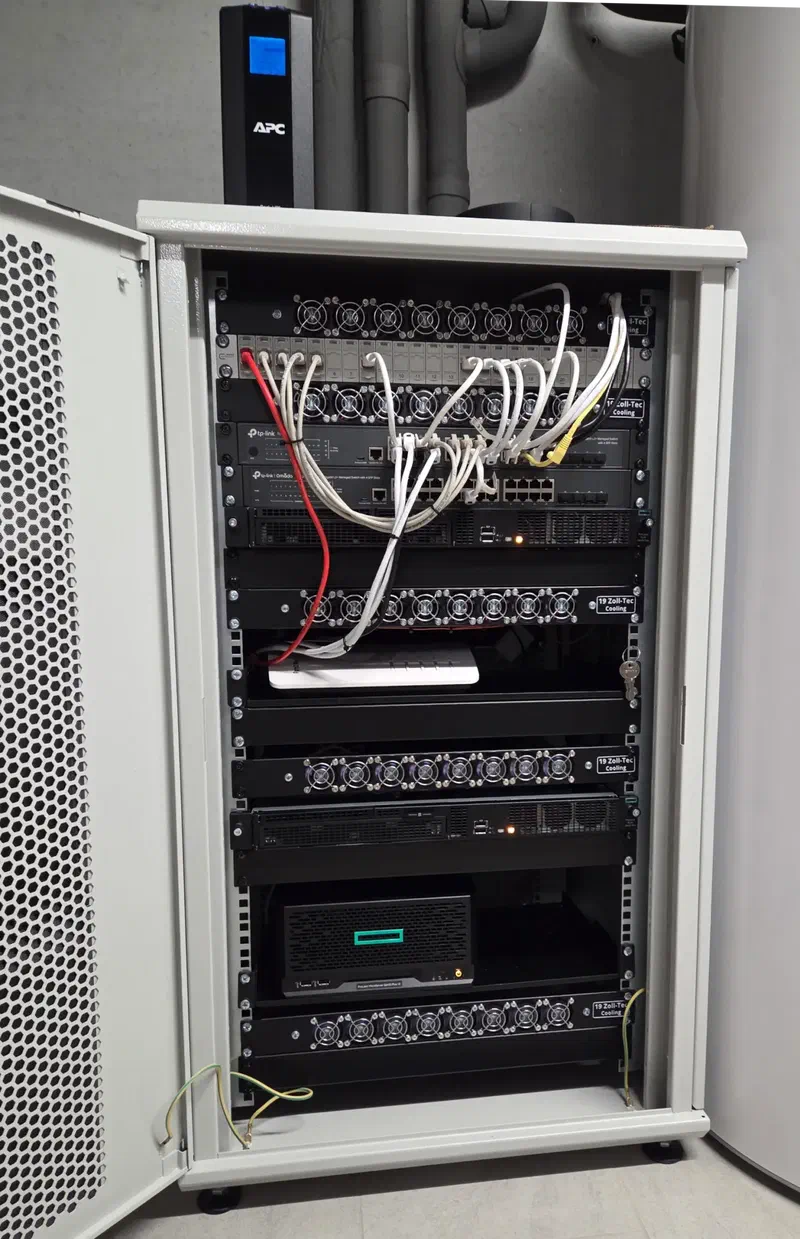
Confessione: l’avevo sottovalutato. Quando i server sono entrati nel rack, la strategia di posizionamento era, diciamo, “dove c’era uno slot libero”. La fisica del flusso d’aria non ha avuto diritto di voto. Se il rack verrà mai riprogettato, i server andranno il più in basso possibile, impilati insieme sul fondo, dove l’aria è più fresca.
Lo slot in cima, tra l’altro, ha già l’inquilino giusto: lo switch. Secondo la sua scheda tecnica è specificato per funzionare stabilmente a temperature ambiente decisamente più alte dei server, quindi può convivere con l’aria calda lassù molto meglio di un ProLiant. La regola empirica che mi porto a casa: il posto più caldo va al dispositivo che tollera meglio il calore, non a chi è arrivato per ultimo.
Innocuo a settembre. Ma ora so esattamente quale server tenere d’occhio ad agosto, e ho i numeri per dimostrare se un rack riorganizzato aiuta davvero.
🧰 Lo script: noioso di proposito
ilo_thermal.py è un singolo file Python, solo libreria standard. Niente pip, niente requests, niente matplotlib, niente che possa rompersi al prossimo upgrade della distro. Ogni 10 minuti cron lo esegue:
- Raccogliere: un
GETRedfish in sola lettura per iLO per i dati termici. Lo script si collega per IP ma verifica il certificato TLS contro la mia root CA e il nome sul certificato, perché il jump host non usa il DNS di AD. Sì, la PKI dell’homelab di un post precedente ripaga ancora una volta. - Salvare: tutto finisce in SQLite. Circa 100–150 MB per tre server e 400 giorni, un anno intero per il confronto.
- Valutare: le regole di allarme qui sotto.
- Riferire: un singolo file HTML autosufficiente con i grafici.
🚨 Quando urla?
| Regola | Attivazione |
|---|---|
| Limite di aspirazione | ≥ 30 °C avviso, ≥ 35 °C critico (HPE certifica queste macchine per 35 °C ambiente) |
| Salto di temperatura | +4 °C entro un’ora: condizionatore morto, porta chiusa, una stufetta che qualcuno ha “solo parcheggiato lì” |
| Accumulo di calore sul retro | differenza retro meno davanti ≥ la sua mediana a 7 giorni + 5 °C e ≥ 8 °C |
| Ventole senza motivo | ventole 20 punti sopra il normale mentre l’aspirazione non è più calda: flusso d’aria bloccato o polvere |
| Sensore non sano | un qualsiasi sensore o ventola che non riporta OK |
| iLO irraggiungibile | tre interrogazioni fallite di fila |
“Normale” è sempre la mediana del server stesso negli ultimi sette giorni, quindi il posto più caldo di HP2 in cima non conta come anomalia. È il normale di HP2. Queste regole basate sulla baseline si armano solo dopo un giorno di storico; un’installazione fresca non ti tempesterà di allarmi per il rumore. Gli allarmi hanno uno stato: una mail quando iniziano, un promemoria ogni 12 ore e una mail di “risolto” alla fine. Niente bombardamento a tappeto della casella di posta.
😴 Il collector dorme, l’iLO no
Ecco il problema: il mio jump host non è acceso 24 ore su 24. Le interrogazioni funzionano solo mentre gira, e dato che l’iLO non tiene uno storico delle temperature, le ore in cui era spento sono semplicemente perse. Il report le mostra onestamente come buchi invece di tracciare una linea retta fuorviante attraverso la notte.
Ma l’iLO qualcosa lo tiene: l’Integrated Management Log. Ogni evento hardware (surriscaldamento, guasto di una ventola, perdita di alimentazione, errori di memoria o PCIe) viene salvato lì con un timestamp, che qualcuno stia guardando o no. Quindi lo script si ricorda il EventNumber più alto che ha visto per ogni iLO, e una riga cron @reboot lo esegue due minuti dopo l’avvio. Tutto ciò che è più recente viene riportato con il suo timestamp originale.
Per testarlo, abbiamo riportato indietro il cursore di HP2. Lo script ha prontamente dissotterrato un Uncorrectable PCI Express Error del 23 luglio che nessuno aveva mai notato:
IML HP2 CRIT: iLO log 2026-07-23 20:29:31 UTC [PCI Bus]: Uncorrectable PCI Express Error Detected.
              (Segment 0x0, Bus 0x1, Device 0x0, Function 0x2)
Un caso isolato, mai ripetuto, ma esattamente il tipo di cosa che vuoi sapere. Due dettagli tengono il tutto sensato: la prima esecuzione imposta solo il cursore, così non ricevi l’intera biografia dei tuoi server nella prima mail. E la classe IML Network è ignorata di default, perché HPE registra ogni link down come “Critical”, e succede a ogni riavvio per le patch. (Scavando, l’IML ha anche rivelato che tutti e tre i server hanno perso il link di rete nello stesso identico secondo il 26 settembre, per 90 secondi. Non sono tre server che si guastano, è uno switch che si riavvia.)
📈 Il report
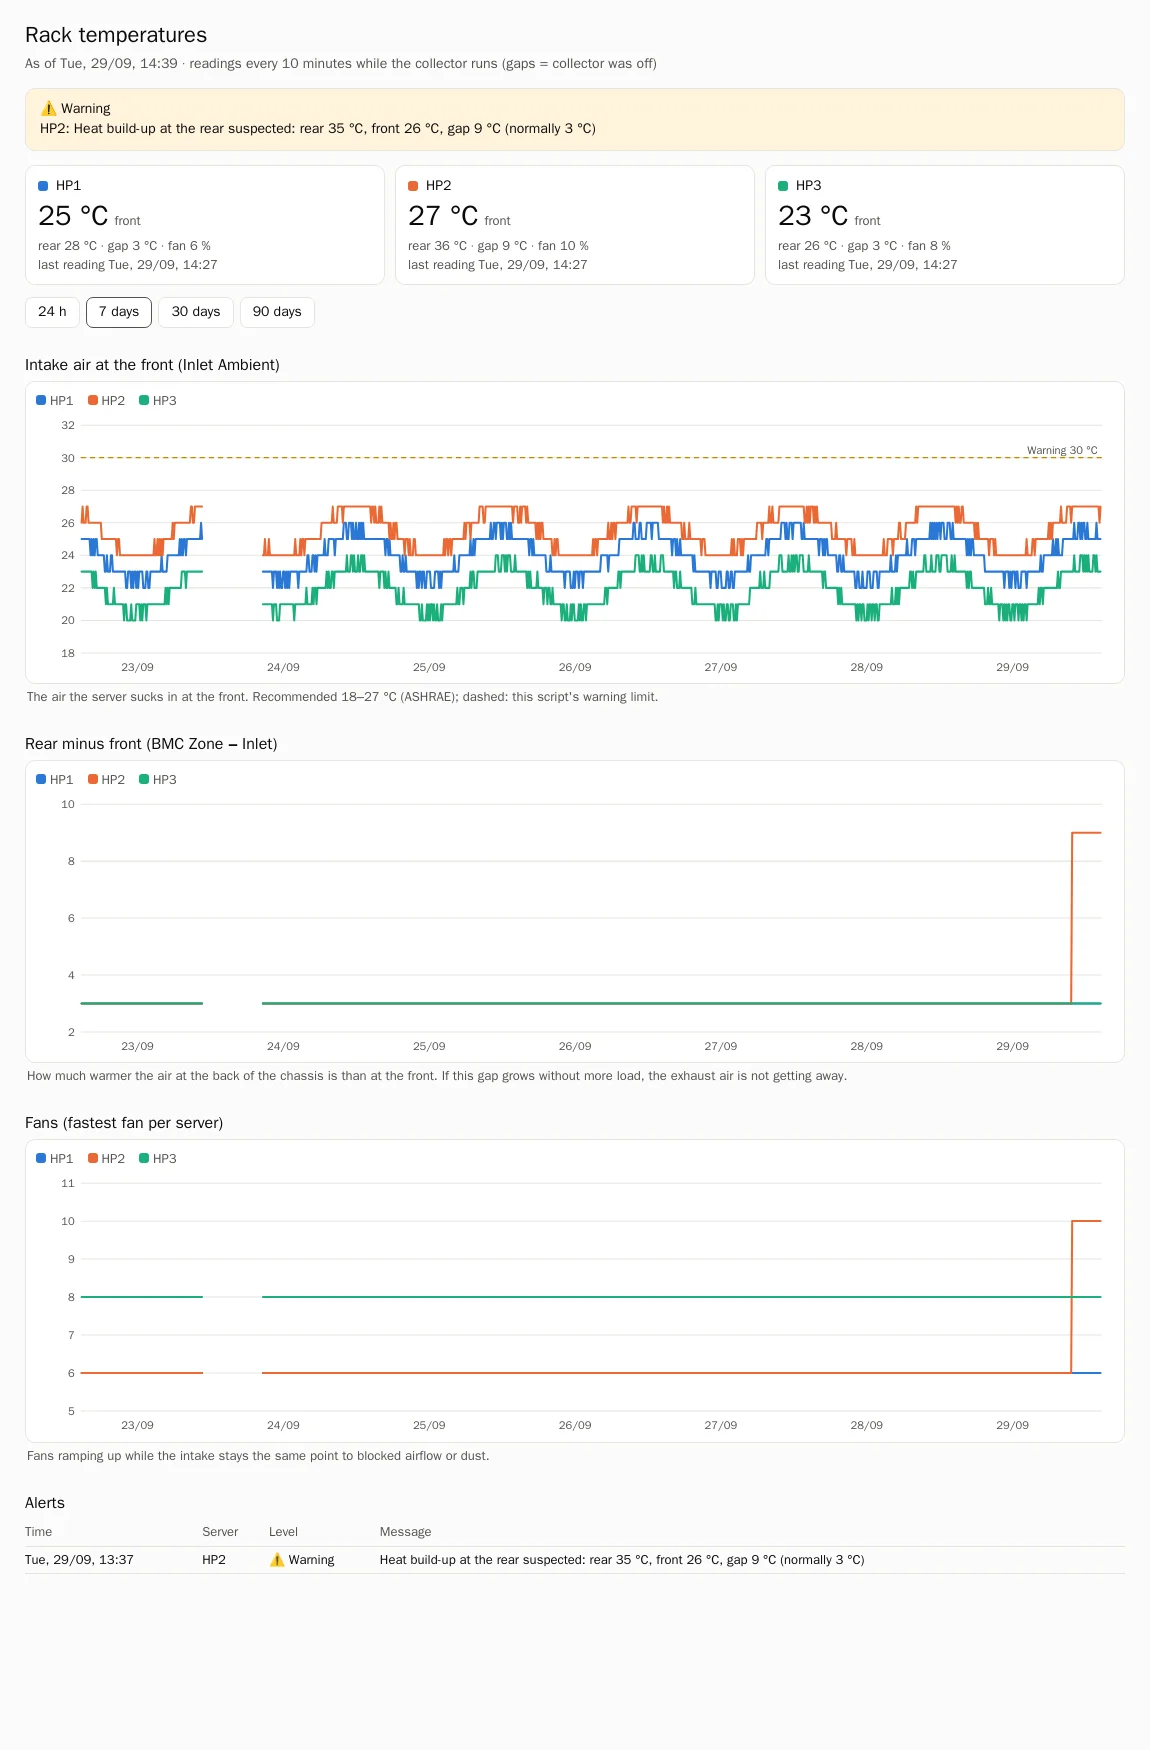
- Tre grafici: aria in ingresso (con la linea di avviso), differenza retro meno davanti, ventole. Una misura per grafico, niente crimini a doppio asse.
- Intervalli di tempo 24 h / 7 / 30 / 90 giorni, tooltip al passaggio del mouse con tutti i server in quel momento, buchi dove il collector era spento.
- Riquadri di stato, un banner di allarme e lo storico degli allarmi, compresi i recuperi dall’IML.
- Modalità chiara e scura, un solo file HTML, nessuna dipendenza esterna. Aprilo in locale o mettilo su una condivisione.
📦 Prendilo
È tutto nel repository: github.com/aptupgrademe/ilo-thermal. Documentazione completa in inglese, tedesco, francese e spagnolo: installazione, un account iLO in sola lettura (basta il privilegio Login), ogni chiave di configurazione, ogni regola di allarme, risoluzione dei problemi e come adattare i due pattern dei nomi dei sensori ad altri modelli ProLiant. Il report e gli allarmi parlano inglese o tedesco.
git clone https://github.com/aptupgrademe/ilo-thermal.git ~/ilo-thermal
cd ~/ilo-thermal
cp ilo_thermal.conf.example ilo_thermal.conf && chmod 600 ilo_thermal.conf
# edit: iLO account, CA file, hosts, optional SMTP
./ilo_thermal.py collect && ./ilo_thermal.py report

# crontab
*/10 * * * * $HOME/ilo-thermal/run.sh
@reboot      sleep 120; $HOME/ilo-thermal/run.sh
⚠️ Esclusione di responsabilità
Questo è un progetto hobbistico, pubblicato così com’è sotto licenza MIT. Non mi assumo alcuna responsabilità per il suo corretto funzionamento, per allarmi mancati o falsi, né per qualsiasi danno a hardware, dati o altro derivante dal suo utilizzo. Non sostituisce la protezione termica dei tuoi server né un sistema di monitoraggio professionale. Controlla sempre i valori nell’iLO prima di agire. Testato su iLO 5 con DL20 Gen10 Plus e MicroServer Gen10 Plus v2; tutto il resto è affar tuo.
🎯 In sintesi
L’iLO è un’istantanea fantastica e una memoria pessima. Mezzo pomeriggio ha trasformato l’istantanea in uno storico, e lungo la strada mi ha insegnato che due dei miei sensori riportano finzione, che la cima del rack è sempre il posto caldo (quattro gradi più caldo, nel mio caso) e che il vero indicatore dell’aria in uscita è una differenza, non una temperatura. Ora è autunno ed è tutto noioso e verde. La prossima estate avrò un anno di dati con cui confrontare. È proprio questo il punto. 🌡️📉