
Un video di Natale per il team – metà cloud, metà homelab
Un video di Natale per il nostro team di monitoraggio, fatto con l'IA: le scene con le persone dal cloud, suono, musica, montaggio e rifinitura sul mio hardware. Cosa ha funzionato meglio e dove – e cosa è andato comunque storto.
🌐 Anche in: English · Deutsch · Français · Español · Português · Nederlands · Polski
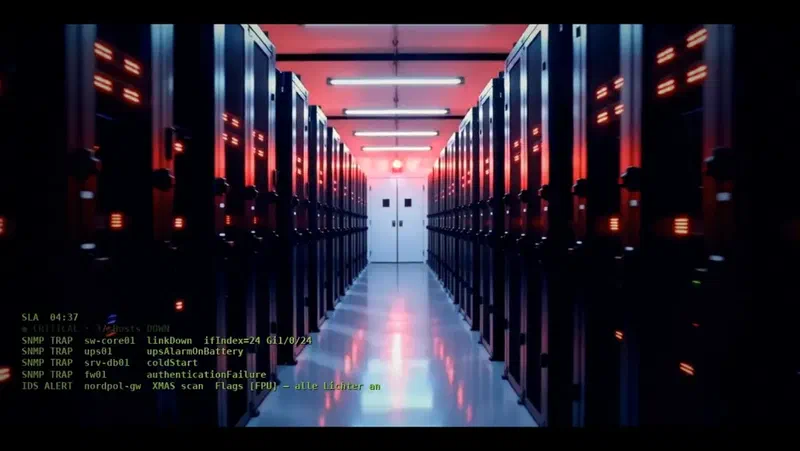
Per il calendario dell’avvento interno del nostro team di monitoraggio volevo un breve video: nel data centre i LED passano dal verde al rosso, allarme, battito cardiaco, riavvolgimento – e alla fine la colpa è ovviamente di Babbo Natale, inciampato in un “cavo del Wi-Fi”. Il risultato sono poco meno di 100 secondi di film che ho rifinito in oltre 70 versioni con Claude Code come aiuto regista.
Più interessante del film in sé è la domanda quali parti venivano dal cloud e quali giravano sul mio hardware. In breve: le immagini che contano venivano dal cloud – tutto il resto girava in locale.
Indice
☁️ Dal cloud: le scene con le persone
Per le vere e proprie scene video ho usato ArtCraft, un abbonamento che dà accesso a diversi modelli commerciali:
- Seedance 2.0 (video): data centre, centrale di monitoraggio, primo piano dei LED, Babbo Natale con la renna seccata. Un clip di 4 secondi in 720p costa circa 100 crediti.
- Nano Banana Pro (modifica di immagini): la foto di gruppo – colleghi come silhouette, cappelli da Babbo Natale, neve. 15 crediti per immagine.
Non ho pilotato ArtCraft dalla sua interfaccia ma tramite un server MCP: Claude Code scrive il prompt, carica le immagini di riferimento e scarica il risultato. Con una regola fissa: prima di ogni job Claude dichiara il costo e aspetta il mio “Start” – un job inviato non si può richiamare.
Il succo: per persone realistiche in movimento il cloud oggi è nettamente avanti. Ma ogni clip costa soldi veri, e i crediti finiscono più in fretta di quanto pensi – alla fine il saldo era a zero prima che l’ultima idea fosse realizzata.
🖥️ In locale: tutto quello che sta attorno alle immagini
Una macchina con una scheda grafica RTX (8 GB di memoria video) ha fatto il resto:
- ComfyUI come cornice per i modelli locali
- MMAudio: effetti sonori che si adattano all’immagine – renne che sbuffano, cavi che frusciano, l’inciampo
- ACE-Step: bozze musicali in stili diversi; il video finale usa un brano epico royalty-free da una libreria musicale
- Chatterbox (text-to-speech): il narratore
- Whisper: un controllo incrociato che “Icinga” e “Zabbix” siano pronunciati chiaramente
- RIFE: fotogrammi intermedi generati dall’IA per il rallentatore
- ffmpeg e Python: tagli, transizioni, testi, iris wipe, titoli di coda a macchina da scrivere, il finale in terminale con
systemctl status weihnachtene il mastering del loudness
In locale i tentativi costano solo corrente e tempo. È lì che avviene la maggior parte delle iterazioni: una voce suonava metallica, un’altra aveva l’accento inglese, la musica era troppo pop – dodici varianti di una frase in locale non sono un problema.
Il succo: il cloud fornisce il girato grezzo costoso, l’homelab lo trasforma in un film. Così i costi restano bassi e il controllo resta a te.
🎞️ Dove il locale non basta – e dove è meglio
All’inizio ho provato a creare anche le scene video in locale, con Wan 2.1/2.2. Con 8 GB di memoria video i risultati erano grezzi: volti primitivi, camminata innaturale, clip troppo corti.
Ecco come appariva nella pratica – lo stesso allarme nel data centre, generato interamente sul PC di casa (una scheda grafica RTX 3050 con 8 GB): prima una bozza grezza con Wan 2.1 (1.3B), poi rifinita con Wan 2.2 A14B. Confrontalo con il teaser qui sopra, dove le scene con le persone vengono dal cloud.
Al contrario, a volte l’IA “più intelligente” era la scelta peggiore:
- Upscaling a 1080p: Real-ESRGAN rendeva più nitidi i bordi ma le superfici diventavano cerose. Un upscaling classico con una leggera nitidezza sembrava più naturale.
- Fotogrammi intermedi: la stima del movimento di ffmpeg produceva artefatti a blocchi sulle mani veloci e sui pattern dei LED dei rack. RIFE era molto più pulito – solo quando il LED passa dal verde al rosso anche RIFE si inventava un fotogramma sbagliato. In quel punto ora c’è l’originale.
Il succo: “più IA” non è automaticamente meglio. Ogni strumento si inventa da qualche parte dettagli che non esistono – e tocca a te trovarli.
👀 Controllare quello che non puoi vedere
Claude non può né riprodurre né ascoltare un video. Quindi i controlli hanno fatto il giro lungo: singoli fotogrammi e contact sheet, loudness per scena (prima le scene differivano fino a 15 dB), riconoscimento vocale per la pronuncia e le voci nascoste, confronto di immagini per le giunzioni esatte.
Eppure ho trovato errori che nessuna misura mostrava: un “Aaa” femminile che in realtà era un artefatto alla fine della registrazione della voce, uno sfondo grigio e rumoroso dopo un filtro immagine, una scritta sovrapposta che volava attraverso la stanza durante una dissolvenza. E una volta un’estensione di 2,5 secondi semplicemente non ha fatto niente – senza alcun messaggio d’errore.
Il succo: misurare non sostituisce guardare. Gli strumenti trovano livelli e formati, le persone trovano quello che sembra “strano”.
🔧 Aggiornamento novembre 2026: cosa si è aggiunto da allora
Dopo il video di Natale ho fatto qualche breve clip privato: un lancio col paracadute sopra una città, uno stunt con due auto, un ballo su Marte, una breakdance in una piazza. Strada facendo la cassetta degli attrezzi è cresciuta:
- Fotogrammi iniziali e finali per Seedance: all’inizio il server MCP poteva passare solo immagini di riferimento. L’ho esteso in modo che un clip possa cominciare con un’immagine data e finire su un’altra. Una scena parte così esattamente dove si era fermata la precedente, e se fotogramma iniziale e finale sono la stessa immagine, dopo un movimento sfrenato la persona torna nella posa di partenza. Non funziona sempre: una volta il modello ha ignorato completamente il fotogramma iniziale.
- Più foto di riferimento per un volto (Nano Banana Pro): con una sola foto il volto deriva. Da sei a otto foto da angolazioni diverse lo avvicinano chiaramente all’originale. Conta anche la dimensione: un volto largo solo 60 pixel nell’immagine è in gran parte inventato.
- Face swap in locale (InsightFace con GFPGAN): dove il volto del cloud non corrispondeva ancora, un face swap sulla mia macchina inserisce il volto vero nell’immagine fissa, mediato su più foto di riferimento. Un modello di riconoscimento facciale misura il risultato: la somiglianza è salita da circa 0,5 a 0,87. I limiti: sostituisce il volto ma non i capelli, prende l’espressione dell’immagine di destinazione, e nei movimenti veloci sfarfalla. Quindi lo uso solo dove il volto è fermo.
- Flusso ottico e rimozione dello sfondo (OpenCV, rembg): il flusso ottico ha mostrato in numeri che in un clip la telecamera scivolava all’indietro per tre secondi, cosa che avevo notato ma non potevo dimostrare. rembg ha ritagliato l’auto, così il fumo artificiale delle gomme poteva andare dietro invece che sopra.
- Audio a strati: rumore del motore e delle gomme come strati MMAudio separati per scena, sotto una colonna sonora continua di ACE-Step che si abbassa sotto gli effetti. Una sorpresa: il limiter di ffmpeg di default alza il livello. Solo con
level=disabledi picchi sono rimasti sotto 0 dBFS; i mix precedenti erano circa 2 dB troppo forti.
Il succo: il cloud fornisce ancora il movimento, ma la parte locale è cresciuta dal montaggio alla riparazione. Volti, errori di camera e audio ora si sistemano a casa invece di pagare un nuovo clip.
🧾 Il conto
- Cloud: un abbonamento mensile più crediti – quasi tutto per una manciata di clip da 4 secondi e qualche modifica di immagini.
- Locale: nessun costo fisso, ma tempo di GPU – l’upscaling dell’intero film richiede circa 45 minuti.
- Tempo: la voce più grande. La maggior parte delle versioni è andata in timing, audio e dettagli, non in nuove scene.
Il succo: i soldi stanno in pochi clip dal cloud, il tempo in tante iterazioni locali.
🎯 Le lezioni
- Cloud per le persone, locale per tutto il resto – un homelab con 8 GB oggi non riesce a fare persone realistiche in movimento.
- Conferma il costo prima di ogni job nel cloud – inviato è inviato.
- Salva ogni versione con un nome nuovo – più di una volta una versione precedente era quella migliore.
- Usa gli strumenti di IA in modo selettivo – a volte il metodo classico è più onesto del modello.
- Guarda e ascolta di persona – le misure mostrano se qualcosa è corretto, non se funziona.
- Ripara in locale prima di generare di nuovo – un face swap o un taglio non costano nulla, un nuovo clip da 10 secondi costa 250 crediti.