Deep Dive: Hugo – cosa fa un generatore di siti statici, cosa ha sostituito i miei plugin WordPress e come funziona la ricerca senza server
Cos'è Hugo e in cosa differisce da WordPress, chi ha preso il posto di Yoast, Polylang e dei plugin di cache, come funziona un campo di ricerca su un sito senza server, come aggiungo un post e aggiorno Hugo – e quali trappole sono emerse solo nell'uso reale.
🌐 Anche in: English · Deutsch · Français · Español · Português · Nederlands · Polski
Deep Dive della serie intorno all’Ansible Tour. Il tour spiega i ruoli, i deep dive la tecnologia sottostante: come funziona, perché qui viene usata in questo modo e cosa è andato storto lungo la strada.
A inizio novembre questo blog è passato da WordPress su Kubernetes a Hugo. L’esperimento con numeri reali e il trasloco vero e proprio sono raccontati altrove. Questo post è la panoramica che avrei voluto avere prima di iniziare: cos’è davvero Hugo, chi ha preso il posto dei plugin WordPress, come funziona un campo di ricerca su un sito che non ha alcun codice lato server, cosa faccio quando aggiungo un post o aggiorno Hugo, e dove mi ha sorpreso.
Indice
🧭 Cos’è Hugo
Una tipografia invece di una cucina
WordPress funziona come la cucina di un ristorante: ogni volta che un ospite ordina, PHP cucina la pagina partendo dal database – a meno che un plugin di cache non abbia già un piatto pronto. Hugo funziona come una tipografia: stampa ogni pagina una volta sola, in anticipo, e il web server si limita a consegnare copie finite. Quando arriva un lettore non si cucina niente.
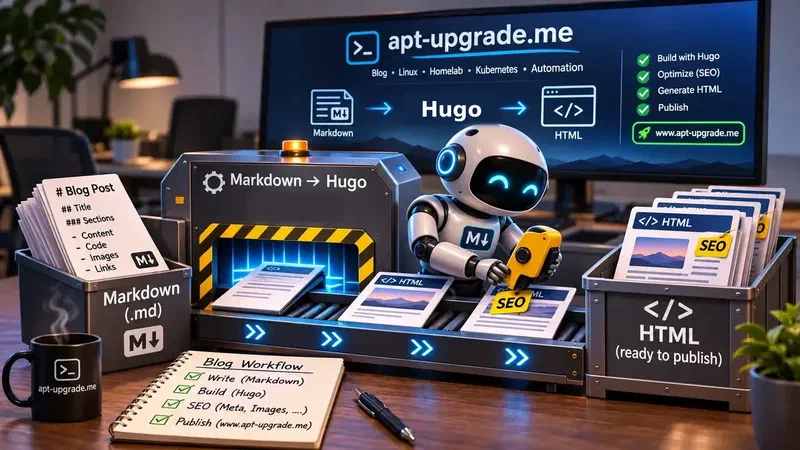
Tecnicamente Hugo è uno static site generator: un singolo programma scritto in Go che legge file Markdown, template e immagini e scrive una cartella piena di HTML, CSS, immagini e feed. Quella cartella è il sito web. Qualsiasi web server può servirla; qui è un semplice nginx.
Un binario, due edizioni
Hugo è un unico eseguibile senza dipendenze – niente PHP, niente database, niente Node.js. Esiste in un’edizione standard e in una extended; quella extended aggiunge la codifica WebP e Sass. Questo blog usa l’edizione extended, versione 0.169.0, perché ogni immagine viene ridimensionata e convertita in WebP durante la build.
Il succo: Hugo sposta tutto il lavoro dal momento della visita al momento della pubblicazione. Tutto il resto di questo post deriva da lì.
⚖️ Hugo contro WordPress
| Domanda | WordPress | Hugo |
|---|---|---|
| Quando nasce una pagina? | A ogni richiesta (o dalla cache) | Una volta, al momento della build |
| Cosa gira sul server? | PHP, MariaDB, spesso Redis | Solo il web server |
| Superficie d’attacco | Login, admin, plugin, XML-RPC, PHP | File statici |
| Aggiornamenti regolari | Core, plugin, temi, PHP | nginx; Hugo solo sulla macchina di build |
| Dove scrivo? | Editor nel browser | Editor di testo, Git |
| Commenti, moduli | Integrati | Serve un servizio esterno |
| Velocità | Con cache: 58 ms per la home | 57 ms – nessuna differenza |
| Peso della pagina (home, senza immagini) | 25 file, 198 KB | 3 file, 9,5 KB |
I numeri vengono dalle mie misurazioni prima del trasloco. La velocità non era il motivo: un WordPress con una buona cache è altrettanto veloce. I motivi erano il resto della tabella – nessun login da attaccare, nessun aggiornamento di plugin ogni settimana, nessun database di cui fare backup, e una pagina più piccola del 95 %.
A cosa ho rinunciato: l’editor nel browser, i commenti e la comodità di installare una funzione con un clic.
Il succo: WordPress è un programma che produce un sito web. Hugo produce il sito web una volta e si fa da parte. Se sia meglio dipende da se ti serve ciò che solo il programma in esecuzione sa fare.
🔧 Come funziona Hugo
Contenuti: Markdown con front matter
Ogni post è un file Markdown. In cima c’è il front matter, un blocco YAML che Hugo legge come dati. Un post di questo blog inizia così:
---
title: 'Zabbix in Containers Watches My Home Network'
slug: zabbix-in-containers-watches-my-home-network
date: '2026-11-13T15:40:00+01:00'
translationKey: zabbix-heimnetz-2026-11
description: 'Short summary for search results, at most about 155 characters.'
categories:
- linux
tags:
- zabbix
image: uploads/2026/11/zabbix-watchman.webp
imageAlt: What the picture shows, for screen readers and search engines
---
Sotto il secondo --- arriva il testo. Markdown copre titoli, liste, tabelle e codice; dove non basta è ammesso HTML grezzo (unsafe = true nelle impostazioni di Goldmark), cosa importante per i post convertiti da WordPress.
Cartelle, sezioni e indirizzi
site/
├── content/en/posts/   posts in English (one folder per language)
├── content/de/posts/   posts in German, and so on for eight languages
├── layouts/            templates: the theme
├── assets/             CSS and JavaScript, processed by Hugo
├── uploads/            images and downloads
├── i18n/               interface words per language ("Read more", "Search")
├── data/               menus, flags, footer text as JSON
└── hugo.toml           configuration
hugo.toml decide gli indirizzi: posts = "/:year/:month/:day/:slug/" mantiene lo schema di URL che usava WordPress, così nessun vecchio link si è rotto. Categorie e tag sono taxonomies; Hugo costruisce da solo una pagina per ogni categoria e ogni tag.
Template
I template usano il linguaggio di template di Go. baseof.html è la cornice di ogni pagina, page.html un singolo post, home.html la home page, e i partials sono pezzi riutilizzabili – l’header, la sidebar, il <head> con tutti i meta tag. Non uso nessun tema pronto: i layout sono stati scritti per assomigliare al vecchio tema WordPress.
La pipeline degli asset
Hugo elabora i file da sé: resources.Get "css/main.css" | minify | fingerprint minimizza il foglio di stile e mette un hash nel nome del file, così i browser possono tenerlo in cache per sempre. Le immagini vengono ridimensionate durante la build – l’immagine di anteprima per i social, per esempio, viene creata dall’immagine del post a 1200 px e rimpicciolita finché non resta sotto i 280 KB, il limite per le anteprime di WhatsApp.
Multilingua fin dall’inizio
Ogni lingua ha la sua cartella dei contenuti, la sua etichetta e il suo locale in hugo.toml. I post che vanno insieme condividono una translationKey; da lì Hugo conosce le traduzioni di ogni pagina e costruisce il selettore di lingua e i link hreflang. Questo blog ora ha otto lingue – inglese, tedesco, francese, spagnolo, italiano, portoghese, olandese e polacco.
Anteprima e bozze
hugo server costruisce il sito in memoria e lo serve su localhost:1313; ogni file salvato ricarica il browser. draft: true tiene un post fuori dalla build vera, e lo stesso fa una data nel futuro – su quest’ultima torno più sotto.
Il succo: contenuti, template e configurazione sono tre tipi di file separati. Puoi cambiare l’aspetto senza toccare un solo post, e scrivere un post senza sapere come funzionano i template.
🧩 Dove sono finiti i plugin
Su WordPress quasi ogni funzione era un plugin. Su Hugo una funzione è integrata, oppure sono poche righe di template, oppure un piccolo script che gira dopo la build.
| Plugin WordPress | Compito | Ora |
|---|---|---|
| Yoast SEO | Titolo, description, canonical, Open Graph, dati strutturati | head.html (un template per tutte le pagine) |
| Yoast SEO | Sitemap | Integrata in Hugo, template sitemap.xml proprio con hreflang |
| Yoast SEO | “Il tuo post non ha una description” | check_posts.py: la build si ferma |
| Polylang | Lingue, selettore di lingua | Integrato in Hugo |
| CompressX | Immagini WebP, dimensioni ridotte | Elaborazione immagini di Hugo |
| Autoptimize | Minimizzare CSS, JS, HTML | hugo --minify |
| WP Super Cache, Redis | Cache di pagina e di oggetti | Non serve – ogni pagina è già un file |
| Ricerca (WordPress) | Ricerca full-text | Pagefind (sezione successiva) |
SEO senza plugin
Yoast faceva tre cose: scriveva i meta tag, costruiva una sitemap e brontolava. Le prime due ora sono un unico partial, head.html. Per ogni pagina scrive il titolo (o un seoTitle più corto dal front matter), la description, un link canonical, un link hreflang per ogni traduzione, i tag Open Graph e Twitter con un’immagine di anteprima generata, le date dell’articolo e un blocco JSON-LD con gli stessi dati strutturati che produceva Yoast (Article, WebPage, BreadcrumbList, Person). È un solo file, ed è uguale per ogni pagina – nessuna schermata di impostazioni per post.
Il brontolare si è spostato nella build: tools/check_posts.py ferma la build se a un post mancano titolo, description, immagine, testo dell’immagine, chiave di traduzione o data, oppure se il file dell’immagine non esiste, e avvisa quando una description diventa troppo lunga o manca una traduzione.
Estensioni in Hugo
Hugo non ha un plugin store, ma ha dei punti di estensione:
- Temi e Hugo Modules – aspetti completi o pezzi di uno, inclusi come una dipendenza. Questo blog monta le proprie cartelle tramite
module.mounts(la cartella degli upload è montata due volte: una per l’elaborazione delle immagini, una come/wp-content/uploads/così i vecchi indirizzi delle immagini continuano a funzionare). - Shortcode – piccoli template che richiami dal Markdown, ad esempio per un video o un riquadro di avviso.
- Render hook – un tuo template per ogni link, immagine o titolo che il Markdown produce.
- Formati di output – lo stesso contenuto come HTML, RSS, JSON o qualsiasi altra cosa.
- Strumenti dopo la build – la build è solo una cartella, quindi qualsiasi programma può lavorarci sopra. Qui
imgattrs.pyaggiungesrcsete il lazy loading alle immagini dentro i vecchi post, e Pagefind costruisce l’indice di ricerca.
Il succo: la maggior parte dei plugin risolveva problemi che un sito statico non ha. Il resto è diventato un template o uno script che posso leggere per intero – il che significa anche che nessun altro li aggiorna per me.
🔍 Come funziona la ricerca senza server
Un campo di ricerca sembra aver bisogno di un server: qualcuno deve pur cercare le parole. Pagefind sposta anche quel lavoro nella build.
- Al momento della build, Pagefind legge ogni pagina HTML finita. Indicizza solo la parte marcata con
data-pagefind-body(l’articolo), così menu e sidebar non sporcano i risultati, e salta tutto ciò che è marcato condata-pagefind-ignore. Riconosce la lingua dall’attributolange costruisce un indice per lingua. - L’indice è diviso in tanti piccoli file sotto
/pagefind/– 18 MB in totale per otto lingue. Nessuno lo scarica tutto. - Nel browser non si carica niente finché qualcuno non cerca davvero. Allora poche righe di JavaScript importano Pagefind, che scarica solo i pezzi di indice per le parole digitate e i frammenti delle pagine corrispondenti, e mostra titolo ed estratto.
import('/pagefind/pagefind.js')
  .then(function (m) { return m.search(term); })
  .then(function (r) { return Promise.all(r.results.slice(0, 8).map(function (x) { return x.data(); })); })
Un effetto collaterale che mi piace: il termine cercato non arriva mai al server come query string, quindi non finisce in un access log. Il modulo è nascosto di proposito per i browser senza JavaScript – un normale invio del modulo avrebbe messo il termine nell’URL.
Il succo: “statico” non significa “senza interazione”. Significa che l’interazione avviene nel browser del lettore, con dati preparati in anticipo.
✍️ Il mio workflow per un nuovo post
- Scrivere il file Markdown in
site/content/en/posts/<slug>.mdcon il front matter visto sopra. Le traduzioni ricevono lo stesso nome di file, la stessatranslationKeye tag con un suffisso di lingua (hugo-de,hugo-fr, …). - Aggiungere l’immagine in
site/uploads/YYYY/MM/– WebP, al massimo 1536 px di larghezza, sotto i 280 KB. Nel testo le immagini si richiamano come/wp-content/uploads/YYYY/MM/name.webp, l’indirizzo che usava WordPress. - Build:
tools/build.sh
Esegue check_posts.py, poi hugo --gc --minify, poi imgattrs.py, poi Pagefind. Hugo da solo impiega circa dieci secondi per l’intero sito.
- Pubblicare:
tools/deploy.sh <host> 10022
rsync carica la build in una cartella incoming/; il server poi la copia in una nuova cartella di release e ci punta un symlink in un solo passo. Le ultime cinque release restano, quindi tools/deploy.sh <host> 10022 rollback torna indietro in un secondo. La chiave di deploy non può fare nient’altro – il server accetta per lei esattamente questi comandi e basta.
- Commit e push del repository dei contenuti.
Due repository: codice aperto, contenuti privati
Il server e gli strumenti di build vivono in un repository pubblico, www_hugo, accanto al codice Ansible per tutto il resto. I contenuti – post, immagini, template, bozze – vivono in uno privato. Il motivo è che un repository ricorda tutto: un’immagine che tolgo dal sito resterebbe per sempre nella cronologia di un repo pubblico, e le bozze non sono pensate per i lettori. Il server riceve solo file finiti tramite il passo di deploy e non vede mai una bozza; il repo pubblico non vede mai i contenuti.
Il succo: pubblicare sono due passi indipendenti. Il server mostra ciò che è stato deployato per ultimo, Git conserva ciò che è stato committato per ultimo – faccio entrambe le cose, in quest’ordine.
⬆️ Aggiornare Hugo
Hugo non è proprio installato sul server. Vive come singolo binario in .tools/ sulla macchina che costruisce il sito, insieme a Pagefind. Le versioni sono fissate in versions.yml del repo pubblico:
hugo_version:                "0.169.0"   # github.com/gohugoio/hugo/releases
pagefind_version:            "1.6.0"     # github.com/Pagefind/pagefind/releases
Un aggiornamento segue lo stesso schema di tutto il resto qui:
- Leggere le release notes – Hugo ogni tanto depreca funzioni di template e lo segnala nell’output della build molto prima di rimuoverle.
- Scaricare la release extended per Linux, confrontarne lo SHA-256 con il file dei checksum della release, sostituire
.tools/hugo. - Fare la build in una cartella separata e confrontarla con la build precedente (
diff -r). Devono comparire solo le differenze attese. - Cambiare il pin in
versions.yml, deploy, commit.
Visto che il server serve solo file, un aggiornamento di Hugo non può mai rompere il sito in produzione. Il caso peggiore è una build che fallisce o ha un aspetto diverso – e succede sulla mia macchina, non davanti ai lettori.
Il succo: il generatore è uno strumento di build, come un compilatore. Fissalo, aggiornalo di proposito e confronta l’output.
🤖 Cosa fa Claude intorno a Hugo
Gran parte del lavoro su questo blog lo faccio insieme a Claude (l’IA di Anthropic) nel terminale. Suddiviso per argomento:
- Migrazione: export da WordPress, conversione di ogni post in Markdown con front matter, vecchi indirizzi e percorsi delle immagini mantenuti, redirect per gli slug cambiati.
- Template e aspetto: ricostruzione del vecchio tema in template Hugo, lo slider, la sidebar, gli angoli bui come le pagine dell’archivio per data.
- SEO: il partial
head.html, la sitemap conhreflang, i dati strutturati, immagini di anteprima sotto il limite di WhatsApp. - Scrivere e tradurre: bozze con le mie parole, traduzioni in tutte e otto le lingue con regole fisse (blocchi di codice identici byte per byte, link riscritti per lingua) e un checker che confronta ogni traduzione con l’originale inglese.
- Controlli: il controllo nella build, un controllo dei link su tutte le pagine generate, un controllo live sul sito in esecuzione.
- Server e deploy: il ruolo Ansible per nginx, il deploy atomico, SELinux, il monitoring.
- Troubleshooting: capire perché un post non compariva (vedi la sezione successiva) o perché un breadcrumb puntava a una pagina inesistente.
Cosa resta a me: decidere cosa viene scritto e pubblicato, leggere ogni bozza, lanciare i playbook, e ogni push e deploy – Claude chiede prima di ciascuno.
Il succo: un sito statico è fatto di file di testo e piccoli script – esattamente il materiale che un assistente IA gestisce bene. Le decisioni restano mie.
🐛 Trappole emerse solo nell’uso reale
- Un post dal futuro non viene costruito. Ho impostato la data di un post alle 15:50 e fatto la build alle 15:44 – Hugo l’ha lasciato fuori in silenzio. Nessun errore, il post semplicemente mancava.
datedeve stare nel passato, oppure la build ha bisogno di--buildFuture. - Una pagina del giorno mancante. Il breadcrumb di un nuovo post puntava al suo archivio del giorno (
/2026/11/13/), che non esisteva perché le pagine per data sono file di contenuto, non pagine generate. Il controllo dei link l’ha trovato; ora una nuova data ha bisogno del suo_index.md. E proprio mentre scrivevo questo post sono successi di nuovo entrambi gli errori: il post era datato 08:30 e costruito alle 08:22, e la sua nuova pagina del giorno portava le 12:00 – una pagina datata a mezzogiorno è nel futuro per tutta la mattina. - L’HTML convertito è fragile. I post importati da WordPress sono un misto di Markdown e HTML grezzo. In alcuni le parole erano incollate tra loro o era sopravvissuto un
**vagante. Solo un controllo delle pagine renderizzate in tutte le lingue li ha trovati. - Le impostazioni tipografiche contano. Il typographer di Hugo trasforma di default
--in un trattino. WordPress non lo faceva, quindi comandi come--checksarebbero diventati–checknei vecchi post. Ora l’impostazione tocca solo virgolette e apostrofi. - Non tutto va nella ricerca e nei feed. Le note legali e l’informativa sulla privacy contengono l’indirizzo postale. Sono
noindex, escluse dai feed RSS e dall’indice di Pagefind – un plugin avrebbe richiesto un’impostazione per ognuna di queste cose, qui è una condizione nei template. - Alcuni indirizzi vengono dal front matter. Alcuni vecchi post hanno una chiave
url:con il percorso completo. Nelle traduzioni serve il prefisso di lingua, altrimenti tutte le lingue rivendicano lo stesso indirizzo.
Il succo: Hugo fa esattamente quello che gli dici e si lamenta di rado. I controlli che i plugin WordPress facevano in silenzio vanno messi per iscritto – e poi girano a ogni build.
📊 Misurato
| Post | 146, in 8 lingue |
| Pagine HTML generate | circa 23.000 (post, tag, categorie, archivi) |
| Build di Hugo | circa 10 s (sito intero) |
| Cartella di output | 498 MB, quasi tutto immagini |
| Indice di ricerca | 18 MB per 8 lingue, caricato a piccoli pezzi |
| Software sul server per il blog | nginx |
🎯 Le lezioni
- Decidi dove avviene il lavoro: alla visita (WordPress) o alla pubblicazione (Hugo).
- Prima di sostituire un plugin, controlla cosa faceva davvero – quasi tutto è un template, qualcosa è un controllo che devi scrivere tu.
- Ricerca, feed e sitemap funzionano senza server quando la build prepara i dati.
- Fissa la versione del generatore come per qualsiasi altro strumento di build e confronta l’output prima del deploy.
- Un post che manca senza alcun messaggio di errore di solito ha una data nel futuro.
- Tieni separati contenuti e codice quando il codice è pubblico.