
Homelab Rebuild 2026 — Het Proxmox-cluster bouwen en provisionen met Terraform
🌐 Ook in: English · Deutsch · Français · Español · Italiano · Português · Polski
In de vorige post heb ik het plan uiteengezet om mijn homelab om te bouwen tot een klein datacenter in enterprise-stijl: vijf pijlers, acht mijlpalen, één blogpost per mijlpaal. Mijlpaal 1 is het fundament waar al het andere op rust — drie fysieke machines omgebouwd tot één Proxmox VE-cluster, plus de Terraform-module die vanaf nu elke VM daarbovenop provisiont. Deze post behandelt allebei. Eerlijke waarschuwing: dit hele project is nog volop work in progress. Niets hier is “af” of definitief — het is op z’n best beta en het verandert onderweg steeds. Zie deze post als een momentopname van hoe het ervoor stond toen ik hem schreef, niet als een voltooide build.
Inhoud
🎯 Doel van deze mijlpaal
Twee dingen moesten kloppen voordat ik aan Active Directory, GitLab of Kubernetes kon beginnen:
- Drie losse HP-machines moesten één Proxmox VE-cluster worden, zodat VM’s vanuit één scherm beheerd, gemigreerd en geback-upt kunnen worden.
- Geen enkele VM mocht ooit nog bij elkaar geklikt worden. Elke VM — van de domain controller tot het Kubernetes-control plane — wordt aangemaakt door
terraform apply, niet door een wizard in de Proxmox-UI.
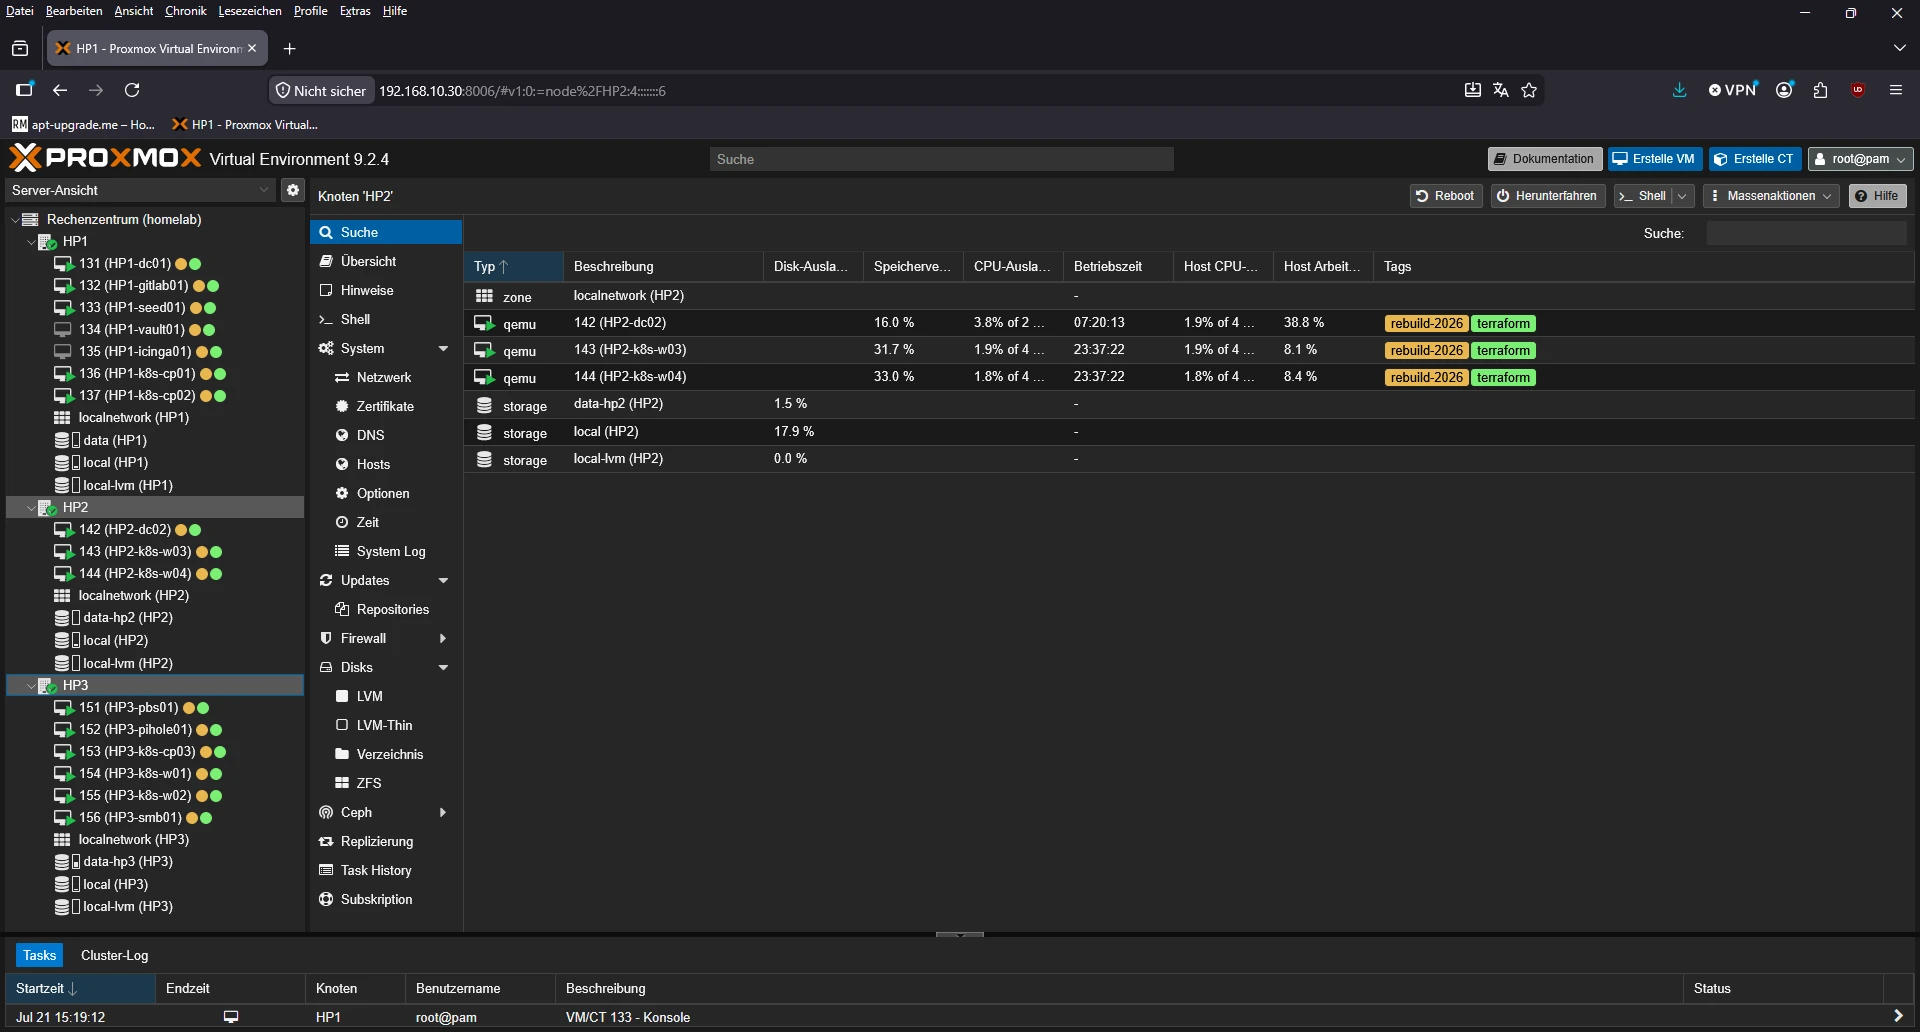
Alles hieronder geeft het cluster weer zoals het vandaag echt draait — ik heb de live waarden rechtstreeks uit de Proxmox-API gehaald in plaats van te vertrouwen op aantekeningen van de installatiedag.
🖥️ Hardware
Drie HP-machines, bewust niet identiek — dit is hergebruikte hardware, geen bij elkaar passende set:
| Host | RAM | Opslag | Management-IP |
|---|---|---|---|
| HP1 | 64 GB | 512 GB OS-SSD + 2 TB SSD | 192.168.10.x |
| HP2 | 32 GB | 512 GB OS-SSD + 2 TB SSD | 192.168.10.x |
| HP3 | 32 GB | 512 GB OS-SSD + 3×2 TB (ZFS RAIDZ1) | 192.168.10.x |
💽 Proxmox VE installeren
Niets bijzonders aan de installatie zelf: Proxmox VE 9.2-ISO, met Rufus op een USB-stick gezet, één stick per machine, booten, installeren, drie keer herhalen. Geen remote virtual media, geen PXE — voor drie machines op hetzelfde bureau is een USB-stick nog steeds de snelste weg van nul naar een draaiende hypervisor.
Elke node kreeg tijdens de installatie een statisch IP op het managementnetwerk 192.168.10.x/24 (.30, .40, .50 voor HP1–HP3), dat tegelijk het netwerk is waarop het cluster en elke VM leven — meer over die afweging hieronder.
Eén stap na de installatie op alle drie: de pakketrepo’s omzetten. Proxmox wijst standaard naar de Enterprise-repository, waarvoor je een betaald abonnement nodig hebt om echt updates binnen te halen. Volgens de eigen gedocumenteerde stappen van Proxmox heb ik de Enterprise-repo uitgeschakeld en elke node naar de No-Subscription Repository laten wijzen — prima voor test-/niet-productiegebruik, en dat is precies wat een homelab is, alleen zonder dezelfde validatie die de Enterprise-repo krijgt:
# /etc/apt/sources.list.d/proxmox.sources
Types: deb
URIs: http://download.proxmox.com/debian/pve
Suites: trixie
Components: pve-no-subscription
Signed-By: /usr/share/keyrings/proxmox-archive-keyring.gpg
Met dat op z’n plek de gebruikelijke ronde op alle drie de nodes, voordat ik iets anders deed:
apt-get update
apt-get upgrade
apt-get dist-upgrade
🌐 Netwerk
Elke node heeft één NIC, gebridged als vmbr0 (Linux bridge, STP uit), en daar hangt later het network_device van elke VM aan. Er zit een tweede onboard NIC-poort op de borden, maar die is voorlopig ongebruikt — een kandidaat voor een apart storage- of corosync-netwerk later, maar niet iets wat een homelab-cluster met 3 nodes op dag één nodig heeft.
Dat is meteen de enige bewuste vereenvoudiging die het benoemen waard is: corosync (het heartbeat-/quorumprotocol van het cluster) draait over hetzelfde netwerk als het management- en VM-verkeer, met één enkele ring:
ring0_addr: HP1 = 192.168.10.x
ring0_addr: HP2 = 192.168.10.x
ring0_addr: HP3 = 192.168.10.x
In een productiecluster zou je corosync op een eigen VLAN of eigen NIC’s isoleren, zodat een verzadigd managementnetwerk geen onterecht quorumverlies kan veroorzaken. Voor drie nodes op een thuisnetwerk zonder ander verkeer dat om bandbreedte concurreert, is dat risico acceptabel — het staat op de lijst om opnieuw te bekijken als dit ooit verder groeit dan een homelab. Mocht je ooit tegen onterecht quorumverlies aanlopen: RackNotes heeft een grondige uitleg over de stemmenrekensom, Corosync-faalscenario’s, QDevice en herstelpaden: Proxmox cluster quorum loss.
🔗 Het cluster vormen
Standaard pvecm-flow: het cluster op HP1 aanmaken en daarna HP2 en HP3 laten joinen. Met drie stemgerechtigde leden verdraagt het cluster precies één node die offline gaat (2 van 3 stemmen) voordat het zijn quorum verliest — de minimale werkbare HA-opzet, en precies de reden om voor drie nodes te kiezen in plaats van twee. Een query op het cluster vandaag bevestigt dat het happy path standhield:
$ pvecm status
Cluster name:   homelab
Quorate:        Yes
Nodes:          3

Nodeid  Ip              Name
1       192.168.10.x   HP1 (local)
2       192.168.10.x   HP2
3       192.168.10.x   HP3
🗄️ Opslagindeling
Hier houden de drie nodes op identiek te zijn. De tweede schijf van elke node (of schijven, bij HP3) is met opzet anders ingericht:
- HP1 & HP2: de extra SSD van 2 TB is toegevoegd als gewone directory-storage (
data/data-hp2) — geen ZFS, geen RAID, gewoon een bestandssysteem voor VM-disks, ISO’s en back-ups. Eén SSD, niets om tegen te mirroren, dus de simpelste optie wint. - HP3: drie schijven van 2 TB gaan in een ZFS-pool als RAIDZ1 (
data-hp3), goed voor net geen 4 TB bruikbaar met tolerantie voor één uitgevallen schijf. Dit is de node die gereserveerd is voor alles wat ik niet wil verliezen door één dode schijf — denk aan Longhorn-replica’s of MinIO-data zodra Kubernetes er is.
Elke node houdt ook de standaard local- (root-bestandssysteem) en local-lvm-storage (LVM-thin op de OS-SSD) van de installer, gebruikt voor het OS zelf en als overloop.
🧱 Van ClickOps naar Infrastructure as Code
Met het cluster in de lucht is de verleidelijke volgende stap om zeven keer op “Create VM” te klikken in de Proxmox-UI. Precies dat heb ik in de vorige versie van dit homelab gedaan, en elke VM werd net een beetje anders — hier een vergeten cloud-init-instelling, daar een met de hand ingetikt statisch IP, en zes maanden later geen enkel spoor van wat ik eigenlijk gedaan had. Deze keer niet: elke VM in deze rebuild wordt één keer gedefinieerd, in Terraform, en is reproduceerbaar vanaf een schoon cluster.
⚙️ De Terraform-module
De module staat in 01_terraform/ in de projectrepo en gebruikt de provider bpg/proxmox. In plaats van een Ubuntu Server-ISO te mounten en door de installer te klikken, wordt elke VM gekloond van een Ubuntu 26.04-cloud-image en volledig via cloud-init geconfigureerd — statisch IP, DNS, SSH-key, alles — dus er zit nergens in de pipeline een interactieve installatiestap:
resource "proxmox_download_file" "ubuntu_cloud_image" {
  content_type = "iso"
  datastore_id = var.image_datastore_id
  node_name    = var.proxmox_node
  url          = var.ubuntu_cloud_image_url
  file_name    = "noble-server-cloudimg-amd64.img"
  overwrite    = false
}

resource "proxmox_virtual_environment_vm" "vm" {
  for_each = local.vms

  name        = each.key
  tags        = ["terraform", "rebuild-2026"]
  node_name   = var.proxmox_node
  vm_id       = each.value.vmid

  disk {
    datastore_id = var.vm_datastore_id
    file_id      = proxmox_download_file.ubuntu_cloud_image.id
    interface    = "scsi0"
    size         = each.value.disk_gb
  }

  initialization {
    ip_config {
      ipv4 {
        address = "${each.value.ip}/${var.network_prefix}"
        gateway = var.network_gateway
      }
    }
    user_account {
      username = var.vm_username
      keys     = var.ssh_public_keys
    }
  }
}
Alle zeven VM’s — één per rol voor deze mijlpaal — zijn gedeclareerd als één locals.vms-map, dus later een achtste VM toevoegen is een diff van vijf regels, geen gekopieerd resource-blok:
| Naam | Rol | IP | RAM | Disk |
|---|---|---|---|---|
| HP1-dc01 | AD / DNS / Root CA | 192.168.10.x | 4 GB | 60 GB |
| HP1-gitlab01 | GitLab / Container Registry | 192.168.10.x | 8 GB | 120 GB |
| HP1-seed01 | Dev-VM (Ansible, kubectl, tooling) | 192.168.10.x | 4 GB | 60 GB |
| HP1-vault01 | Secretsbeheer (fase 2) | 192.168.10.x | 2 GB | 40 GB |
| HP1-icinga01 | Monitoring | 192.168.10.x | 4 GB | 60 GB |
| HP1-k8s-cp01 | RKE2-control plane | 192.168.10.x | 8 GB | 80 GB |
| HP1-k8s-cp02 | RKE2-control plane | 192.168.10.x | 8 GB | 80 GB |
VM-ID’s volgen 100 + <laatste IP-octet> (131–137) — Proxmox vereist ID’s ≥ 100, en zo blijven ID en adres in één oogopslag aan elkaar te koppelen, zonder aparte opzoektabel.
▶️ Uitrollen
De hele uitrol is drie commando’s zodra er een Proxmox-API-token en een SSH-key klaarstaan:
cp terraform.tfvars.example terraform.tfvars
# edit terraform.tfvars: API URL, API token, node name, SSH key

terraform init
terraform plan
terraform apply
Een paar minuten later bestaan alle zeven VM’s, booten ze en antwoorden ze op hun toegewezen IP’s — en Terraform vertelt je precies welke welke is:
Outputs:

vm_ids = {
  "HP1-dc01"     = 131
  "HP1-gitlab01" = 132
  "HP1-icinga01" = 135
  "HP1-k8s-cp01" = 136
  "HP1-k8s-cp02" = 137
  "HP1-seed01"   = 133
  "HP1-vault01"  = 134
}
vm_ips = {
  "HP1-dc01"     = "192.168.10.x"
  "HP1-gitlab01" = "192.168.10.x"
  ...
}
🧩 Een paar dingen die het vermelden waard zijn
- Cloud-image, geen ISO. De Ubuntu-ISO op de lokale storage van HP1 wordt bewust niet door deze module gebruikt — een cloud-image klonen en via cloud-init configureren is sneller en volledig onbeheerd. De ISO blijft alleen staan voor de zeldzame handmatige installatie.
ignore_changesop defile_idvan de disk. Zonder dat wil Terraform bij elke plan de base-image opnieuw importeren, omdat de ID van het gedownloade bestand niet bedoeld is om na de eerste clone nog gereconcilieerd te worden.- Secrets verlaten nooit de interne repo.
terraform.tfvarsbevat het echte API-token en de SSH-key en staat in de gitignore; een pre-push-hook blokkeert bovendien actief dat het ooit de publieke GitHub-mirror van dit project bereikt. - De state is lokaal, en dat is prima. Eén operator, één laptop die
applydraait — een remote backend zou een probleem oplossen dat ik nog niet heb.
Voor een diepere technische uitleg van de module — architectuur, elke variabele, de volledige VM-inventaris en een doorlopende lijst met geleerde lessen — zie 01_terraform/docs/ in de repo (Engels, Duits en Frans).
⚠️ Dit hele project — inclusief de Terraform-code hieronder — is permanent work in progress. Het draait, het doet wat het belooft, maar het is nog steeds beta en wordt voortdurend omgebouwd. Beschouw niets hier als af of stabiel.
📊 De blinde vlek van ballooning onder Windows
HP1-dc01 wordt door deze module geprovisioned zoals elke andere VM, maar blijft niet lang Ubuntu — direct daarna wordt hij omgezet naar Windows Server, want dat is wat Active Directory nodig heeft. Op het moment dat dat gebeurde, bleef de RAM-grafiek in het Proxmox-overzicht plat op 100% van de toegewezen 4 GB hangen, hoe idle de VM ook was.
De oorzaak: Proxmox meet het geheugengebruik van de guest niet rechtstreeks. Het leest het terug uit het virtuele balloon-device van QEMU, en dat rapporteert alleen echte cijfers als er in de guest een driver draait die het voedt. Op de Linux-VM’s in dit cluster zit dat gebundeld bij qemu-guest-agent — al behandeld bij de guest-agent-fix hierboven. Windows Server heeft niets vergelijkbaars ingebouwd, dus zonder extra software heeft het balloon-device niets te melden en laat Proxmox de VM gewoon vastgepind op zijn volledige toewijzing zien.
De oplossing was een tweede virtuele cd-rom: de virtio-win-driver-ISO mounten en daaruit via Apparaatbeheer de VirtIO Balloon Driver installeren. Dat is hetzelfde driverpakket waar ook het Windows-equivalent van de guest agent in zit — zodra dat geïnstalleerd was, begon de grafiek in het overzicht de echte geheugendruk te volgen in plaats van een platte lijn tegen het plafond. Meer over het ombouwen van deze VM tot een echte domain controller in de volgende post.
🔜 Wat komt er hierna
Met een quorate cluster van 3 nodes en een herhaalbare manier om VM’s op te starten, begint mijlpaal 2 met het ombouwen van HP1-dc01 tot een echte domain controller: Active Directory, DNS en de offline Root CA die alles in dit homelab uiteindelijk gaat vertrouwen. Dat is de volgende post.
📚 Meer in deze serie: Homelab Rebuild 2026
- Homelab Rebuild 2026 — Van homelab naar mini-datacenter
- Homelab Rebuild 2026 — Active Directory, Pi-hole-witwassen en een stationsletter die weigert te bestaan
- Homelab Rebuild 2026 — GitLab, een seed-VM en de stilte voor de Kubernetes-storm
- Homelab Rebuild 2026: afwachten - Een servercrash, een doodlopend advisory en mijn nieuwe hoofdverdachte