
Van bare metal naar K3s: het strijdlogboek van een Nextcloud-migratie
🌐 Ook in: English · Deutsch · Français · Español · Italiano · Português · Polski
Vandaag heb ik een productie-Nextcloud verhuisd van een knusse native bare-metal-installatie naar een glimmende K3s/container-stack. Op papier: backup ophalen, terugzetten, DNS omzetten, klaar. In de praktijk: een reeks kleine landmijnen, elk onzichtbaar tot je erop stapt. Hier is het strijdlogboek. 🪖
Inhoud
Stap 1: de data verscheppen 🚚
Het zware werk was een rsync van ~360 GB gebruikersdata plus een SQL-dump van ~330 MB van de backupmachine naar de nieuwe node. Omdat ik eerder op de dag al vooraf had gesynct, verstuurde de laatste run alleen nog de delta — het geheel kwam neer op een snelle incrementele kopie. Een les zo oud als de weg naar Rome: eerst voorzaaien, dan is de cutover-sync piepklein.
Stap 2: de major-versie-hindernisbaan 🎮
De backup was Nextcloud 32.x. De doelstack draait 34.x. Nextcloud heeft één harde regel: je kunt geen major-versie overslaan. Dus het is een wandeling, stap voor stap:
32.0.14 → 33.0.9 → 34.0.4 (occ upgrade at every step)
De containertwist: de code leeft in een persistent volume, en Nextcloud weigert oudere code te draaien tegen een nieuwere dataversie (“downgrade not supported”). Een v32-database terugzetten op een pod die nog v34-code had = directe weigering. De oplossing is heerlijk hacky: de image vastzetten op de bijpassende versie, de version.php van het codevolume een duwtje geven zodat het entrypoint de juiste code opnieuw neerlegt, en elke occ upgrade laten afronden (de readiness probe blokkeert tot de DB-migratie klaar is — geduld vereist).
De onzichtbare landmijnen 💣
1. De antivirussocket des doods
Na de restore gooide de Files-app direct na het inloggen een kale “Internal Server Error” — en het log bleef leeg, omdat de crash onder Nextclouds eigen logger plaatsvond. Oorzaak: de teruggezette config zette files_antivirus weer aan in socket-modus, wijzend naar een ClamAV-daemonsocket die op de oude native machine bestaat, maar niet in de container. Oplossing: de app uitzetten (deze stack doet ’s nachts batchscans). Alleen gediagnosticeerd door het op te merken, niet door een logregel. Geniepig.
2. De Let’s Encrypt-gevangenis 🔒
DNS wees nog niet naar de nieuwe machine, dus cert-manager had dagenlang tevergeefs geprobeerd certificaten uit te geven. Toen ik eindelijk de DNS omzette, kwamen de certificaten er nog steeds niet. Waarom? Na genoeg mislukkingen parkeert cert-manager het Certificate in een exponentiële back-off die in de status van het object staat — volgende poging gepland over ~24 uur. De controller herstarten? Genegeerd. Het secret verwijderen? Genegeerd. Wat echt werkt: het Certificate-object verwijderen en ingress-shim het vers laten aanmaken, zonder foutgeschiedenis → directe uitgifte.
Bonusval: de HTTP-01-check van Let’s Encrypt geeft de voorkeur aan IPv6. Als je alleen het A-record verhuist en de AAAA vergeet, blijft de validatie de oude host raken en falen, terwijl alles omgezet “lijkt”. Verhuis ze allebei. Altijd allebei.
Het hoofdnummer: het vinkje dat loog ☑️
Deze kostte het meeste hoofdgekrab. Collabora (Nextcloud Office) weigerde documenten te openen: “Nextcloud Office could not be loaded.” Ondertussen was de Office-connectiviteitstest in het adminpaneel geruststellend groen: “Collabora Online server is reachable.” Aan de serverkant klopte alles — discovery 200, capabilities 200, geldige certificaten, juiste WOPI-URL, WebSocket-headers aanwezig, identiek aan een referentiehost waarvan bekend is dat hij werkt.
Het verschil bleek één enkele instelling te zijn die van de oude server was meegekomen: “Disable certificate verification (insecure)” stond aangevinkt (disable_certificate_verification=yes in richdocuments). Op de oude machine was dat logisch — self-signed certificaten. Maar nu, met geldige Let’s Encrypt-certificaten, breekt die “onveilige” modus de WOPI-documentsessie in richdocuments 11.x — terwijl de connectiviteitstest in het adminpaneel perfect groen blijft, omdat die test een ander codepad gebruikt dan de echte documenthandshake.
Waarom denk ik dat dit de boosdoener was? Omdat de oplossing precies dat was: vinkje weghalen (de key verwijderen), opnieuw proberen, en de documenten gingen meteen open. Mijn theorie: het onveilige/no-verify-pad en de WOPI-tokenuitwisseling zijn het oneens zodra er echte TLS in het spel is, en de fout komt pas boven in de editorsessie — de klassieke situatie “de health check is groen maar de functie is dood” die sysadmins nederig houdt. Nog twee overgebleven productiekeys (public_wopi_url, doc_format) gingen meteen mee de deur uit, passend bij de minimale config van de referentiehost.
De rode haring: “waarom staan er zoveel apps uit?” 🎣
Na de upgrade stond een hele stapel apps als uitgeschakeld (dashboard, comments, external storage, …) en ik zette me schrap voor een reconcile-marathon. Toen vergeleek ik de huidige appset met de toestand van de oude server (gehaald uit de DB-dump van vóór de upgrade). Plotwending: ze stonden op de oude machine ook uit. De nieuwe instantie kwam al overeen met productie. Het enige echte slachtoffer was metadata, dat simpelweg geen versie heeft die met Nextcloud 34 werkt. Soms is de enge diff gewoon… de waarheid.
Native vs. containers: het eerlijke stuk ⚖️
De nieuwe instantie voelt een tikje trager aan dan de oude native. RAM en CPU vervelen zich (ruim voldoende marge), en de responstijden aan de serverkant liggen op 50–210 ms — prima gezond. Het verschil is architecturaal: containers voegen hops toe (ingress-proxy, overlaynetwerk, PHP-FPM↔nginx over het podnetwerk, DB over de grens pod/host). Per request zijn het milliseconden; over de vele requests die een Nextcloud-pagina afvuurt, telt het op tot “iets minder vlot”. Dat is de belasting die je betaalt voor reproduceerbaarheid, isolatie en pijnloze upgrades — en voor een kleine organisatie is dat een ruil die het waard is.
De grote databaseschoonmaak 🗃️
Een database terugzetten van een oude server sleept zijn hele geschiedenis mee. De file-cache-index droeg de bestandspaden van de oude server onder achterhaalde storage-ID’s — plus een allang verwijderde OnlyOffice-bundel waarvan de 276k indexrijen de app hadden overleefd. Netto resultaat: een oc_filecache-tabel met 1.053.373 rijen, waarvan ~93% dood gewicht, en een database van 1 GB.
De schoonmaak, zorgvuldig uitgevoerd met een backup en controlewaarden (echte gebruikersbestanden en aantal gebruikers mogen niet veranderen): de 7 verweesde OnlyOffice-tabellen droppen, de twee verouderde storages verwijderen (het oude native pad en een eerdere containermapping) nadat ik had gecontroleerd dat ze nul echte bestanden bevatten — alleen regenereerbare app-data — en dan OPTIMIZE om de vrijgekomen pagina’s terug te geven aan het bestandssysteem. Resultaat:
oc_filecache rows:  1,053,373  →  72,580
database size:          1 GB   →  282 MB   (-72%)
real user files:       56,183  →  56,183   (unchanged ✔)
users:                    151  →  151      (unchanged ✔)
En op schijf: 27 GB aan verweesde preview-thumbnails waarvan de index net was verwijderd. Previews zijn pure, regenereerbare cache — de verweesde boom verwijderen wint de ruimte terug en Nextcloud bouwt thumbnails op verzoek opnieuw op. (De les uit een eerdere generale repetitie: verweesde previews nooit opnieuw indexeren — dat schept alleen maar ~500k dode rijen terug in de tabel die je net hebt schoongemaakt. Verwijder ze in plaats daarvan.)
Bonus-gremlin: de lege netwerkgrafieken 📉
node_exporter rapporteerde vrolijk CPU, RAM en schijf aan Grafana — maar elk Network Traffic-paneel bleef koppig leeg. De metric node_network_receive_bytes_total was er gewoon niet. De aanwijzing zat in node_scrape_collector_success{collector="netdev"} 0 en de logregel:
netdev: "couldn't get netstats: socket: address family not supported by protocol"
Moderne node_exporter leest NIC-statistieken via een netlink-socket — en de systemd-hardening van de service had RestrictAddressFamilies=AF_INET AF_INET6, wat stilletjes AF_NETLINK verbiedt. De collector faalt geruisloos, de metric verschijnt nooit, de grafiek blijft leeg. AF_NETLINK aan de allow-list toevoegen, reload, restart — en de verkeerscurves komen tot leven. (Bonus-déjà-vu: precies dezelfde vergeten AF_NETLINK had eerder in dit project de hardening van MariaDB al gebeten. Sandboxing geeft veiligheid en neemt netlink af.)
De machine zien denken 📊
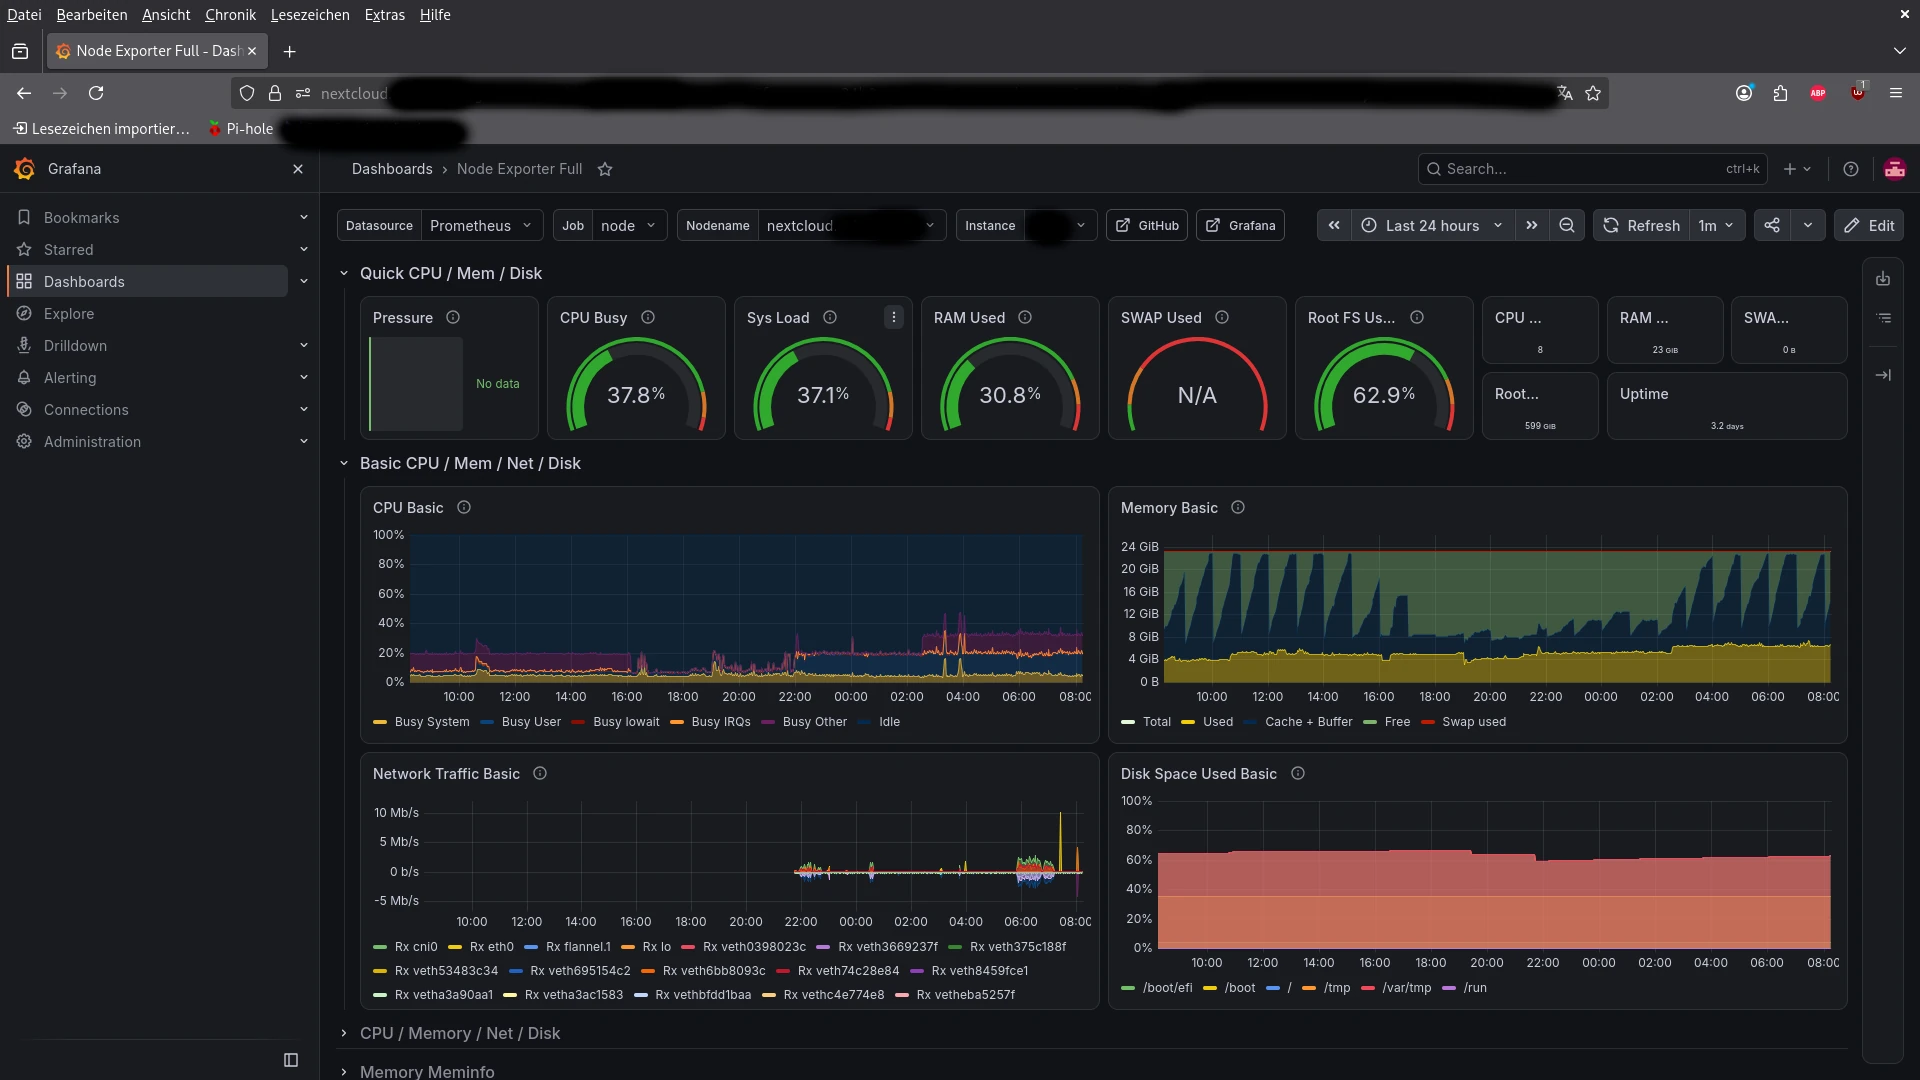
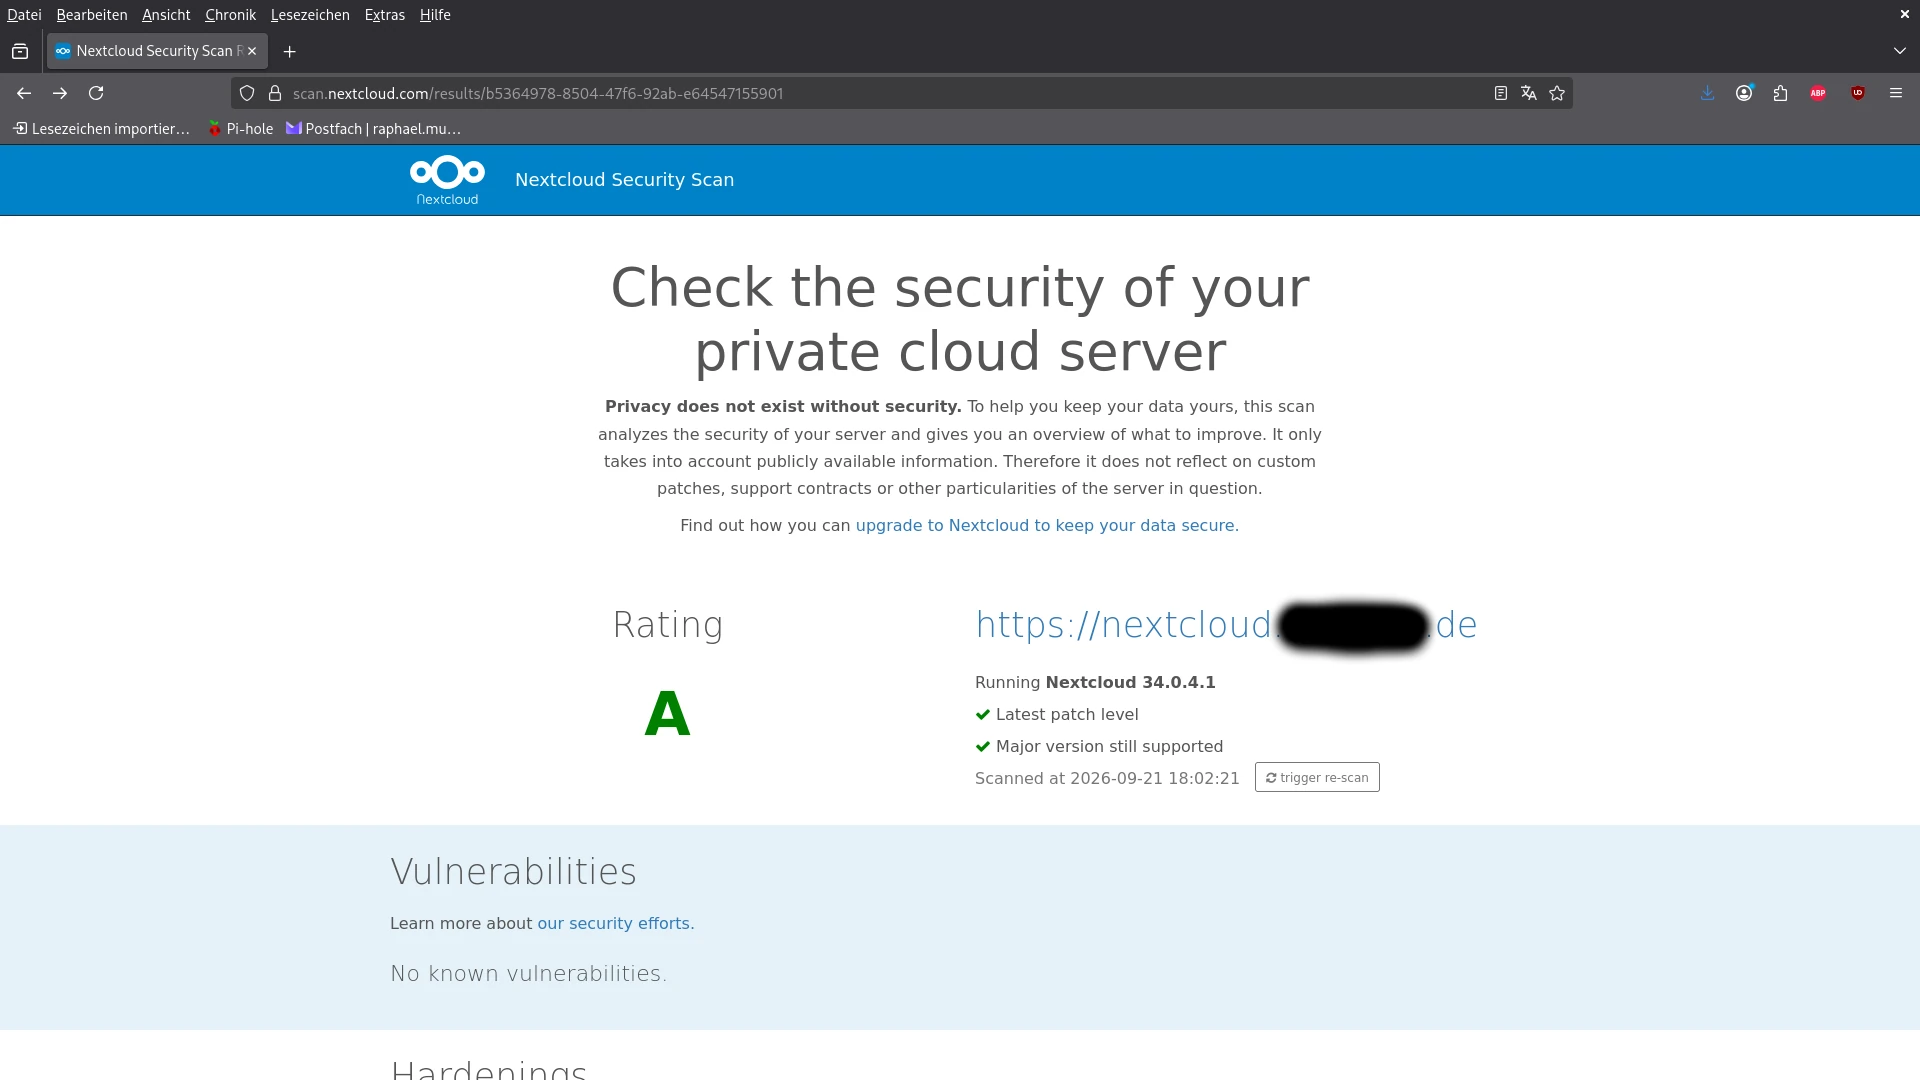
Twee verwante opruimacties maakten het af. Eerst verwijderde ik de 27 GB aan verweesde preview-thumbnails (hun index was al weg sinds de DB-schoonmaak hierboven) — previews zijn pure cache, dus geen schade. Daarna, in plaats van elke vroege tester de “deze thumbnail wordt gemaakt terwijl je wacht”-belasting te laten betalen, startte ik een volledige regeneratie met occ preview:generate-all. Die job heeft de hele nacht staan malen en zich door ~35.000 afbeeldingen, pdf’s en video’s heen gekauwd — het dashboard hierboven is hem op heterdaad betrapt, en de scanner hieronder is diezelfde run die previews bestand voor bestand opnieuw opbouwt.
Wat leidt tot een kleine bekentenis: ik heb nog nooit zo’n dashboard gehad. CPU, load, geheugen en — nu de netlink-gremlin is opgelost — netwerkdoorvoer in realtime zien is vreemd bevredigend. Ik ben oprecht benieuwd hoe het eruitziet bij dagelijks gebruik: krijg ik mooie strakke pieken als iemand een complete fotoshoot in één keer uploadt, of een team een hele galerij binnenhaalt? Ik weet het nog niet — en dat is de helft van de lol. Vraag het me over een week nog eens, als ik lang genoeg naar deze grafieken heb gestaard om meningen te hebben over percentielen waarvan ik niet wist dat ik ze had. 😄
Naschrift: probes die een vastgelopen pod echt herstarten 🩺
Een dag later ging ik terug en repareerde iets dat aan me bleef knagen. De pods hadden readiness probes — Kubernetes wist wanneer het geen verkeer moest sturen — maar hun liveness-check was de tandeloze kill -0 1, die pas iets merkt als PID 1 al dood is (en dan is de container sowieso al weg). Een proces dat nog draait maar vastzit — FPM hangt, accepteert niets meer op zijn socket — zou daar gewoon kapot blijven staan tot een mens het merkte. Bij een pod met één replica is dat precies het geval dat je automatisch afgehandeld wilt hebben.
De oplossing is een degelijke opzet met drie probes per container: een startupProbe die liveness en readiness tegenhoudt tot de app echt luistert (tot ~10 minuten speling, zodat een trage occ upgrade of een previewgolf bij het opstarten nooit een herstartlus veroorzaakt), een readinessProbe die het verkeer regelt, en een strakke livenessProbe — een echte tcpSocket-connect, geen PID-check — die de container pas herstart als hij echt niet meer antwoordt. De startup-poort is het dragende stuk: zonder die poort zou een liveness probe die streng genoeg is om een vastloper te vangen ook een container executeren die gewoon traag opstart. De blog draait dezelfde stack, dus die kreeg voor de pariteit precies dezelfde behandeling.
Naschrift: tunen op het ijzer 🎛️
Toen het stof was neergedaald, begon het leuke deel: naar de nieuwe Grafana-dashboards kijken en tunen op wat ze echt lieten zien in plaats van op wat ik had gegokt. De machine bleek veel meer marge te hebben dan ik had aangenomen — 8 cores, 23 GB RAM, ~16 GB vrij in rust — dus ik hield op met krenterig zijn. Collabora ging van 4 naar 6 vooraf geforkte childprocessen, en de limieten van 3 naar 6 GB en van 2 naar 4 cores, wat het af en toe haperende koude starten gladstrijkt als iemand na een rustige periode voor het eerst een document opent. Er kwam nog wat poetswerk bij: read-only root-bestandssystemen op de sidecars, een verstandiger logniveau (alleen fatal verbergt precies de waarschuwingen die je wilt zien), en node_exporter leren om op te houden met het rapporteren van drie dozijn virtuele containerinterfaces, zodat de netwerkgrafiek die ene NIC laat zien die ertoe doet. Alles staat in dezelfde Ansible-repo — reproduceerbaar, geversioneerd en saai in de best mogelijke zin.
De zwarte hoed op 🕵️
Voordat ik het af verklaarde, deed ik wat elke paranoïde admin zou moeten doen: ik viel mijn eigen instantie van buitenaf aan. Geen portscans — behalve de webpoorten en een SSH-poort die alleen sleutels accepteert, dropt de firewall alles stilletjes, dus er valt weinig te vinden — alleen de requests die een echte opportunist op een verse Nextcloud afvuurt, op zoek naar een zwakke plek. De korte versie: die was er niet.
Elk gevoelig pad kwam terug met een vlakke 403 — config/, data/, .htaccess, .git/, 3rdparty/, het hele rijtje. WebDAV en remote.php eisen authenticatie (401) voordat ze iets zeggen. De Server-header is een laconieke nginx zonder versie, geen X-Powered-By, geen PHP-vingerafdruk om naast een CVE-lijst te leggen. TLS is 1.3 met een geldig Let’s Encrypt-certificaat; 1.0 en 1.1 worden botweg geweigerd. De volledige set securityheaders staat erop — HSTS met preload, een CSP op basis van nonces, nosniff, frame- en referrerbeleid, een dichtgetimmerde permissions policy, en __Host--cookies. Nextclouds eigen code-integriteitscheck meldt nul gewijzigde bestanden.
Het deel dat ik het belangrijkst vind: de brute-force-throttling staat aan, en — omdat de reverse-proxyketen het echte client-IP correct doorgeeft — remt die de aanvaller af, niet mijn eigen ingress. Dat is de valkuil die rate limiting op veel setups achter een proxy stilletjes castreert, dus het is het waard om te verifiëren in plaats van aan te nemen. Niets hiervan is exotisch; het zijn vooral de saaie, juiste defaults plus een paar bewuste details. En daar gaat het om — het meest ontmoedigende wat een aanvaller kan vinden is een muur zonder naden. 🧱
Dag drie: de losse eindjes aan elkaar knopen 🧹
De previewmarathon van hierboven was eindelijk klaar bij het ochtendgloren van dag drie, na ruim een dag kauwen op de hele bibliotheek. Nu er niets meer in de bestandsindex schreef, kon het uitgestelde opruimwerk draaien — en een fatsoenlijke end-to-end-check daarna bracht twee gremlins aan het licht die zich in het volle zicht hadden verstopt.
De “lege” tabellen die het niet waren
Mijn eigen aantekeningen zeiden dat de overgebleven tabellen van allang verdwenen apps (Talk, Polls, Collectives, Maps) leeg waren en weg konden. Voordat ik iets droppte, telde ik toch de rijen. Ze waren niet leeg: een paar dozijn wikipagina’s, een paar polls met stemmen, enkele tientallen chatrooms. Niemand kan ze nu zien, omdat de apps niet geïnstalleerd zijn — maar installeer een app opnieuw en hij pakt zijn oude tabellen gewoon weer op. Dus ze blijven. Wat wel wegging: de laatste resten van OnlyOffice op schijf (eerst gearchiveerd, dan verwijderd), plus een volledige OPTIMIZE die de fragmentatie in 17 seconden van 59 MB naar 2 MB perste. Les: vertrouw op rijtellingen, niet op je eigen samenvatting van gisteren.
Push, niet pollen: notify_push 📡
De syncclients van Nextcloud vragen de server normaal elke ~30 seconden: “nog iets nieuws?” De app notify_push (Client Push) draait dat om — een kleine Rust-daemon houdt een WebSocket open, en de server meldt wijzigingen op het moment dat ze gebeuren. (Het heeft niets te maken met meldingen op je telefoon; die lopen via Nextclouds push-proxy en werkten al die tijd gewoon.) Op een native machine zijn het drie onderdelen: de app, een systemd-service en een location /push/ in de webserver. Op K3s zijn het dezelfde drie onderdelen in andere kleren: de app, een eigen Deployment en een Ingress-route.
De Ansible-kant had ik de dag ervoor gebouwd, uitgeschakeld. Bij de review vóór het omzetten van de schakelaar vond ik vier bugs die het slechtst denkbare resultaat zouden hebben opgeleverd — een groene playbookrun en een dode functie, omdat elke stap was ingesteld om fouten te tolereren. occ draaide als root (Nextcloud weigert dat). Het binary werd gekozen met een glob — en alfabetisch komt aarch64 vóór x86_64. De container draaide als root met alle capabilities gedropt, wat veilig klinkt tot je beseft dat root zonder CAP_DAC_OVERRIDE een 0640-bestand van www-data niet kan lezen — zoals config.php. En de ingress gaf /push/… ongewijzigd door, terwijl de daemon /ws op zijn root verwacht.
Zelfs met alle vier opgelost kwam de eerste self-test terug met een 404 — gerenderd door Nextcloud. De route bestond; nginx koos hem alleen nooit. De Nextcloud-routes zijn een catch-all-regex, location ~ "^/", en in nginx wint een regex van een gewone prefix. Dus de pushroute moest ook een regex worden — en toen verloor hij nog steeds, omdat de ingress-controller regex-locations in alfabetische volgorde van de Ingress-naam uitschrijft, en nginx de eerste match neemt. notify-push-routes komt na nextcloud-routes; hernoemd naar nextcloud-push-routes (“p” vóór “r”) wint hij. Niet mijn trotste fix, maar wel een gedocumenteerde. Alle zes self-tests werden groen, en de eerste browsersessie upgradede naar een WebSocket (HTTP 101) en ontving haar eerste bestandsevents. Eerlijk oordeel: voor een handvol desktopclients is het een nice-to-have — wijzigingen komen binnen seconden aan in plaats van tot een halve minuut — geen gamechanger.
Gremlin #1: de hardening die de database onderuit haalde
Terwijl er een playbookrun liep, antwoordde Nextcloud even met 500. MariaDB was gestopt — netjes, geen crash. De journal vertelde het verhaal: twee seconden eerder had de OS-hardeningrol het pakket rsync verwijderd als “ongebruikt op deze host”. Dat klopte op de bloghost, waar het was geverifieerd. Op de Nextcloud-host vereist het pakket MariaDB-server rsync — de Galera-clustertools leveren een state-transfer-script op basis van rsync mee, zelfs op een enkele node die nooit een cluster zal joinen. Dus dnf verwijderde plichtsgetrouw MariaDB mee, wat de service stopt; een latere rol installeerde beide opnieuw, en weer een andere startte de database weer. Netto effect: twee tot drie minuten downtime bij elke playbookrun, onzichtbaar tenzij je toevallig op het juiste moment keek. De oplossing is één bewaking: rsync alleen verwijderen als rpm -e --test rsync zegt dat er niets van afhangt. “Geverifieerd op host A” is niet “waar op host B”.
Gremlin #2: de alerts die nooit konden afgaan
De Grafana-alertregels — schijf, geheugen, CPU, node down — zagen er in de UI perfect uit. In het log faalde elk van hen bij elke evaluatie met condition must not be empty: de provisioningcode had Grafana nooit verteld welke query over het alert beslist. En omdat de regels evaluatiefouten als “OK” behandelden, werd er nooit iets rood. Eén ontbrekend veld, "condition": "B", en nu evalueren ze netjes. Een alert dat niet kan afgaan ziet er precies uit als een gezond systeem — de gevaarlijkste soort groen die er bestaat. (Basale mailalerts via Monit waren er de hele tijd, dus de machine vloog niet helemaal blind.)
Gremlin #3: de portscan-ban die er niet was
Een eerdere versie van precies deze post beweerde dat een portscan “je een directe fail2ban-timeout oplevert”. Dat deed het niet. fail2ban reageert alleen op logregels, en de firewall logt gedropte pakketten met een bewust piepklein tempo, dus een scan verdween gewoon in het default-drop-beleid. Onschuldig, maar er werd ook niemand gebannen. De firewall had zelfs een paar sets met het label “port-scanner blocklist”, en niets wat met scans te maken had vulde ze ooit. De oplossing zit nu in de kernel: de laatste regel vóór de uiteindelijke drop telt verbindingspogingen per bron, en die ziet alleen pakketten voor gesloten poorten, dus normaal verkeer telt nooit mee. Een bron die blijft kloppen wordt een tijdje op alle poorten gedropt. Geen logs, geen daemon, geen parsing.
Bij het uitrollen kwam nog een val boven. De standaard-nftables-service herlaadt met flush ruleset, en op de Nextcloud-host bewaren kube-proxy, flannel en Calico hun regels ook in nftables. Dus elke firewallwijziging had ook het eigen netwerk van Kubernetes gewist, tot anderhalve minuut lang, tot het opnieuw synchroniseerde. Nu vervangt de ruleset alleen zijn eigen tabel, in één atomaire stap.
Dag vier tot zes: de logs lezen als een detective 🔎
Toen het stof was neergedaald, veranderde het werk van “laten werken” naar “blijven kijken”. Een paar dagen lang was de routine simpel: nextcloud.log, de containerlogs en het ingresslog lezen, en bij elke regel die vreemd oogde waarom vragen tot er een antwoord was. Eén voorwaarde maakte dat überhaupt mogelijk: het logniveau was verhoogd van 4 (alleen fatal) naar 2 (waarschuwingen). Op niveau 4 was niets van het volgende zichtbaar geworden. Een stil log is niet altijd een gezonde server. Soms is het gewoon een server op mute.
Gremlin #4: de jail die een dood bestand bewaakte
fail2ban draaide, de nginx-jails waren “actief”, en de banlijst was leeg. Dagenlang. Rustige week of kapotte jail? De ingress-controller schrijft zijn access log naar een bestand waarvan de naam eindigt op een teller (…/0.log, 1.log, …), en elke containerherstart begint een nieuw bestand. fail2ban expandeert de logpath-glob alleen als de jail start. Na een reboot komt fail2ban op vóór de ingresscontainer, haakt zich vast aan het oude bestand, en volgt dan trouw een log waar niemand meer in schrijft, op beide hosts. De oplossing is een kleine systemd-timer die merkt wanneer de set ingresslogbestanden verandert (en één keer na elke boot) en alleen de nginx-jails herlaadt. Een securitytool die “alles rustig” meldt omdat hij naar het verkeerde bestand kijkt is erger dan geen, want je denkt dat je gedekt bent.
Gremlin #5: het eigenaarschap-pingpong
Bij elke playbookrun gaf Nextclouds status.php even een fout en zakte de datamap voor zijn eigen schrijfbaarheidscheck, om later in dezelfde run vanzelf te herstellen. De boosdoener waren twee rollen die het oneens waren. De SELinux-rol maakte de hostPath-mappen aan als root:root, en de deployrol zette ze op 33:33 (www-data). Elke run wisselde de eigenaar heen en weer, en tot de volgende rol het terugzette, keek Nextcloud tegen een datamap aan waarin het niet mocht schrijven. Nu zetten beide rollen dezelfde eigenaar en modus, en het pingpongen is voorbij. Twee rollen die elk iets “juists” doen kunnen samen toch een bug opleveren.
Gremlin #6: Office-previews en de muur van 1 MB
Kleine Word- en Excel-bestanden kregen mooie thumbnails in de bestandslijst, grotere niet. Geen fout in de UI, alleen het generieke icoon. Het ingresslog had het antwoord: 413 Request Entity Too Large bij elke convert-to-aanroep naar Collabora. Nextcloud rendert Office-previews door het document naar Collabora te uploaden, en de standaardlimiet van nginx voor de requestbody is 1 MB. De Nextcloud-route had een royale limiet, maar de Collabora-route kreeg er nooit een. Eén annotation (client-max-body-size: 2g) loste het op, en de getroffen previews kunnen gewoon opnieuw worden gegenereerd. De paar resterende convert-to-fouten zijn documenten die Collabora echt niet kan openen, en dat is een bestandsprobleem, geen configprobleem.
Gremlin #7: de foto van 108 megapixel
Sommige foto’s bleven zonder thumbnail, en de app kreeg steeds een 404 voor hun previews. Ze kwamen allemaal van één telefoon, met 108 megapixel en 12.032 pixels breed. Een afbeelding van dat formaat decoderen kost zo’n 430 MB RAM, en preview_max_memory van Nextcloud staat standaard op 256 MB. Daarboven probeert Nextcloud het niet eens. Het slaat de preview stilletjes over. Verhoogd naar 512 (PHP’s eigen limiet ligt ver daarboven), en de foto’s kregen eindelijk hun thumbnails.
Meteen meegenomen: ook iPhone-HEIC-foto’s kregen previews. Dat is één regel in enabledPreviewProviders, met een addertje: die key instellen vervangt de ingebouwde standaardlijst in plaats van hem uit te breiden, dus de standaarden (PNG, JPEG, GIF, tekst, OpenDocument…) moeten herhaald worden, anders heb je HEIC-previews en geen JPEG-previews meer. Wat nu nog zonder preview is, is een kwestie van data, niet van configuratie: een paar dozijn resten van 400 bytes van een jaren geleden mislukte upload, wat lege bestanden en een handvol PNG’s groter dan 50 MB.
Gremlin #8: de config die nooit aankwam
Toen ik de vorige fix na een playbookrun controleerde, kwam er iets ergers boven. De nieuwe waarden stonden in de Kubernetes-ConfigMap, maar de custom.config.php in de draaiende pod was een dag oud. Het bestand is gemount met subPath, en een subPath-mount wordt één keer bij het starten van de container gekopieerd en nooit bijgewerkt. Kubernetes werkt normale ConfigMap-volumes live bij, maar subPath-mounts niet. Dus elke configwijziging in de repo werd pas actief bij de volgende toevallige podherstart. (De previewfix werkte in de tussentijd alleen omdat die ook via occ was ingesteld.)
De standaardoplossing is een checksum/config-annotation op de podtemplate: een SHA-256 over de gerenderde configtemplates. Verander de config en de hash verandert, waardoor Kubernetes de pod opnieuw uitrolt. Laat de config met rust en er gebeurt niets. De blog kreeg dezelfde behandeling voor zijn nginx- en PHP-configs. Les: “het playbook draaide groen” en “de instelling is actief” zijn twee verschillende beweringen, dus controleer het bestand in de container.
Hoe een gezond log eruitziet 🩺
Na dat alles is de dagelijkse review saai geworden, en dat is precies de bedoeling. Een gewone dag heeft nu een handvol regels in nextcloud.log: een preview die niet geopend kon worden, een PHP-notice. De rest is ruis die je het best uit je hoofd kent, zodat je niet elke ochtend op spokenjacht gaat:
- Collabora “Broken pipe” / “Connection reset”, zo’n 60 per uur, zelfs om 3 uur ’s nachts: de andere kant sloot de verbinding voordat Collabora klaar was met schrijven. Onschuldig.
- nginx “access forbidden” op
/data/.ncdataen/.env: het eerste is Nextclouds eigen securitycheck die verifieert dat de datamap niet via het web bereikbaar is, het tweede is een bot. Beide bewust geblokkeerd. - “config differs from the latest version of this image” bij elke podstart: de rol beheert die bestanden zelf (Redis met een wachtwoord, bijvoorbeeld), dus ze horen te verschillen.
- notify_push “Self test failed” direct na een reboot: de TLS-check faalt één keer met een certificaatfout (waarschijnlijk serveert de ingress een paar seconden lang nog zijn standaardcertificaat voordat het echte geladen is). Een minuut later is de self-test 6/6 groen.
Het gaat bij die lijst niet om de regels zelf. Als je eenmaal weet hoe onschuldig eruitziet, springt die ene regel die niet onschuldig is er meteen uit. Dat is de hele truc van logmonitoring. Het is geen magie, het is de baseline kennen.
Oordeel ✅
Het staat live. Certificaten geldig, Office-bewerking werkt, data intact, gebruikers merken er niets van. De migratie zelf was de makkelijke 20%; de andere 80% was een speurtocht naar instellingen en gedrag die alleen onder precies de nieuwe omstandigheden misgaan. Zoals altijd: de server was nooit het probleem — de aannames waren het. 😄
Dag drie voegde daar een voetnoot aan toe. De smerigste bugs waren niet de bugs die crashten — het waren de bugs die groen bleven: een vinkje, een fouttolerant playbook, een alertregel die niet kon afgaan. Als deze migratie me één gewoonte heeft geleerd, dan is het: controleer het ding zelf, niet het ding dat erover rapporteert. 🔍
Nog één ding: dit was niet mijn enige Nextcloud-rodeo. Ik beheer als vrijwilliger ook een tweede productie-instantie — kleiner, met minder data en minder geregistreerde gebruikers — en alles wat ik hier heb geleerd bleek echt nuttig. Dus die is de volgende: binnen twee weken migreer ik hem naar dezelfde K3s-stack, hopelijk met veel minder van deze landmijnen de tweede keer. 🤞
De volledige Ansible-stack achter dit alles — de WordPress- en Nextcloud-rollen, de ingress, cert-manager, de monitoring en elke hardeningtruc die hierboven genoemd is — staat op GitHub, ontdaan van secrets en hostspecifieke details: github.com/aptupgrademe/www_k3s. Deze migratie is de mijlpaal v3.0.0, dus je kunt precies de toestand bekijken die in deze post beschreven wordt, in plaats van wat HEAD vandaag toevallig is.
📚 Meer in deze serie: Nextcloud van bare metal naar K3s