
Een kerstvideo voor het team – half cloud, half homelab
Een kerstvideo voor ons monitoringteam, gemaakt met AI: de scènes met mensen uit de cloud; geluid, muziek, montage en afwerking op mijn eigen hardware. Wat waar beter werkte – en wat toch nog misging.
🌐 Ook in: English · Deutsch · Français · Español · Italiano · Português · Polski
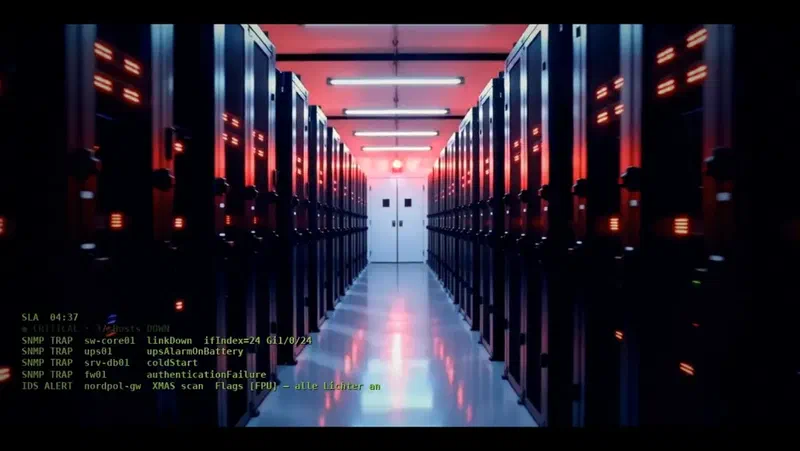
Voor de interne adventskalender van ons monitoringteam wilde ik een korte video: in het datacenter springen de leds van groen naar rood, alarm, hartslag, terugspoelen – en aan het eind is natuurlijk de Kerstman de schuldige, die over een “wifikabel” is gestruikeld. Het resultaat is net geen 100 seconden film, die ik in meer dan 70 versies heb bijgeschaafd met Claude Code als regieassistent.
Interessanter dan de film zelf is de vraag welke delen uit de cloud kwamen en welke op mijn eigen hardware draaiden. Kort gezegd: de beelden die ertoe doen kwamen uit de cloud – al het andere draaide lokaal.
Inhoud
☁️ Uit de cloud: de scènes met mensen
Voor de eigenlijke videoscènes gebruikte ik ArtCraft, een abonnement dat toegang geeft tot meerdere commerciële modellen:
- Seedance 2.0 (video): datacenter, monitoringcentrum, close-up van de leds, de Kerstman met het geïrriteerde rendier. Een clip van 4 seconden in 720p kost zo’n 100 credits.
- Nano Banana Pro (beeldbewerking): de groepsfoto – collega’s als silhouetten, kerstmutsen, sneeuw. 15 credits per beeld.
Ik bediende ArtCraft niet via de interface, maar via een MCP-server: Claude Code schrijft de prompt, uploadt referentiebeelden en haalt het resultaat op. Met één vaste regel: vóór elke job noemt Claude de kosten en wacht op mijn “Start” – een ingediende job kun je niet terugroepen.
De les: voor realistische mensen in beweging loopt de cloud vandaag duidelijk voor. Maar elke clip kost echt geld, en credits gaan sneller op dan je denkt – aan het eind was het saldo leeg voordat het laatste idee af was.
🖥️ Lokaal: alles rondom de beelden
Een machine met een RTX-videokaart (8 GB videogeheugen) deed de rest:
- ComfyUI als raamwerk voor de lokale modellen
- MMAudio: geluidseffecten die bij het beeld passen – snuivende rendieren, ritselende kabels, het struikelen
- ACE-Step: muziekschetsen in verschillende stijlen; de uiteindelijke video gebruikt een royaltyvrij episch nummer uit een muziekbibliotheek
- Chatterbox (text-to-speech): de verteller
- Whisper: controle of “Icinga” en “Zabbix” duidelijk worden uitgesproken
- RIFE: AI-tussenbeelden voor de slow motion
- ffmpeg en Python: knippen, overgangen, tekst, iris wipe, typemachine-aftiteling, het terminaleinde met
systemctl status weihnachtenen loudness-mastering
Lokaal kosten pogingen alleen stroom en tijd. Daar gebeuren de meeste iteraties: de ene stem klonk blikkerig, de andere had een Engels accent, de muziek was te poppy – twaalf varianten van één zin zijn lokaal geen probleem.
De les: de cloud levert het dure ruwe materiaal, het homelab maakt er een film van. Zo blijven de kosten laag en houd je zelf de controle.
🎞️ Waar lokaal niet genoeg is – en waar het beter is
Eerst probeerde ik ook de videoscènes lokaal te maken, met Wan 2.1/2.2. Met 8 GB videogeheugen waren de resultaten grof: primitieve gezichten, onnatuurlijk lopen, te korte clips.
Zo zag dat er in de praktijk uit – hetzelfde datacenteralarm, volledig gegenereerd op de pc thuis (een RTX 3050-videokaart met 8 GB): eerst een ruwe schets met Wan 2.1 (1.3B), daarna verfijnd met Wan 2.2 A14B. Vergelijk het met de teaser hierboven, waar de scènes met mensen uit de cloud komen.
Andersom was de “slimmere” AI soms de slechtere keuze:
- Upscaling naar 1080p: Real-ESRGAN maakte randen scherper, maar oppervlakken wasachtig. Klassieke upscaling met wat lichte verscherping zag er natuurlijker uit.
- Tussenbeelden: de motion estimation van ffmpeg gaf blokartefacten bij snelle handen en bij de ledpatronen van de racks. RIFE was veel schoner – alleen waar de led van groen naar rood springt, verzon ook RIFE een verkeerd frame. Op die plek staat nu het origineel.
De les: “meer AI” is niet automatisch beter. Elk hulpmiddel verzint ergens details die niet bestaan – en die moet je vinden.
👀 Controleren wat je niet kunt zien
Claude kan video niet afspelen en niet horen. Dus gingen de controles via een omweg: losse frames en contact sheets, loudness per scène (de scènes lagen eerst tot 15 dB uit elkaar), spraakherkenning voor de uitspraak en verborgen vocals, beeldvergelijking voor exacte overgangen.
Toch vond ik fouten die geen meting liet zien: een vrouwelijk “Aaa” dat eigenlijk een artefact aan het eind van de stemopname was, een grijze, ruizige achtergrond na een beeldfilter, een tekstoverlay die tijdens een crossfade door de ruimte vloog. En één keer deed een verlenging van 2,5 seconden gewoon niets – zonder foutmelding.
De les: meten vervangt kijken niet. Tools vinden niveaus en formaten, mensen vinden wat er “raar” uitziet.
🔧 Update november 2026: wat er sindsdien bij is gekomen
Na de kerstvideo heb ik een paar korte privéclips gemaakt: een parachutesprong boven een stad, een autostunt met twee auto’s, een dans op Mars, een breakdance op een plein. Onderweg groeide de gereedschapskist:
- Begin- en eindframes voor Seedance: eerst kon de MCP-server alleen referentiebeelden doorgeven. Ik heb hem uitgebreid zodat een clip met een gegeven beeld kan beginnen en op een ander kan eindigen. Een scène begint dan precies waar de vorige ophield, en als begin- en eindframe hetzelfde beeld zijn, landt de persoon na een wilde beweging weer in de beginhouding. Het werkt niet altijd: één keer negeerde het model het beginframe volledig.
- Meerdere referentiefoto’s voor één gezicht (Nano Banana Pro): met één foto drijft het gezicht af. Zes tot acht foto’s uit verschillende hoeken brengen het duidelijk dichterbij. Grootte telt ook: een gezicht dat maar 60 pixels breed in beeld is, wordt grotendeels verzonnen.
- Lokale face swap (InsightFace met GFPGAN): waar het cloudgezicht nog niet klopte, zet een face swap op mijn eigen machine het echte gezicht in het stilstaande beeld, gemiddeld over meerdere referentiefoto’s. Een gezichtsherkenningsmodel meet het resultaat: de gelijkenis steeg van ongeveer 0,5 naar 0,87. De grenzen: het vervangt het gezicht maar niet het haar, het neemt de uitdrukking van het doelbeeld over, en bij snelle beweging flikkert het. Daarom gebruik ik het alleen waar het gezicht rustig is.
- Optical flow en achtergrondverwijdering (OpenCV, rembg): optical flow liet in getallen zien dat de camera in één clip drie seconden naar achteren dreef, iets wat me wel was opgevallen maar wat ik niet kon bewijzen. rembg sneed de auto uit, zodat kunstmatige bandenrook erachter kon in plaats van eroverheen.
- Geluid in lagen: motor- en bandengeluid als aparte MMAudio-lagen per scène, onder een doorlopende ACE-Step-soundtrack die onder de effecten wegduikt. Een verrassing: de limiter van ffmpeg verhoogt standaard het niveau. Pas met
level=disabledbleven de pieken onder 0 dBFS; eerdere mixen waren zo’n 2 dB te luid.
De les: de cloud levert nog steeds de beweging, maar het lokale deel is gegroeid van montage naar reparatie. Gezichten, camerafouten en geluid worden nu thuis gerepareerd in plaats van te betalen voor een nieuwe clip.
🧾 De rekening
- Cloud: een maandabonnement plus credits – bijna alles voor een handvol clips van 4 seconden en een paar beeldbewerkingen.
- Lokaal: geen lopende kosten, maar wel GPU-tijd – de hele film upscalen duurt ongeveer 45 minuten.
- Tijd: de grootste post. De meeste versies gingen op aan timing, geluid en details, niet aan nieuwe scènes.
De les: het geld zit in een paar cloudclips, de tijd in veel lokale iteraties.
🎯 De lessen
- Cloud voor mensen, lokaal voor al het andere – een homelab met 8 GB kan vandaag geen realistische mensen in beweging maken.
- Bevestig de kosten vóór elke cloudjob – ingediend is ingediend.
- Sla elke versie onder een nieuwe naam op – meer dan eens was een oudere de betere.
- Zet AI-tools selectief in – soms is de klassieke methode eerlijker dan het model.
- Kijk en luister zelf – metingen laten zien of iets klopt, niet of het werkt.
- Repareer lokaal voordat je opnieuw genereert – een face swap of een knip kost niets, een nieuwe clip van 10 seconden kost 250 credits.