
Mijn vrouw was sneller dan mijn monitoring: Zabbix in containers bewaakt nu mijn thuisnetwerk
Een wifi-accesspoint gaf geen antwoord meer, en de enige die het merkte was mijn vrouw. Sindsdien draait Zabbix 7.0 LTS rootless in Podman-containers op mijn thuisserver en stuurt het een mail zodra een apparaat stil wordt. De opzet, de valkuilen en waar je wat vindt in de interface.
🌐 Ook in: English · Deutsch · Français · Español · Italiano · Português · Polski
In het kort: Iets meer dan twee weken geleden kwam mijn vrouw thuis en had ze geen wifi. Het accesspoint op de begane grond reageerde niet eens op een ping. Stroom eraf, stroom erop, en sindsdien is alles in orde. Niemand had het gemerkt behalve zij, en dat geldt ook voor mijn monitoring. Nu draait een Zabbix 7.0 LTS in vier rootless Podman-containers op mijn NAS-server en stuurt het een mail zodra een onderdeel van het thuisnetwerk niet meer antwoordt. Deze post gaat over de opzet, wat ik er extra bij moest configureren, waar het vastliep en waar je wat vindt in de webinterface.
Inhoud
📶 Hoe het begon
Mijn vrouw kwam thuis, haar telefoon toonde geen wifi en ze was – begrijpelijk – not amused. Ik kon het meteen bevestigen: het accesspoint op de begane grond was onbereikbaar, niet via de webinterface en niet via ping. Stekker eruit, een paar seconden wachten, stekker erin. Sindsdien draait het al zo’n 14 dagen zonder hapering. Waarom het eruit lag weet ik nog steeds niet. Het is een van die dingen die één keer gebeuren en weigeren het nog eens te doen.
Wat me veel meer dwarszat was iets anders: waarom hoorde ik het van mijn vrouw en niet van mijn monitoring? Het antwoord is simpel. Prometheus en Grafana bewaken mijn servers, en een uptime-check test elke vijf minuten van buitenaf of de blog en Nextcloud bereikbaar zijn. Niemand hield de kleine kastjes in het thuisnetwerk in de gaten – router, repeaters, switch, telefoonbasisstation, zonne-omvormer. Die hebben geen agent; je kunt ze alleen vragen of ze antwoorden.
De les: Monitoring dekt precies af waarvoor je het gebouwd hebt. De gaten zitten vaak bij de onopvallende apparaten die gewoon werken – tot ze dat niet meer doen.
🔭 Wat is Zabbix?
Zabbix is open-source monitoringsoftware: het houdt continu servers, netwerkapparatuur, applicaties en diensten in de gaten. Alexei Vladishev begon er in 2001 aan als interne tool, en versie 1.0 verscheen in 2004. Tegenwoordig wordt het ontwikkeld door Zabbix SIA in Riga, Letland. De software is volledig gratis – er is geen betaalde “enterprise edition” met achtergehouden features; het bedrijf verdient zijn geld met support, trainingen en certificering. Tot versie 6.4 viel Zabbix onder de GPLv2, sinds 7.0 onder de AGPLv3. Elke anderhalf jaar verschijnt een LTS-release die vijf jaar onderhouden wordt.
Waar Zabbix om bekendstaat:
- Alles in één. Dataverzameling, opslag, alertregels, notificaties, dashboards, kaarten en rapporten zitten in één product met één webinterface. Met Prometheus en Grafana zijn dat meerdere tools die je zelf aan elkaar knoopt.
- Met en zonder agent. De Zabbix-agent (tegenwoordig meestal Agent 2, geschreven in Go en uitbreidbaar met plugins) meet besturingssystemen en applicaties van binnenuit. Voor apparaten waarop je niets kunt installeren zijn er agentloze checks: ping, TCP-poorten, HTTP, SNMP, IPMI, SSH en meer.
- Netwerken en SNMP. Zabbix is vooral wijdverbreid bij switches, routers, firewalls, UPS’en en printers. Er bestaan kant-en-klare templates voor talloze apparaten.
- Templates en automatische discovery. Een template bundelt checks, alerts en grafieken. Met low-level discovery zoekt Zabbix zelf uit welke bestandssystemen, netwerkkaarten of schijven een apparaat heeft en maakt het de bijpassende checks aan.
- Grote omgevingen. Proxy’s verdelen de monitoring over veel locaties; Zabbix is gebouwd voor tienduizenden apparaten.
- Een complete API. Alles wat de interface kan, werkt ook via JSON-RPC – de hele configuratie voor deze post heb ik met een script tegen de API opgezet.
Waar je Zabbix tegenkomt: bij internetproviders en telecombedrijven, in datacenters, bij banken, overheden en universiteiten, op veel IT-afdelingen in het mkb – overal waar een gemengd landschap van servers, netwerkapparatuur en speciale apparaten vanaf één plek bewaakt moet worden.
De keerzijde: Zabbix is krachtig, en dat zie je aan de interface. De configuratie staat in de database in plaats van in tekstbestanden, wat “configuration as code” lastiger maakt dan met Prometheus. En de woordenschat – host, item, trigger, template, action – moet een keer bezinken voordat alles logisch wordt.
Trouwens: direct na de installatie toonde de kaart op het dashboard Riga – daar zit Zabbix.
De les: Zabbix is het Zwitserse zakmes onder de monitoringtools. Het speelt zijn sterke punten vooral uit bij veel verschillende apparaten zonder eigen agent.
🎯 Het doel en waarom Zabbix
De eis was bewust klein: een mail als een intern onderdeel niet meer antwoordt. Voor apparaten zonder agent betekent dat een ping waar het apparaat op pings reageert, en een TCP-verbindingstest op een poort als 80 of 443 waar het een webinterface heeft.
Er kwam een tweede wens bij: ik wil ook weten wanneer het internet zelf weg is – en dan één mail krijgen met “internet onbereikbaar” in plaats van vijf losse alerts, één per externe server.
Een klein script zou dat ook kunnen. Toch koos ik voor Zabbix, om twee redenen. Ten eerste levert Zabbix precies deze agentloze checks standaard mee, plus historie, grafieken, afhankelijkheden tussen alerts en mailverzending. Ten tweede wil ik uit professionele interesse meer praktijkervaring met Zabbix opdoen – zelf bouwen, zelf configureren, zelf op mijn bek gaan, in plaats van er alleen over te lezen. Het thuisnetwerk is een ideaal oefenterrein: echt genoeg om zinvol te zijn, klein genoeg dat een fout geen pijn doet.
Ik koos Zabbix 7.0 LTS (7.0.32). Versie 8.0.0 was net uit, maar ik hoef niet vooraan in de rij te staan voor een punt-nul-release terwijl ik tegelijk de tool aan het leren ben.
De les: Als je een nieuwe tool leert, wint een echt, klein probleem het van een demo. En een LTS-release haalt één onbekende uit de vergelijking.
🧱 De opzet: vier containers, geen root
Zabbix draait op HP3, mijn NAS-server met Debian en ZFS. Die staat toch al dag en nacht aan en heeft ruim speelruimte (4 cores, 32 GB RAM, waarvan meer dan een derde vrij). De opzet bestaat uit vier containers:
| Container | Taak | Geheugenlimiet |
|---|---|---|
| PostgreSQL 17 | configuratie, meetwaarden, historie | 1 GB |
| zabbix-server | voert de checks uit, evalueert ze, verstuurt mail | 768 MB |
| zabbix-web | webinterface (nginx + PHP) op poort 8080 | 512 MB |
| zabbix-agent2 | meet HP3 zelf: CPU, RAM, schijven, netwerk | 256 MB |
De belangrijkste beslissingen erachter:
- Rootless Podman in plaats van Docker als root. Alles draait onder mijn gewone gebruiker, dus een fout in een container komt niet als root op de NAS terecht.
- Quadlet in plaats van Compose. Elke container is een klein
.container-bestand onder~/.config/containers/systemd/. Podman maakt er gewone systemd-services van – met afhankelijkheden, herstart bij fouten en start bij het booten. Om user-services te laten starten zonder dat iemand inlogt, heb je eenmaligloginctl enable-lingernodig. - Hostnetwerk in plaats van NAT. Met
Network=hostgaan pings en TCP-tests rechtstreeks het thuisnetwerk in, zonder de adresvertaling van Podman ertussen. PostgreSQL luistert op zijn beurt expliciet alleen op127.0.0.1. - Vaste limieten voor geheugen en CPU, zodat Zabbix de NAS nooit in de weg zit. In de praktijk gebruiken alle vier containers samen zo’n 180 MB.
- Geen wachtwoorden in bestanden. Het databasewachtwoord is een Podman-secret dat als bestand aan de containers wordt gegeven, en het adminwachtwoord van de webinterface heb ik direct na de eerste start via de API gewijzigd.
Dit is het bestand voor de server:
[Unit]
Description=Zabbix server
Requires=zabbix-db.service
After=zabbix-db.service

[Container]
ContainerName=zabbix-server
Image=docker.io/zabbix/zabbix-server-pgsql:alpine-7.0.32
Network=host
Environment=DB_SERVER_HOST=127.0.0.1 POSTGRES_USER=zabbix POSTGRES_DB=zabbix
Environment=POSTGRES_PASSWORD_FILE=/run/secrets/zabbix-db-pw
Secret=zabbix-db-pw
AddCapability=NET_RAW
PodmanArgs=--memory=768m --cpus=1

[Service]
Restart=always

[Install]
WantedBy=default.target
De les: Quadlet maakt van containers gewone systemd-services. Je hebt geen container-orchestrator nodig, en systemctl --user status toont alles op één plek.
💾 Waar komt de database?
Een voor de hand liggende vraag was of de database op de systeem-SSD hoort of in de ZFS-pool die eigenlijk voor de bestandsshares bedoeld is. Ik koos de pool. HP3 bevat alleen SSD’s, ook de drie schijven in de RAIDZ1 – snelheid is dus geen argument tegen de pool. Daar overleeft de database in ruil daarvoor het verlies van een schijf, ZFS herkent beschadigde blokken via checksums, en de map staat in mijn home-dataset, die de backup-pc ’s nachts toch al kopieert. De systeem-SSD heeft meer dan 400 GB vrij, maar het is één enkele schijf en zit niet in de backup.
De hoeveelheden data zijn bescheiden: na de eerste dag is de database kleiner dan 100 MB. Een eigen ZFS-dataset met een op PostgreSQL afgestemde blokgrootte zou netter zijn, maar daarvoor is root nodig – bij deze omvang niet de moeite waard.
De les: De snelste schijf is niet automatisch de juiste. Voor een database tellen redundantie en backup zwaarder dan de laatste paar procent performance.
📡 Wat er bewaakt wordt
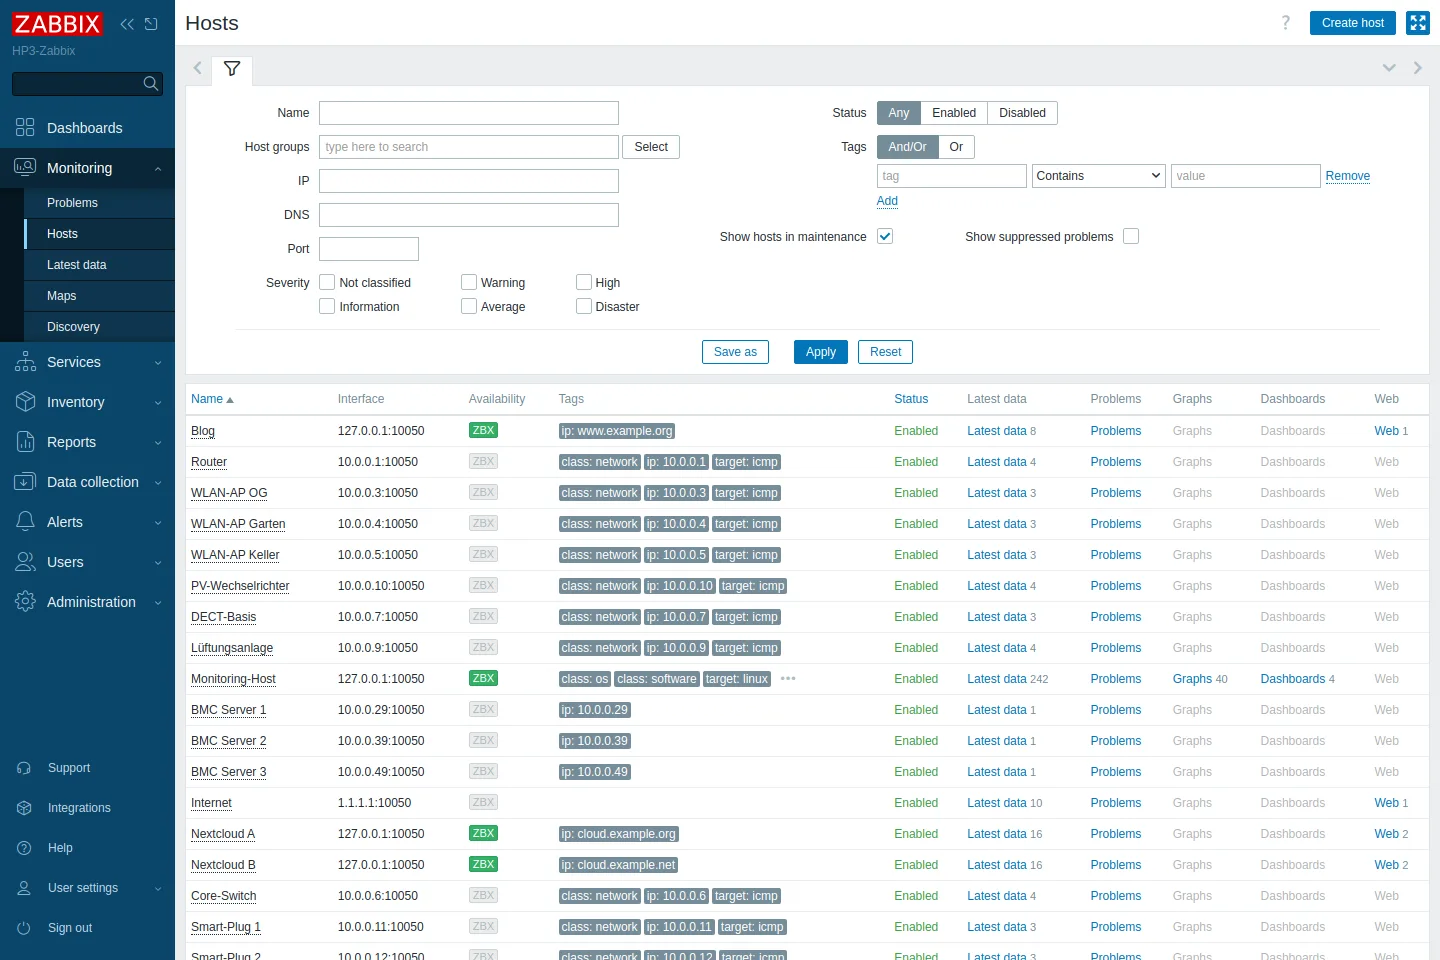
In Zabbix is het netwerk opgesplitst in twee hostgroepen: LAN voor de apparaten in huis en External voor mijn servers in het datacenter.
In het LAN controleert Zabbix elke minuut:
- Ping naar de router, de drie wifi-repeaters, de switch, het telefoonbasisstation, het ventilatiesysteem, de zonne-omvormer en twee slimme stekkers. Zabbix levert hiervoor het template ICMP Ping mee. Het meldt een apparaat als onbeschikbaar wanneer drie pings op rij onbeantwoord blijven – dus na ongeveer drie minuten. Eén verloren ping slaat geen alarm.
- Een TCP-poort extra overal waar een webinterface draait: 443 op de router en de switch, 80 op het ventilatiesysteem en de omvormer. De key is
net.tcp.service[tcp,<ip>,<port>], en ook dit alert gaat pas af na drie mislukte pogingen. - Alleen TCP 443 voor de remote-managementcontrollers (BMC) van de drie servers. Die zitten in hetzelfde netwerk, maar waar het om gaat is of hun interface antwoordt.
Een detail dat ik zonder Zabbix niet had gehad: het poortalert hangt af van het ping-alert. Valt een apparaat helemaal uit, dan krijg ik één mail (“unavailable by ICMP ping”), niet twee. Pas als het apparaat wel op ping reageert maar de webinterface niet, laat het poortalert van zich horen.
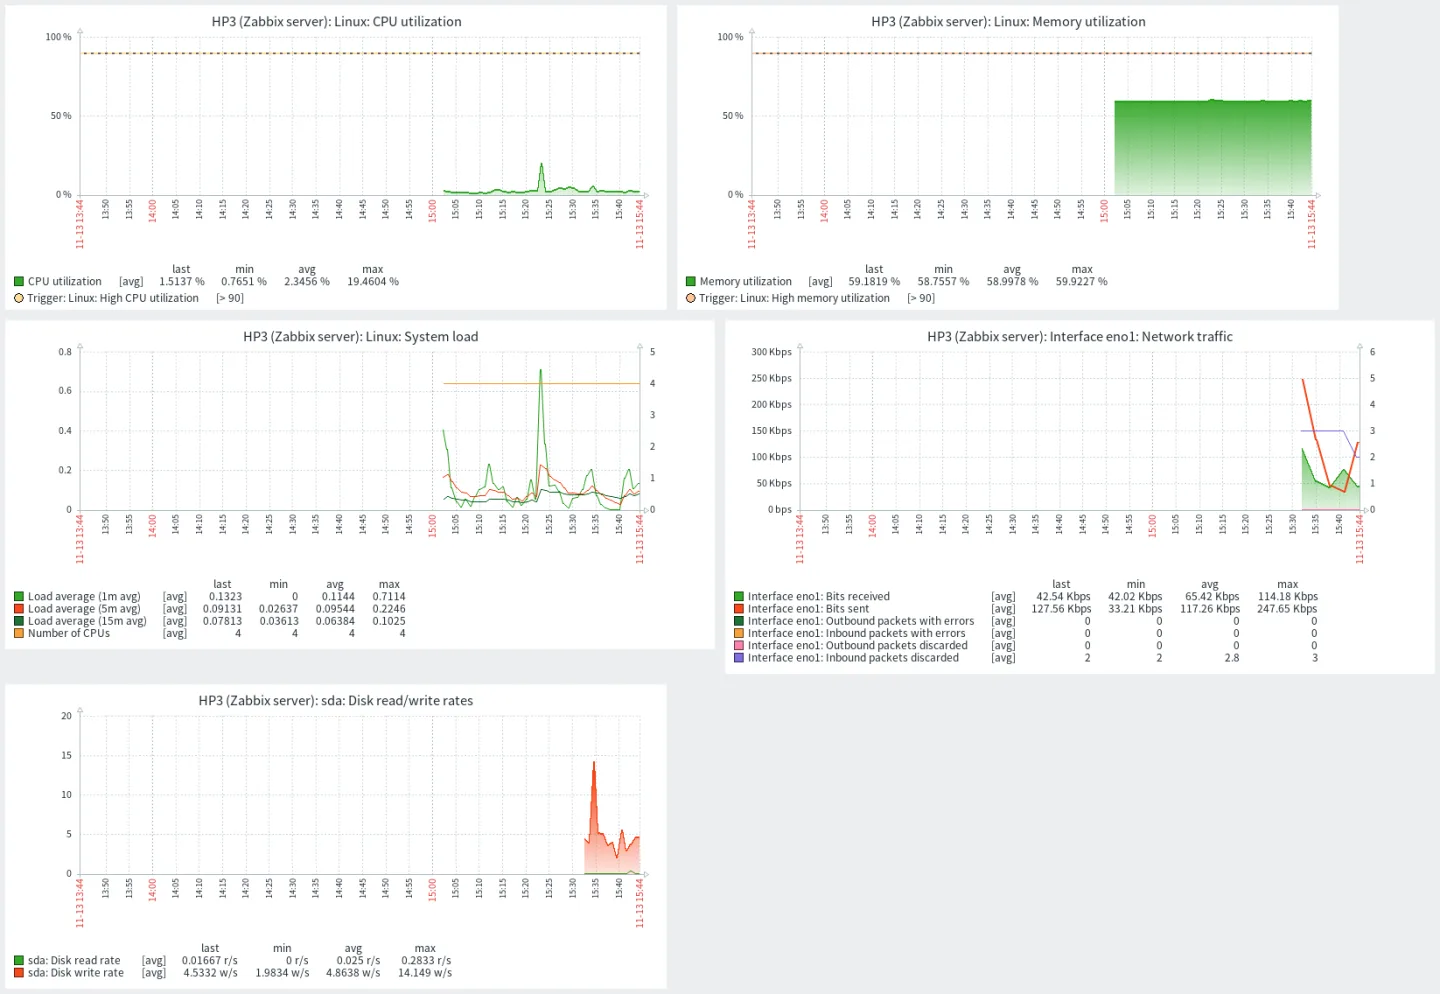
HP3 zelf wordt door Agent 2 gemeten: CPU, RAM, load, swap, processen, elke netwerkkaart, de ZFS-datasets en de I/O van de vier SSD’s. Het template Linux by Zabbix agent dekt dat allemaal af, en Zabbix maakt de grafieken zelf aan.
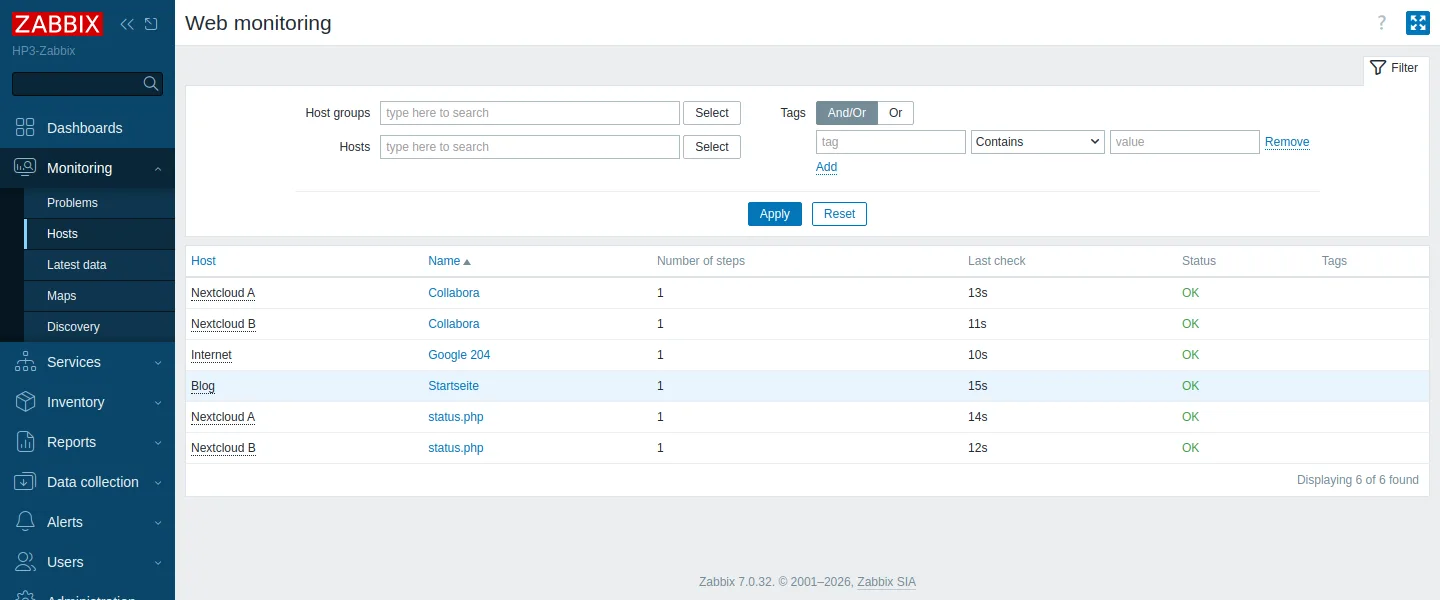
De externe servers – de blog en twee Nextcloud-instanties – worden gecontroleerd via web scenarios: elke twee minuten één request, met HTTP 200 en een bepaald stuk inhoud als verwachting. Bij de blog is dat het einde van de voorpagina, bij Nextcloud moet status.php de tekst "maintenance":false bevatten, bij Collabora moet de WOPI-discovery antwoorden. Daarnaast leest de agent elke zes uur de TLS-certificaten en waarschuwt hij 14 dagen voordat ze verlopen.
Het internet zelf wordt gecontroleerd door een aparte host met de naam “Internet”: elke minuut pingt die twee onafhankelijke publieke DNS-servers (1.1.1.1 en 9.9.9.9) en haalt hij https://www.google.com/generate_204 op, een adres dat precies voor dit soort connectiviteitstests bedoeld is en alleen “204 No Content” teruggeeft. Het alert “internet onbereikbaar” gaat pas af als beide servers drie keer op rij zwijgen – een hapering bij één provider is geen internetstoring. De alerts van de externe servers hangen ervan af: ligt het internet eruit, dan komt er precies één mail.
Wat ik bewust niet controleer op deze servers is SSH of open poorten. Een kale verbinding met poort 22 zonder in te loggen belandt in het log van sshd, en fail2ban kan daar een ban van mijn eigen thuis-IP van maken. Een snelle test van meerdere poorten zou de port-scan-blokkade van de firewall triggeren. Eén HTTPS-request per twee minuten daarentegen is een volkomen normale bezoeker.
De les: Goede alerts zijn zuinig. Drie mislukte pogingen in plaats van één en afhankelijkheden tussen alerts zorgen ervoor dat een mail ook echt iets betekent.
🐛 De valkuilen
Geen opzet zonder verrassingen. Dit waren de leerzaamste:
- Ping werkte eerst helemaal niet. Elke ping-check eindigde met
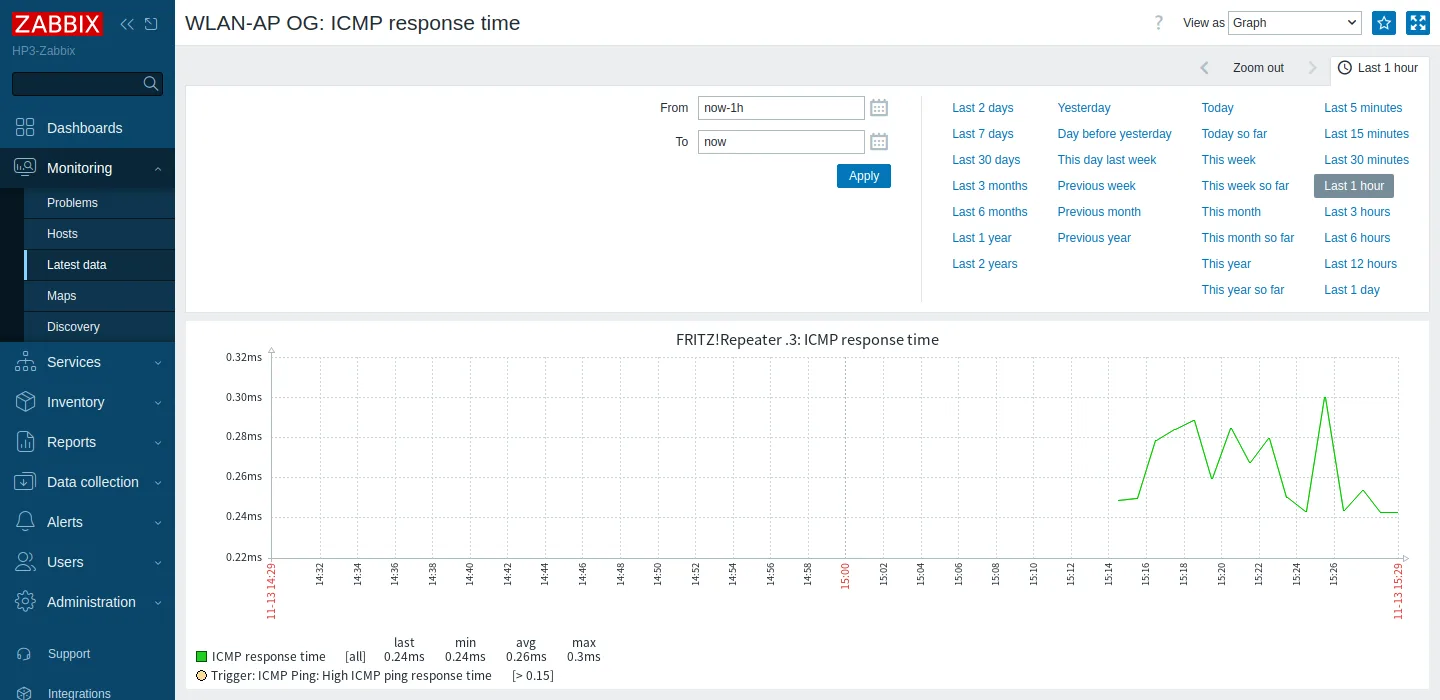
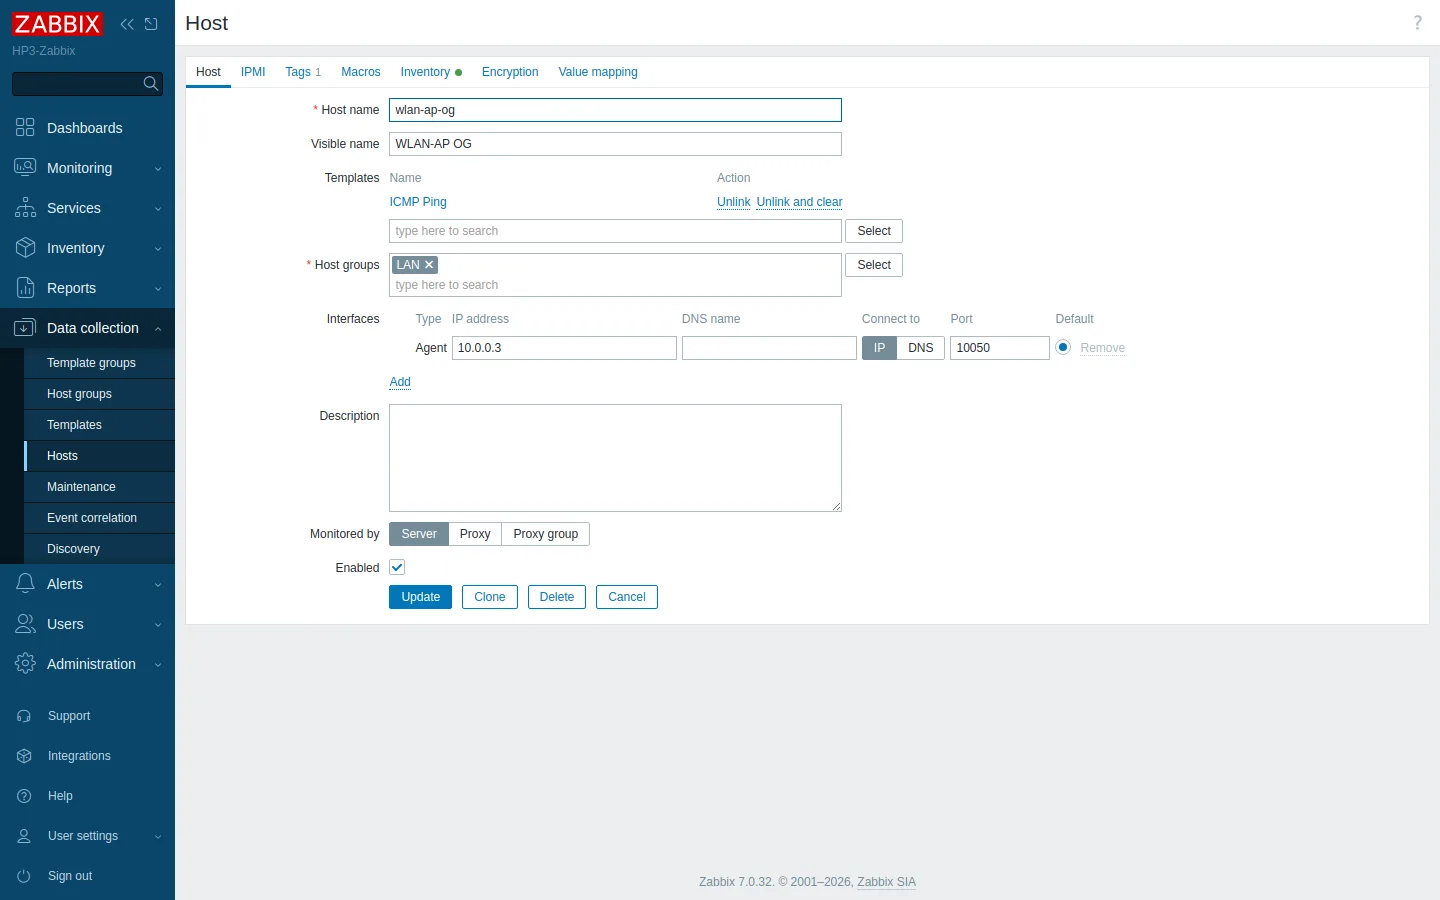
sh: /usr/sbin/fping: Operation not permitted. In het serverimage heeftfpingde file capabilitycap_net_raw=ep. Ontbreekt die capability in de container, dan weigert de kernel het programma überhaupt te starten – niet alleen de ping. De oplossing was één regel:AddCapability=NET_RAWin het Quadlet-bestand van de server. - Een uitroepteken in de hostnaam. Zabbix weigert “FRITZ!Box” als hostnaam. De technische naam staat alleen letters, cijfers, spaties, punten, underscores en koppeltekens toe. Daarom scheidt Zabbix de technische naam van de visible name – die tweede zie je overal.
- Een “vrij” IP was niet vrij. Voor de mailtest wilde ik een storing simuleren en liet ik een testapparaat wijzen naar een adres dat bij mijn ping-scan niet had geantwoord. Zabbix meldde toen 66 % pakketverlies – er zat dus toch iets, het antwoordde alleen onbetrouwbaar. Voor tests gebruik ik nu een adres uit de documentatierange (192.0.2.1, RFC 5737), dat gegarandeerd nooit antwoordt.
- Een verse Zabbix-installatie stuurt geen mail. De action die problemen aan de beheerders meldt is standaard uitgeschakeld, en de admin-gebruiker heeft geen mailadres. Zonder deze twee stappen ziet alles er groen uit en komt er toch nooit een alert aan.
- De agent in een container ziet de host niet automatisch. CPU-, RAM-, netwerk- en schijfstatistieken komen sowieso uit de kernel van de host. Voor de bestandssystemen heb ik de root van de host read-only onder
/hostfsgemount en met een macro alleen de echte bestandssystemen toegelaten; anders verschijnen de interne overlay-mounts van Podman. De schijven vond de agent pas toen de device-bestanden/dev/sdatot en met/dev/sddin de container zichtbaar waren – al leest hij alleen/proc/diskstats. - Tijdzone en tijdnotatie. De interface stond op UTC en toonde “03:26 PM”. Onder Administration → General → GUI heb ik Europe/Berlin en de 24-uursnotatie ingesteld.
De les: Geen van de problemen zat in Zabbix zelf. Ze zaten op de naden: container en kernel, testdata en werkelijkheid, standaardinstellingen en verwachtingen.
✉️ De test: een geënsceneerde storing
Een mailconfiguratie is pas bewezen als er een mail binnenkomt. Zabbix gebruikt hetzelfde SMTP-account dat HP3 al voor zijn statusmails gebruikt (poort 587, STARTTLS). Voor de test liet ik een apparaat naar het documentatieadres wijzen en wachtte ik:
- Na ongeveer drie minuten kwam de mail “Problem: ICMP Ping: Unavailable by ICMP ping” binnen.
- Toen ik het adres weer naar een echt apparaat had laten wijzen, volgde “Resolved in 1m 0s”.
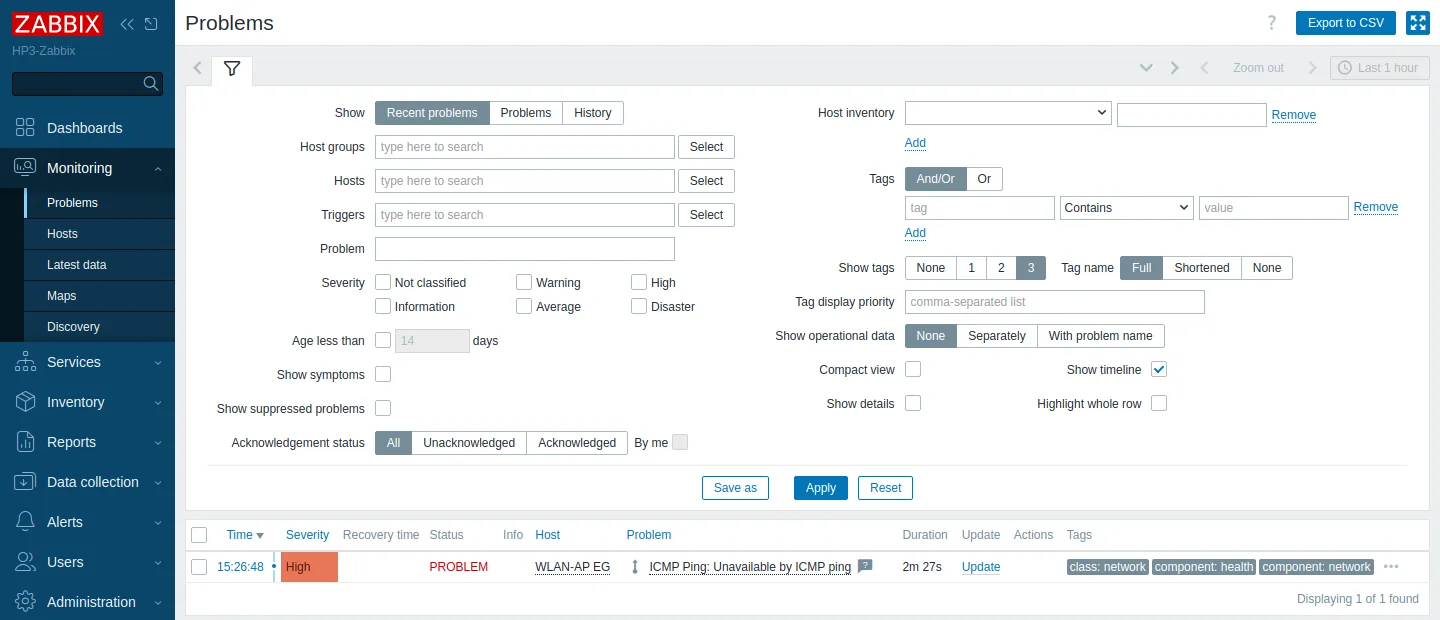
Het testapparaat heb ik daarna verwijderd. Voor de screenshots in deze post heb ik de storing nog een keer in scène gezet, met notificaties uit – daarom heet het uitgevallen accesspoint op de afbeeldingen “WLAN-AP EG” (begane grond).
De les: Een alert dat nooit getest is, is een aanname. Een bewust veroorzaakte storing kost vijf minuten en bewijst de hele keten van de ping tot de inbox.
🧭 Een rondleiding door de interface
Zabbix ziet er in het begin overweldigend uit: de navigatie heeft een flink dozijn hoofdingangen met veel subpagina’s. Voor dagelijks gebruik in een thuisnetwerk heb je echter maar een paar plekken nodig. Deze tabel is mijn EHBO-doos – daaronder legt elk item uit wat je er vindt.
| Ik wil … | Menu in Zabbix 7.0 |
|---|---|
| in één oogopslag zien of alles draait | Dashboards → Global view |
| weten wat er nu stuk is en een probleem bevestigen | Monitoring → Problems (knop Update) |
| zien wanneer iets in het verleden uitviel | Monitoring → Problems, filter History |
| de toestand van één bepaald apparaat controleren | Monitoring → Hosts, dan Latest data of Graphs |
| de laatste waarden van alle apparaten zien | Monitoring → Latest data |
| controleren of de blog en Nextcloud antwoorden | Monitoring → Hosts, kolom Web |
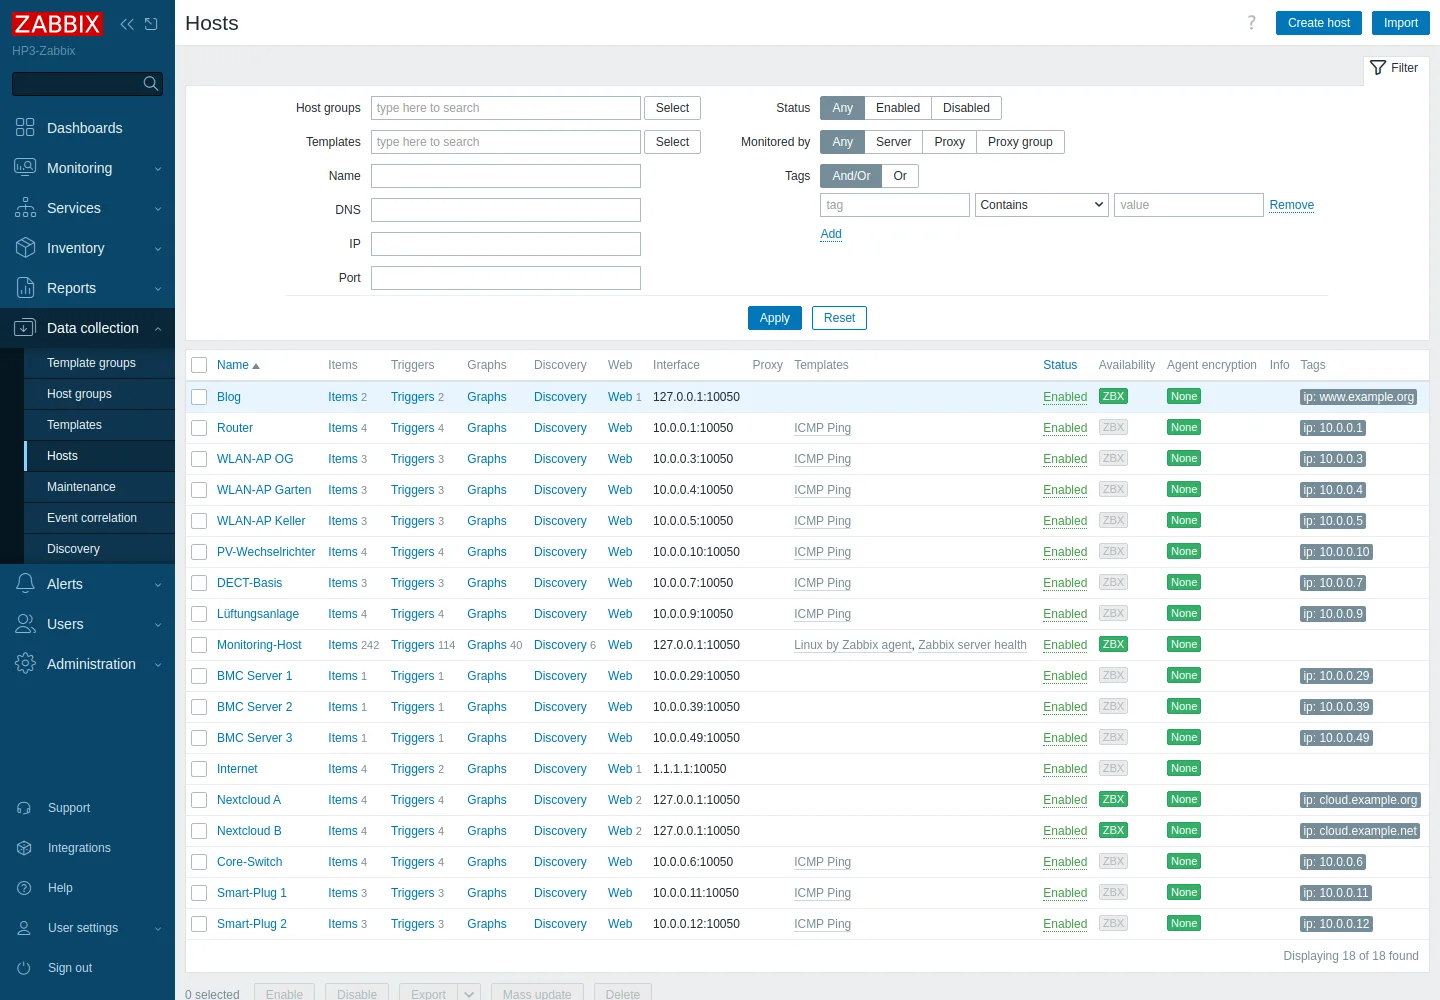
| een nieuw apparaat toevoegen | Data collection → Hosts → Create host |
| een poortcheck aan een apparaat toevoegen | Data collection → Hosts → apparaat → Items en Triggers |
| gepland onderhoud invoeren (geen mails) | Data collection → Maintenance |
| kant-en-klare checkbundels bekijken | Data collection → Templates |
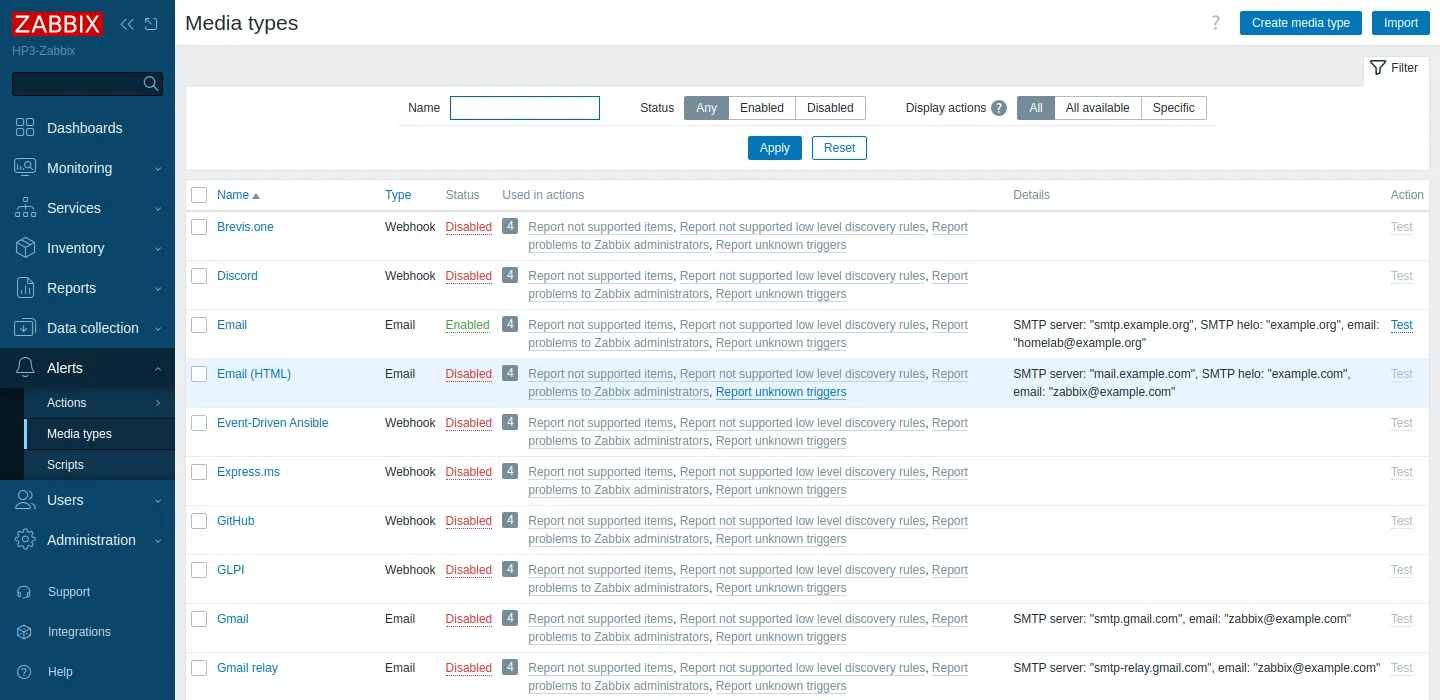
| de mailserver instellen en een testmail sturen | Alerts → Media types → Email (link Test) |
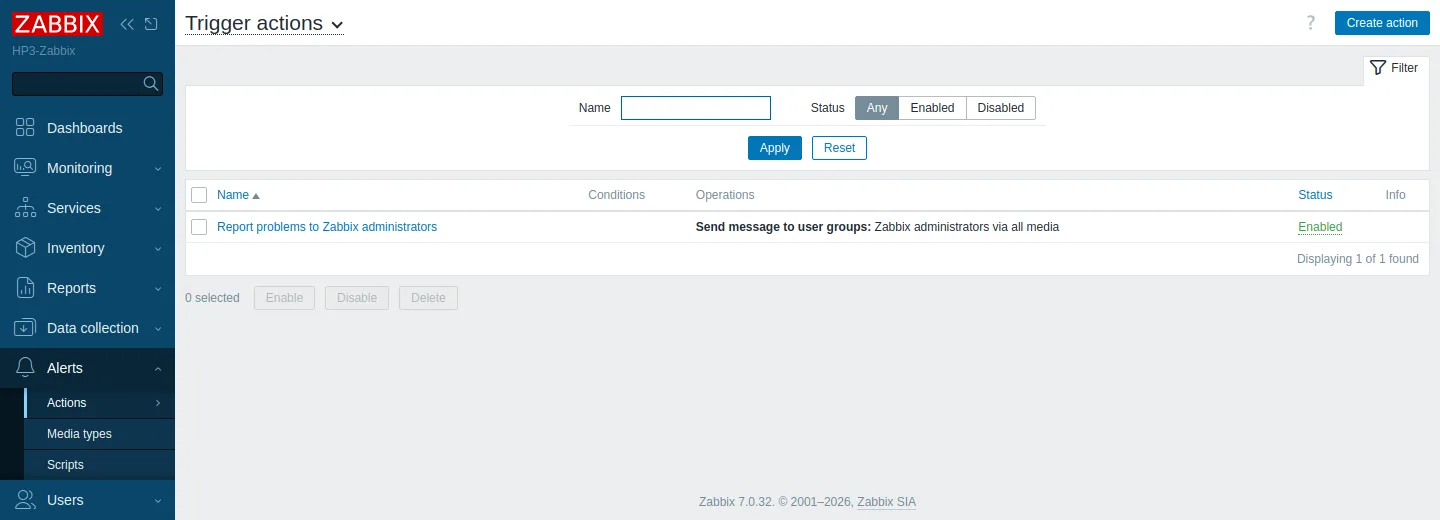
| bepalen wie over een probleem wordt geïnformeerd | Alerts → Actions → Trigger actions |
| mijn eigen mailadres invoeren | Users → Users → Admin → Media |
| zien welke mails verstuurd zijn | Reports → Action log |
| tijdzone en taal wijzigen | Administration → General → GUI |
| mijn eigen wachtwoord wijzigen | User settings → Profile |
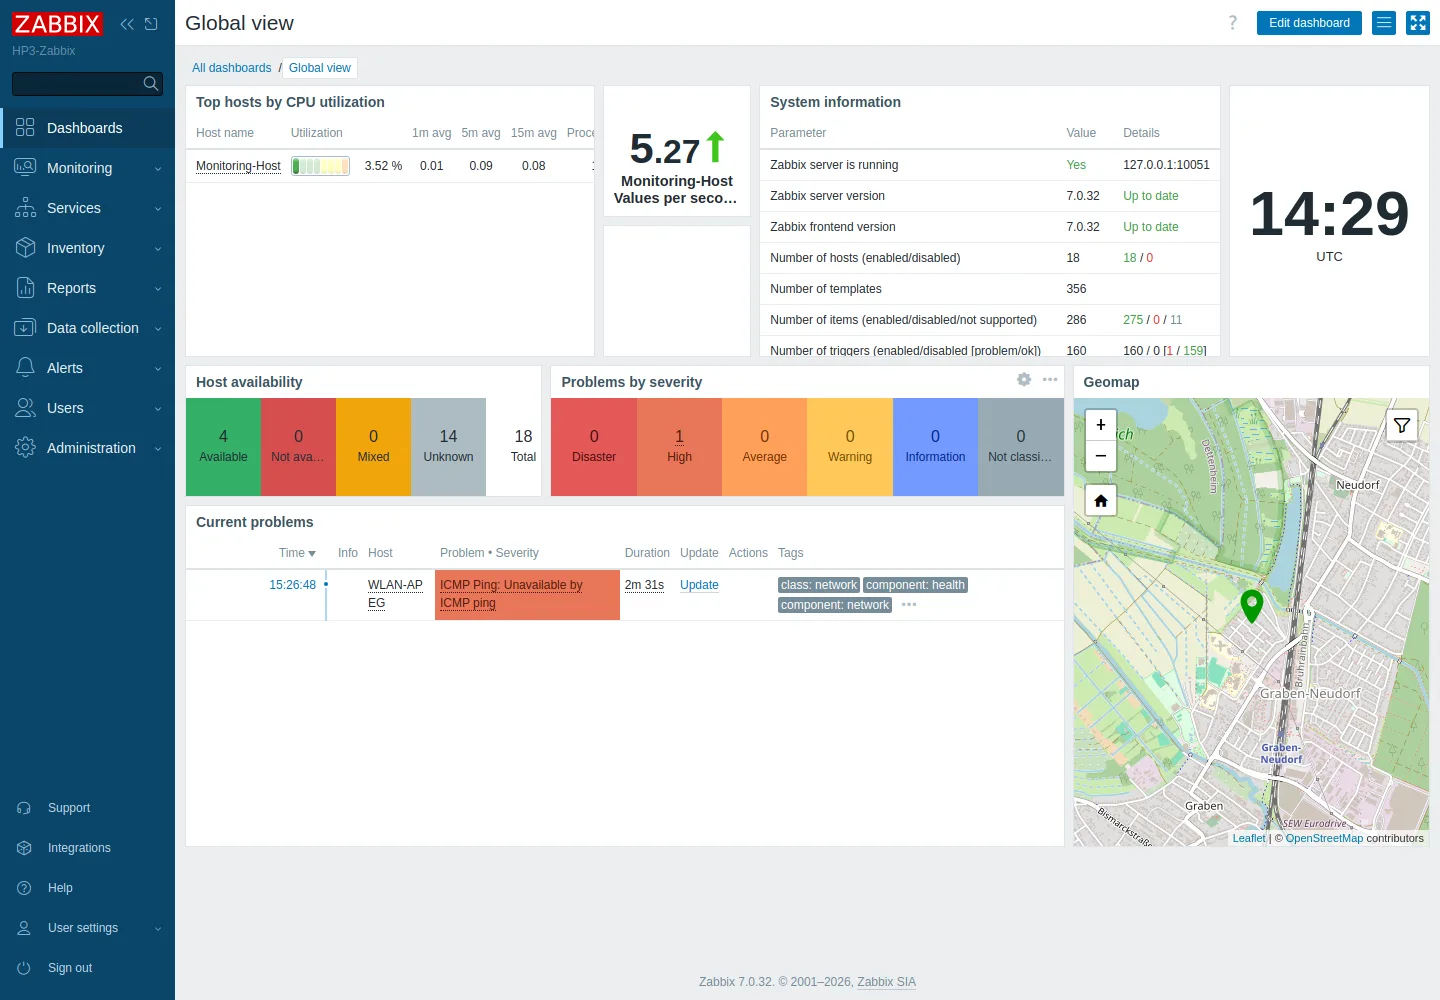
Dashboards → Global view: het overzicht
De startpagina toont de beschikbaarheid van alle hosts, problemen per severity, de actuele problemen en een kaart. De tegel “Host availability” verwart in het begin: apparaten zonder agent verschijnen grijs als “Unknown”. Dat is geen fout – ze hebben gewoon geen agent; hun toestand zit in de ping- en poortchecks. De kaart (Geomap) plaatst apparaten op de locatie die in hun inventaris staat; ik heb de woonplaats ingevuld in plaats van een exact adres.
Monitoring → Problems: wat er nu stuk is
Dit is de belangrijkste pagina. Elk openstaand probleem staat hier met begin, duur en severity. Met Update bevestig je een probleem (“ik ben ermee bezig”) en laat je een opmerking achter. Het filter History toont ook opgeloste problemen – handig om later uit te zoeken wanneer het accesspoint voor het laatst weg was.
Monitoring → Hosts en Latest data: de toestand van elk apparaat
Monitoring → Hosts (afbeelding hierboven bij “Wat er bewaakt wordt”) toont elk apparaat met links naar de laatste waarden, problemen, grafieken en web scenarios. Latest data toont de ruwe waarden: of de laatste ping terugkwam, hoe lang het duurde, of een poort open was. Elke waarde linkt naar een grafiek.
Monitoring → Hosts → Web: de externe servers
Zabbix 7.0 heeft hiervoor geen eigen menu-item: klik in Monitoring → Hosts op de link Web naast een apparaat. Daar staan de web scenarios voor de blog, Nextcloud en Collabora, met tijdstip en resultaat van de laatste run. Klik je op een naam, dan zie je responstijd en downloadsnelheid door de tijd heen. Faalt een scenario, dan vertelt het welke stap met welke fout misging.
Data collection → Hosts: een nieuw apparaat toevoegen
Nieuwe apparaten voeg je toe onder Data collection → Hosts → Create host. Voor een apparaat dat alleen een ping-check nodig heeft, volstaan vijf velden:
- Host name – de technische naam, alleen eenvoudige tekens.
- Visible name – de naam die overal getoond wordt.
- Templates – kies ICMP Ping.
- Host groups – bijvoorbeeld LAN.
- Interfaces – één interface met het IP-adres van het apparaat. Het type maakt voor ping niet uit; Zabbix haalt het adres uit de interface.
Opslaan, klaar – de eerste waarden komen binnen een minuut binnen. Wil je ook een poort controleren, voeg dan onder Items van de host een item van het type Simple check toe met de key net.tcp.service[tcp,,443], en onder Triggers een alert zoals max(/<host>/net.tcp.service[tcp,,443],#3)=0.
Direct ernaast zit Data collection → Maintenance. Daar voer je tijden in waarop apparaten bewust uit staan – bijvoorbeeld een backup-pc die maar af en toe draait. In die periodes worden geen mails verstuurd.
Alerts → Media types en Actions: zorgen dat de mail aankomt
Twee plekken bepalen of er überhaupt een mail verstuurd wordt:
- Alerts → Media types → Email: SMTP-server, poort, versleuteling, afzender en inloggegevens. De link Test stuurt van hieruit een testmail.
- Alerts → Actions → Trigger actions: de bestaande action Report problems to Zabbix administrators moet op Enabled staan. Die bepaalt wie over een probleem en over het herstel wordt geïnformeerd.
Dan de ontvanger: vul je eigen adres in onder Users → Users → Admin → Media.
HP3 zelf: grafieken zoals in Grafana
Voor HP3 heeft Zabbix de grafieken zelf gebouwd uit het Linux-template: CPU, geheugen, load, netwerk per kaart, gebruik van elke ZFS-dataset en schijf-I/O. Je vindt ze onder Monitoring → Hosts → Graphs of op het hostdashboard dat Zabbix automatisch aanmaakt.
De les: Van alle menu-items heb je er in het dagelijks gebruik vier nodig: Problems, Hosts, Latest data en Create host. De rest is configuratie die je één keer doet.
🔄 Wat er nu komt
Sommige checks bestaan nu dubbel: mijn bestaande uptime-check test de blog en Nextcloud nog steeds, en Zabbix doet dat ook. Dat is expres. Beide draaien een paar weken naast elkaar, daarna beslis ik of Zabbix de uptime-check vervangt. Zabbix heeft historie en responstijden aan zijn kant, de uptime-check dat hij piepklein is en er nauwelijks iets mis mee kan gaan.
Even belangrijk vond ik dat alles ook weer te verwijderen is. Omdat het allemaal rootless onder mijn gebruiker draait, betekent verwijderen: vier services stoppen, vier bestanden en één map wissen. Die stappen heb ik tijdens het opzetten opgeschreven.
Tot nu toe vraagt Zabbix de meeste apparaten maar één ding: “Ben je er nog?” In de volgende post moet het in ze kijken:
- FRITZ!Box en repeaters via TR-064. Die spreken geen SNMP, maar deze interface meldt de toestand van de internetlijn, de synchronisatiesnelheid en het aantal wifi-clients. Dat is de echte winst: een accesspoint kan op pings antwoorden en toch gestopt zijn met wifi uitzenden. “Drie uur lang geen enkele client” is het alert dat echt helpt.
- De switch via SNMP. Met de standaard-MIB (IF-MIB) ziet Zabbix de toestand, fouten en het verkeer van elke poort en meldt het wanneer een poort down gaat.
- De serverhardware via iLO. Voor ventilatoren, temperaturen, voedingen en schijven levert Zabbix een kant-en-klaar template dat Redfish (HTTP) bevraagt.
- De zonne-installatie. De Fronius-omvormer heeft een eigen JSON-interface, de Solar API. Zabbix kan die zonder extra software bevragen en er opbrengstgrafieken van tekenen.
- Minder mails bij een storing. Valt vandaag de switch uit, dan stuurt elk apparaat erachter zijn eigen mail. Met afhankelijkheden tussen de alerts weet Zabbix dat alles aan de switch hangt en meldt het alleen de switch.
- Een tweede alertkanaal, zoals een pushbericht naar mijn telefoon (ntfy), voor het geval het mailpad zelf breekt. Plus een kortere bewaartermijn voor de meetwaarden en een nachtelijke databasebackup.
En eerlijk gezegd hoop ik dat de eerste echte mail van Zabbix nog lang op zich laat wachten.
De les: Een nieuwe tool naast de oude laten draaien kost weinig en laat zien of hij in het dagelijks gebruik beter is. De verwijdering meteen opschrijven haalt het risico uit het uitproberen.
🎯 De lessen
- Monitoring ziet alleen waarvoor je het gebouwd hebt. De stille gaten zijn de apparaten zonder agent.
- Een alert is pas bewezen als een bewust veroorzaakte storing in de inbox belandt – herstel inbegrepen.
- Controleer de standaardinstellingen: Zabbix heeft standaard geen actieve mail-action, en de tijdzone is UTC.
- Bij containers zitten problemen vaak op de grens met de kernel: capabilities, device-bestanden, mounts.
- Gebruik voor tests adressen die gegarandeerd van niemand zijn – “antwoordde niet bij de scan” betekent niet “vrij”.
🔧 Aanvulling: minder schrijflast voor de SSD’s
Na publicatie kwam de vraag of constante kleine schrijfacties de RAIDZ van SSD’s schaden. Dus heb ik gemeten wat de database echt schrijft: zo’n 750 transacties per minuut, waarvan ruim 110 via fsync een directe schrijfactie naar schijf afdwongen – bijna twee per seconde. Elke fsync verhindert dat ZFS schrijfacties in het RAM verzamelt en ze in batches wegschrijft, en in een RAIDZ belandt elk klein blok samen met zijn pariteit op de schijven.
Afgezet tegen de levensduur van de SSD’s is dit onschuldig: zo’n 200 tot 300 MB per dag is verwaarloosbaar voor schijven die elk op ongeveer 1.300 TB aan writes zijn berekend. Omdat de server aan een UPS hangt, heb ik PostgreSQL toch op batchen gezet – vier opties in het Quadlet-bestand van de database:
| Instelling | Effect |
|---|---|
synchronous_commit=off | Een commit wacht niet meer op de schijf; het transactielog wordt op de achtergrond geschreven |
wal_writer_delay=2000ms | Het achtergrondproces schrijft maar elke 2 seconden in plaats van elke 200 ms |
checkpoint_timeout=15min | Checkpoints elke 15 in plaats van elke 5 minuten, minder datapagina’s die dubbel geschreven worden |
wal_compression=lz4 | Het transactielog wordt gecomprimeerd |
Het resultaat, per minuut bij vergelijkbare belasting:
| ervoor | erna | |
|---|---|---|
afgedwongen schrijfacties (fsync) | 111 | 30 |
| transactielog | ~80 KB | ~72 KB |
De prijs: valt de stroom ondanks de UPS uit, dan kunnen de meetwaarden van de laatste paar seconden ontbreken. De database blijft consistent – met synchronous_commit=off verliest PostgreSQL alleen de meest recente transacties, oudere beschadigt hij nooit. Voor monitoringdata is dat een goede ruil.
De les: Eerst meten, dan optimaliseren. De eerste instelling alleen leverde bijna niets op; pas de meting liet zien dat het achtergrondproces elke kleine wijziging nog steeds in een ritme van 200 ms afzonderlijk wegschreef.
De screenshots zijn geanonimiseerd: apparaatnamen, IP-adressen, domeinen en mailadressen zijn voor het maken vervangen door neutrale placeholders, en de storing is in scène gezet.