
Acht uur voor een back-up: hoe een SMR-schijf, rdiff-backup en Hugo elkaar afremden
Mijn back-up-pc draaide de laatste tijd meer dan acht uur, terwijl er nauwelijks data was veranderd. Het spoor leidde naar een harde schijf met dakpannen, een tool die elk bestand afzonderlijk op de schijf vastlegt en een blog die bij elke build 70.000 bestanden opnieuw schrijft.
🌐 Ook in: English · Deutsch · Français · Español · Italiano · Português · Polski
In het kort: Mijn back-up-pc had de laatste tijd acht uur en 18 minuten nodig voor één run, voor data die nauwelijks was veranderd. Er was niet één oorzaak, maar drie die elkaar versterkten: een SMR-harde schijf, die instort bij veel kleine schrijfacties; rdiff-backup, dat elk bestand afzonderlijk op de schijf dwingt; en mijn Hugo-blog, die bij elke build al zijn ongeveer 70.000 bestanden opnieuw schrijft. Nu back-up ik de blog als één tar.gz-archief (38 seconden in plaats van tot vier uur), rdiff-backup draait met --no-fsync, en wat opnieuw kan worden gemaakt, blijft buiten.
Inhoud
🐢 Het symptoom: acht uur voor bijna niets
Mijn back-up-pc is een oude computer die ik aanzet wanneer er een back-up moet worden gemaakt: hij haalt alles op en zet zichzelf daarna weer uit. Hij back-upt vier dingen na elkaar: Nextcloud, de blog, de shares op de NAS en mijn homemap op de werkcomputer. Het gereedschap voor alles: rdiff-backup. Het houdt een actuele spiegel bij en legt bij elk gewijzigd bestand een „increment”-bestand met de oude stand neer; zo kom je bij elke eerdere versie.
Lange tijd ging dat snel. Toen zag de statistiek er zo uit:
| Run | Nextcloud | Blog | NAS | Home | Totaal |
|---|---|---|---|---|---|
| 12-11 | 15 min | 0 min | 1 min | 39 min | 56 min |
| 17-11 | 55 min | 169 min | 6 min | 167 min | 6 u 37 min |
| 19-11 | 4 min | 110 min | 186 min | 198 min | 8 u 18 min |
Dezelfde data, dezelfde hardware: soms net onder een uur, soms meer dan acht. Geen van de runs had duidelijk meer ruimte nodig. Het lag dus niet aan de hoeveelheid, maar aan iets anders.
🏠 Inzicht 1: de harde schijf heeft een pannendak
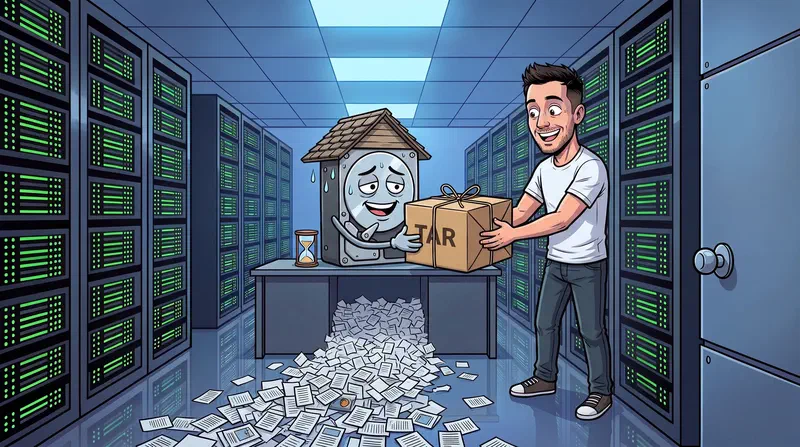
Eerste blik op de hardware: de back-upschijf is een Seagate Barracuda van 8 TB. Dit model werkt met SMR (Shingled Magnetic Recording): de sporen overlappen elkaar als dakpannen. Zo past er meer data op de schijf, maar er zit een addertje onder het gras: wie een spoor wijzigt, overschrijft ook het buurspoor dat er half overheen ligt; de schijf moet dus hele gebieden (banden) lezen en opnieuw schrijven.
Om dat in het dagelijks gebruik niet te merken, heeft de schijf een klein, normaal beschreven buffergebied. Nieuwe data komt eerst daar terecht, en de schijf sorteert die in rustige momenten in de pannenbanden. Grote bestanden in één stuk zijn geen probleem. Veel kleine schrijfacties daarentegen vullen de buffer snel, en dan zakt de schrijfsnelheid van meer dan 100 MB/s naar een fractie daarvan, omdat de schijf tegelijk ontvangt en herschikt.
Op een schijf voor films of foto’s merk je dat nooit. Bij een back-up van honderdduizenden kleine bestanden merk je het heel duidelijk.
💾 Inzicht 2: rdiff-backup legt elk bestand afzonderlijk vast
Tweede blik: hoe rdiff-backup schrijft. Voor elk bestand dat het aanmaakt of vervangt, roept het fsync aan; dat dwingt het besturingssysteem om het bestand meteen fysiek naar de schijf te schrijven in plaats van het in het geheugen te verzamelen. Goed bedoeld: crasht de computer midden in een run, dan staat elk al geback-upt bestand echt op de schijf.
Op een SMR-schijf is dat echter het slechtste geval: elk bestand is één kleine, synchrone schrijfactie. In de runs heb ik ongeveer 10 tot 15 bestanden per seconde gemeten. Bij een paar honderd gewijzigde bestanden maakt dat niet uit. Bij 200.000 is dat vier uur.
🔁 Inzicht 3: Hugo schrijft bij elke build alles opnieuw
En waar komen 200.000 gewijzigde bestanden vandaan als ik maar één bericht wijzig? Van de overstap naar Hugo. Sindsdien is mijn blog een verzameling statische bestanden: ongeveer 150 berichten in 8 talen, plus tagpagina’s, categorieën, paginering, feeds, de zoekindex en afbeeldingen in meerdere formaten, samen ongeveer 70.000 bestanden.
Hugo bouwt bij elke deploy de hele site opnieuw en zet die volledig opnieuw neer, ook de pagina’s die helemaal niet zijn veranderd. Voor rdiff-backup is na elke deploy bijna elk bestand gewijzigd: een nieuwe spiegelkopie plus een increment-bestand met de oude stand. Afhankelijk van het aantal deploys sinds de vorige run waren dat 59.000 tot 214.000 nieuwe bestanden per run. Bij 10 tot 15 bestanden per seconde: 110 tot 234 minuten alleen voor de blog.
Onder WordPress was dat geen probleem: alles stond in een database en de back-up was één dump.
🧩 Hetzelfde patroon op nog twee plekken
Toen het principe duidelijk was, viel het ook elders op:
- NAS (186 minuten op 19-11): de dag ervoor had ik mijn mappen opgeruimd en veel verplaatst. Voor rdiff-backup is een verplaatst bestand een verwijderd plus een nieuw bestand: twee schrijfacties per bestand. Een eenmalig effect; op 20-11 was het weer 54 seconden.
- Homemap (tot 198 minuten): van ongeveer 420.000 bestanden zijn er zo’n 360.000 dingen die op elk moment opnieuw kunnen worden gemaakt: container-images, caches, Python-omgevingen,
node_modules, de gebouwde website, werkbestanden van het cd-rippen. Ze veranderen voortdurend en zijn in noodgevallen waardeloos.
🛠️ Wat ik heb veranderd
1. De blog wordt als één archief geback-upt. In plaats van 70.000 losse bestanden met rdiff-backup te spiegelen, pakt de bronmachine de stand in met tar, comprimeert die met gzip -1 en stuurt hem als één datastroom naar de back-up-pc. Daar komt precies één bestand terecht. Dat is voor elke harde schijf het ideale geval, en voor een SMR-schijf helemaal.
ssh bron "tar -C /storage --numeric-owner -cf - blog | gzip -1" > blog_2026-11-20_0814.tar.gz.part
tar -tzf blog_2026-11-20_0814.tar.gz.part | wc -l   # eerst controleren, dan pas hernoemen
Vooraf controleert het script of de laatste back-up op de bron is gelukt, en achteraf of het archief leesbaar is en de startpagina bevat. Pas dan krijgt het zijn definitieve naam. gzip -1 volstaat: de afbeeldingen zijn al gecomprimeerd, een hoger niveau kost alleen tijd.
Bewaren: alle archieven van de laatste 30 dagen, plus het eerste archief van elke maand gedurende een jaar. Dat is grover dan de versiegeschiedenis van rdiff-backup, maar ruim voldoende voor een blog waarvan de broncode toch al in Git staat. De oude rdiff-geschiedenis blijft voor de periode daarvoor bestaan.
2. rdiff-backup zonder fsync per bestand. Voor Nextcloud, de NAS en de homemap draait rdiff-backup nu met --no-fsync. Helemaal aan het eind van de hele run staat één sync die alles naar de schijf schrijft. Het risico is te overzien: crasht de back-up-pc midden in een run, dan is die ene run onvolledig; maar dat gebeurt ook met fsync, en rdiff-backup ruimt een afgebroken run bij de volgende start zelf op (regress).
3. Wat opnieuw kan worden gemaakt, blijft buiten. De homemap heeft nu een uitsluitingslijst: containeropslag, .cache, .venvs, node_modules, .npm, de gebouwde website en werkmappen. Dat alles is met één commando te herstellen.
📊 Het resultaat
De eerste run met alle wijzigingen op 20-11:
| Stap | vooraf (19-11) | achteraf (20-11) |
|---|---|---|
| Nextcloud (810.000 bestanden) | 4 min 26 s | 2 min 29 s |
| Blog | 110 min | 38 s (één archief, 888 MB, 113.002 items) |
| NAS | 186 min | 54 s |
| Home | 198 min | 101 min 22 s |
| Totaal | 8 u 18 min | 1 u 45 min |
Bij de homemap is de eerste run een bijzonder geval: rdiff-backup registreert de pas uitgesloten bestanden eenmalig als „verwijderd”, dat zijn nog één keer honderdduizenden increment-bestanden. Vanaf de volgende run vallen ze helemaal weg.
💡 Had een SSD dit ook opgelost?
Die vraag heb ik mezelf ook gesteld. Een SSD (of een harde schijf met klassieke CMR) zou bij veel kleine bestanden duidelijk sneller zijn, zeker. Maar die had alleen het symptoom verzacht: 200.000 increment-bestanden per run voor een website die op elk moment opnieuw uit Git kan worden gebouwd, zijn ook op een SSD verspilling. Eerst het aantal bestanden omlaag, dan aan hardware denken. Overstappen op een CMR-schijf of op Borg, dat kleine bestanden in grote blokken verpakt, blijft een optie voor later.
🤝 Hoe de analyse verliep
De foutopsporing heb ik met Claude Code gedaan: ik zei alleen „de back-up duurt acht uur, kijk eens of je iets kunt optimaliseren” en voegde een paar ideeën toe (een ingepakt archief, meer in het RAM bufferen, rdiff-backup vervangen, de schijf controleren). Claude heeft de looptijden uit de logs van de afgelopen weken geanalyseerd, het schijfmodel als SMR herkend, de increment-bestanden per run geteld en het verband met de Hugo-build gelegd. Het schreef de scripts en brak, toen ik zei „we doen het opnieuw”, de lopende back-up af en startte die opnieuw met de nieuwe versie.
🎯 Conclusie: niet de hoeveelheid, maar het aantal
- De back-uptijd hangt af van het aantal bestanden, niet van de gigabytes. 888 MB in één stuk: 38 seconden. Dezelfde data als 200.000 losse bestanden: vier uur.
- SMR-schijven zijn een slechte keuze voor back-ups van veel kleine bestanden. Kijk voor de aankoop in het datasheet: „SMR” staat vaak alleen in de kleine lettertjes.
- Statische websites back-up je als archief, niet bestand voor bestand. De broncode staat toch al in Git.
- Wat opnieuw kan worden gemaakt, hoort niet in de back-up. Caches en container-images kosten tijd en helpen niet in een noodgeval.
- Eerst meten, dan kopen. Een nieuwe schijf had het probleem alleen kleiner gemaakt.
📚 Gerelateerde berichten: