
Od „zrobię to później” do „chwila, to już gotowe?!” — Ożywiam FLUX + ComfyUI na moim starym PC typu tower
🌐 Także w: English · Deutsch · Français · Español · Italiano · Português · Nederlands
Jak zapowiedziałem w poprzednim wpisie, jednym z moich celów było wreszcie zanurzyć się w świat lokalnych narzędzi AI. Wiesz, to, czym fajne dzieciaki na Reddicie ciągle się chwalą: uruchamianie własnych modeli do generowania obrazów, na własnym sprzęcie, bez jakiegoś dostawcy chmury, który po cichu cię dławi, bo o jeden raz za dużo poprosiłeś o „kota w czapce czarodzieja”. Wyciągnąłem więc mój starzejący się PC typu tower z półemerytury, wrzuciłem na niego świeżą instalację Debiana i — uzbrojony w instrukcję krok po kroku, którą ChatGPT tak uprzejmie dla mnie napisał — zacząłem instalować ComfyUI i FLUX.1-schnell. Moja główna motywacja? Generuję mnóstwo obrazków na tego bloga, a ChatGPT/DALL-E & spółka uwielbiają po mniej więcej trzech promptach rzucić mi „osiągnąłeś limit” albo „to narusza naszą politykę treści”. Super. Naprawdę super. Czas hostować własne. 💪
😴 A potem... coś mnie rozproszyło
Klasyczna historia: kilka dni temu zainstalowałem podstawy, trafiłem na jakąś przeszkodę, straciłem motywację i porzuciłem konfigurację w połowie — venv w połowie aktywny, karta przeglądarki otwarta, historia terminala pełna niedokończonych poleceń. Taka cyfrowa archeologia, która tylko czeka, żeby się wydarzyć. Dziś pomyślałem: „po prostu oddajmy ten bałagan Claude’owi i zobaczmy, co się stanie.” Dałem mu więc dostęp SSH do maszyny i w zasadzie powiedziałem „dokończ to, co zacząłem.” To, co nastąpiło, było szczerze jednym z bardziej surrealistycznych popołudni, jakie spędziłem z jakimkolwiek oprogramowaniem.
🕵️ Krok 1: Claude bawi się w detektywa
Zamiast wszystko wyczyścić i zacząć od nowa (moje zwykłe podejście, bądźmy szczerzy), najpierw przeczytał moją historię shella. Jak prawdziwy śledczy. Ustalił, że:
- ComfyUI był już sklonowany i skonfigurowany w venv w
~/ai/ComfyUI - wagi FLUX.1-schnell (pokaźny unet na 23GB plus enkodery tekstu CLIP/T5 i VAE) były już pobrane
- GPU to RTX 3050 z 8GB VRAM — Debian 13, 32GB RAM, 16 rdzeni
Potem uruchomił ComfyUI, potwierdził, że faktycznie wstał (HTTP 200, żadnych eksplodujących stack trace’ów) i odesłał schludne podsumowanie stanu. Bez dramatu, bez „pozwól, że przeinstaluję wszystko od zera” — tylko spokojna ocena. Podejrzany poziom kompetencji. 🤨
⚙️ Krok 2: „Zrób z tego porządną usługę” — tak jest
Poprosiłem, żeby ComfyUI działał jako porządna usługa w tle (bo nie zamierzam trzymać sesji SSH otwartej 24/7 jak jakiś dzikus). Claude napisał unit systemd, włączył go i po mniej więcej dwóch minutach wszystko działało na stałe. Odporne na restart. Automatyczny restart po awarii. Pełen pakiet.
🇩🇪 Krok 3: „A czy rozumie prompty po niemiecku?”
To był moment, w którym trochę opadła mi szczęka. Chciałem wiedzieć, czy mogę po prostu wpisywać prompty po niemiecku (bo to oczywiście mój język ojczysty, a ja jestem leniwy). Claude zbudował więc na poczekaniu mały workflow API text-to-image dla FLUX i nakarmił go tym:
“Ein gemütliches Café in Paris bei Sonnenuntergang, digitale Kunstmalerei, warmes Licht, Menschen sitzen draußen”
...odczekał ~60 sekund, pobrał wynikowy PNG przez SCP i mi go pokazał. Naprawdę urocza scena z paryskiej kawiarenki o zachodzie słońca. Po niemiecku. Za pierwszym razem. Nie spodziewałem się, że to po prostu zadziała. ☕
🧩 Krok 4: „Ten UI ma 4000 przycisków, a ja chcę tylko pole tekstowe”
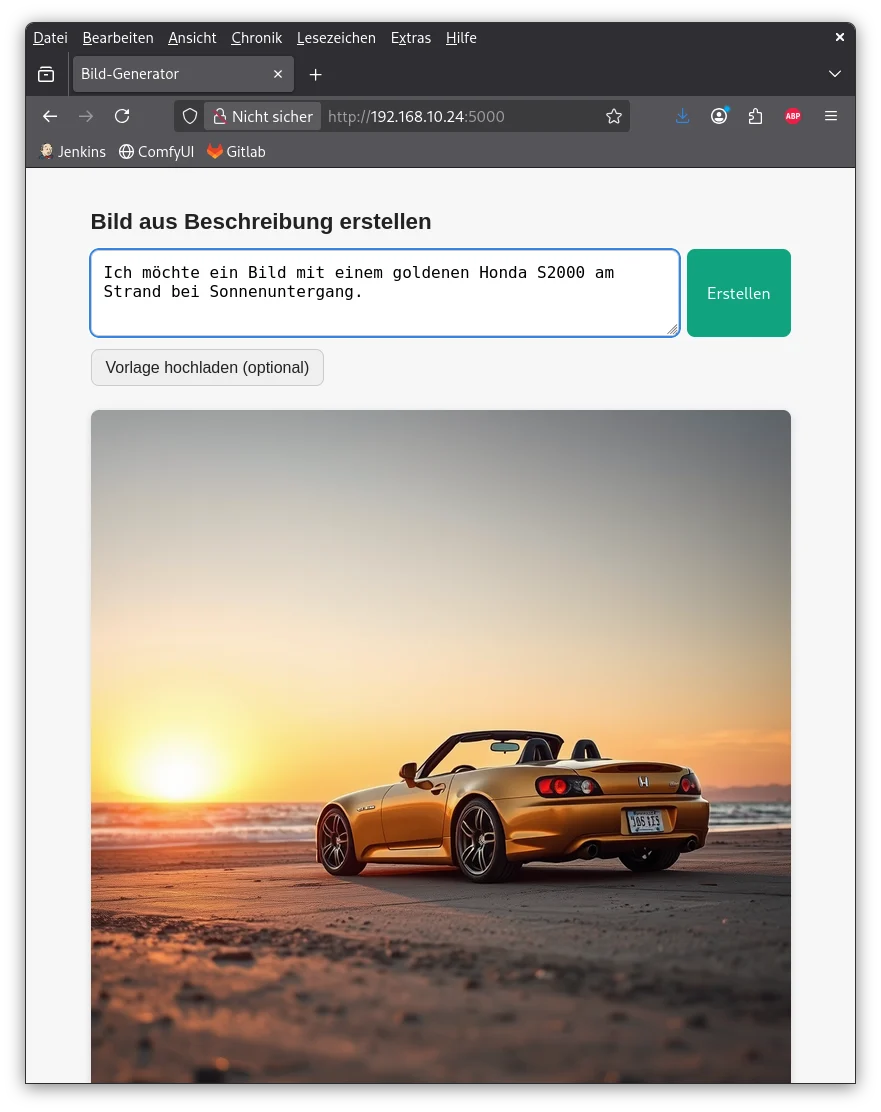
Potem otworzyłem właściwy interfejs webowy ComfyUI i... no tak. Wszędzie grafy węzłów. Suwaki, listy rozwijane, kabelki łączące pudełka jak w patchbayu syntezatora zaprojektowanym przez kogoś, kto naprawdę, naprawdę kocha węzły. W zasadzie powiedziałem: „Chcę po prostu coś jak ChatGPT — jedno pole, wpisuję tekst, dostaję obrazek.” Więc Claude zbudował mi od zera własną mini aplikację webową:
- Aplikacja Flask z dokładnie jednym polem tekstowym i jednym przyciskiem
- Za kulisami buduje pełny JSON workflow FLUX, wysyła go do API ComfyUI, odpytuje aż do zakończenia i serwuje wynikowy obraz
- Też opakowana we własną usługę
systemd, na własnym porcie
Przetestowałem ją na: “Ein freundlicher roter Drache sitzt auf einem Berg, Cartoon-Stil, bunte Farben” → wyszedł naprawdę słodki kreskówkowy smok 🐉 na górze. W około minutę, od początku do końca. Dokładnie zero z tego zbudowałem sam.
🖼️ Krok 5: „Dobra, ale czy mogę wgrać obraz i kazać go zmienić?”
W tym momencie szło mi świetnie, więc kusiłem los: „Czy mogę wgrać istniejący obraz jako szablon i kazać AI go zmodyfikować?” (img2img, dla nerdów na widowni.) Claude:
- Dodał Pillow do osobnego venv do wstępnej obróbki obrazów (skalowanie do wielokrotności 16, bo najwyraźniej VAE są wybredne co do wymiarów)
- Rozszerzył workflow o węzły
LoadImage+VAEEncode - Dodał do UI suwak „siły transformacji” (denoise)
- A potem sam to przetestował: wgrał z powrotem obrazek smoka i poprosił o „smok zieje teraz niebieskim ogniem, jest noc i rozgwieżdżone niebo”
Pierwsza próba z denoise 0.6 → prawie nic się nie zmieniło (w zasadzie ten sam smok, nieco bardziej ponure światło). Claude to zauważył, podbił do 0.9 → zupełnie inna, dramatyczna nocna scena z ogniem 🔥, ale poza smoka zmieniła się całkowicie. Ustalił więc 0.75 jako rozsądną wartość domyślną i wyjaśnił mi ten kompromis. Debugował jakość własnego twórczego wyniku. W moim imieniu. Bez proszenia dwa razy.
📊 Krok 6: moja kolej na głupie pytania
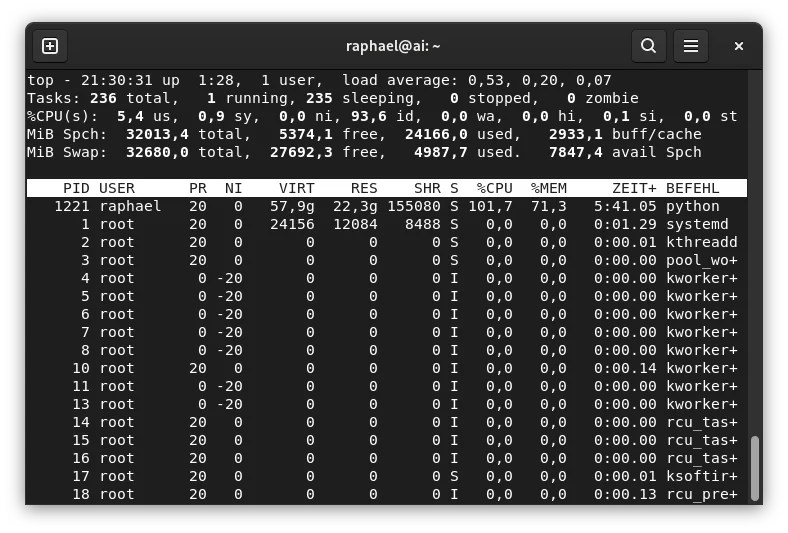
Oczywiście sam musiałem pogrzebać w maszynie i odpaliłem top, gdy trwało generowanie:
MiB Spch:  32013,4 total,    632,3 free,  22986,9 used,   8827,1 buff/cache
MiB Swap:  32680,0 total,  27500,7 free,   5179,2 used.   9026,5 avail Spch

  PID USER  PR  NI   VIRT    RES   SHR S  %CPU  %MEM   ZEIT+  BEFEHL
 1221 me    20   0  56,5g  21,2g 112128 S 55,1  67,7  3:34.24 python
21GB RAM na jeden proces Pythona?! 😱 Zapytałem: „czy to normalne? Czy GPU w ogóle coś robi? Czy moje wentylatory nie powinny teraz wyć?”
Claude spokojnie wyjaśnił: model FLUX ma ~23GB, moje GPU ma tylko 8GB VRAM, więc ComfyUI robi „async weight offloading” — trzyma większość modelu w przypiętej (pinned) pamięci RAM systemu i strumieniuje kawałki do GPU na żądanie. To wyjaśnia za jednym zamachem zużycie RAM i obciążenie CPU.
Potem, żeby porządnie odpowiedzieć na pytanie o GPU, uruchomił kolejne generowanie i równolegle w pętli próbkował nvidia-smi:
Time        GPU-Load   VRAM        Temp    Fan
Start       34%        6.3 GB      42°C    0%
Sampling    100%       6.9 / 8 GB  53→62°C 0%
After       0-6%       3.2 GB      60→47°C 65%
Okazuje się: tak, GPU jest podczas samplingu absolutnie zarżnięte na 100% i prawie zapełnia 8GB VRAM — ale wentylator przyspiesza dopiero po zakończeniu obciążenia, z bezwładnością termiczną, i dlatego nie robi się głośno w trakcie ~60-sekundowego generowania. Zagadka rozwiązana, z dowodami. ✅
🤔 No i... gdzie mnie to zostawia
Szczerze? Siedzę tu w równych częściach zszokowany i zafascynowany. To, co zaczęło się od „proszę, dokończ instalację tego czegoś, co porzuciłem”, zamieniło się w sesję inżynierską na żywo, krok po kroku — nowe wymagania pojawiające się w środku rozmowy, od razu podejmowane, testowane, dostrajane i tłumaczone mi prostym językiem. Bez pięciokrotnego tłumaczenia kontekstu. Bez „nie mogę tego zrobić”. Po prostu... postęp, w czasie rzeczywistym, na moim własnym sprzęcie.
Powiem wprost: ludzie, którzy zbywają AI jako „tylko wymyślny autocomplete”, „niebezpieczne bzdury” albo „generator bredni, który brzmi pewnie, mając zarazem nie rację” — myślę, że po prostu nie patrzysz na to, jak dziś naprawdę się tego używa i jak się to orkiestruje. Sam kiedyś byłem dużo bardziej w tym obozie. Zmieniłem zdanie. Patrzenie, jak bada w połowie skończoną konfigurację, podejmuje rozsądne decyzje infrastrukturalne, pisze naprawdę działający kod, wdraża go, testuje na prawdziwych modelach, a potem debuguje jakość własnego wyniku — to nie jest „fantazja”. To wydarzyło się dziś wieczorem w mojej sieci LAN.
I tak, właśnie to też trochę mnie martwi. Jeśli konwersacyjna AI potrafi kompetentnie stawiać usługi, pisać małe aplikacje, konfigurować systemd, debugować zachowanie pamięci GPU i wyjaśniać to wszystko tak, że człowiek od razu rozumie — co to oznacza dla pracy w IT i pracy sysadmina przez najbliższe 20 lat? Nie panikuję, ale też nie udaję już, że to pytanie jest głupie. 🤷
Tak czy inaczej. Mam teraz prywatny, lokalny, nieograniczony generator obrazów działający na PC, który kiedyś zbierał kurz pod moim biurkiem. Spodziewaj się od teraz dużo więcej (i dziwniejszych) obrazków wygenerowanych przez AI na tym blogu.
W następnym wpisie chcę pójść dalej: rozszerzyć tę konfigurację o tłumaczenie promptów, generowanie kodu i więcej — dziś chodziło wyłącznie o tworzenie obrazów, ale to wyraźnie dopiero początek.
📚 Więcej w tej serii: własna AI