
Homelab Rebuild 2026 — Budowa klastra Proxmox i provisioning przez Terraform
🌐 Także w: English · Deutsch · Français · Español · Italiano · Português · Nederlands
W poprzednim wpisie przedstawiłem plan przebudowy mojego homelabu w małe datacenter w stylu enterprise: pięć filarów, osiem kamieni milowych, jeden wpis na każdy z nich. Kamień milowy 1 to fundament, na którym stoi cała reszta — trzy fizyczne maszyny zamienione w jeden klaster Proxmox VE oraz moduł Terraform, który od teraz provisionuje na nim każdą maszynę wirtualną. Ten wpis omawia jedno i drugie. Uczciwe ostrzeżenie: cały ten projekt to wciąż mocno work in progress. Nic tu nie jest „skończone” ani ostateczne — to w najlepszym razie beta i ciągle się zmienia w trakcie. Traktuj ten wpis jako migawkę stanu z chwili pisania, a nie gotową konstrukcję.
Spis treści
🎯 Cel tego kamienia milowego
Zanim mogłem dotknąć Active Directory, GitLaba czy Kubernetesa, dwie rzeczy musiały być spełnione:
- Trzy osobne maszyny HP musiały stać się jednym klastrem Proxmox VE, żeby maszynami wirtualnymi dało się zarządzać, migrować je i robić ich backup z jednego miejsca.
- Żadna VM nie miała już nigdy powstawać przez wyklikanie. Każda VM — od kontrolera domeny po control plane Kubernetesa — jest tworzona przez
terraform apply, a nie przez kreator w UI Proxmoxa.
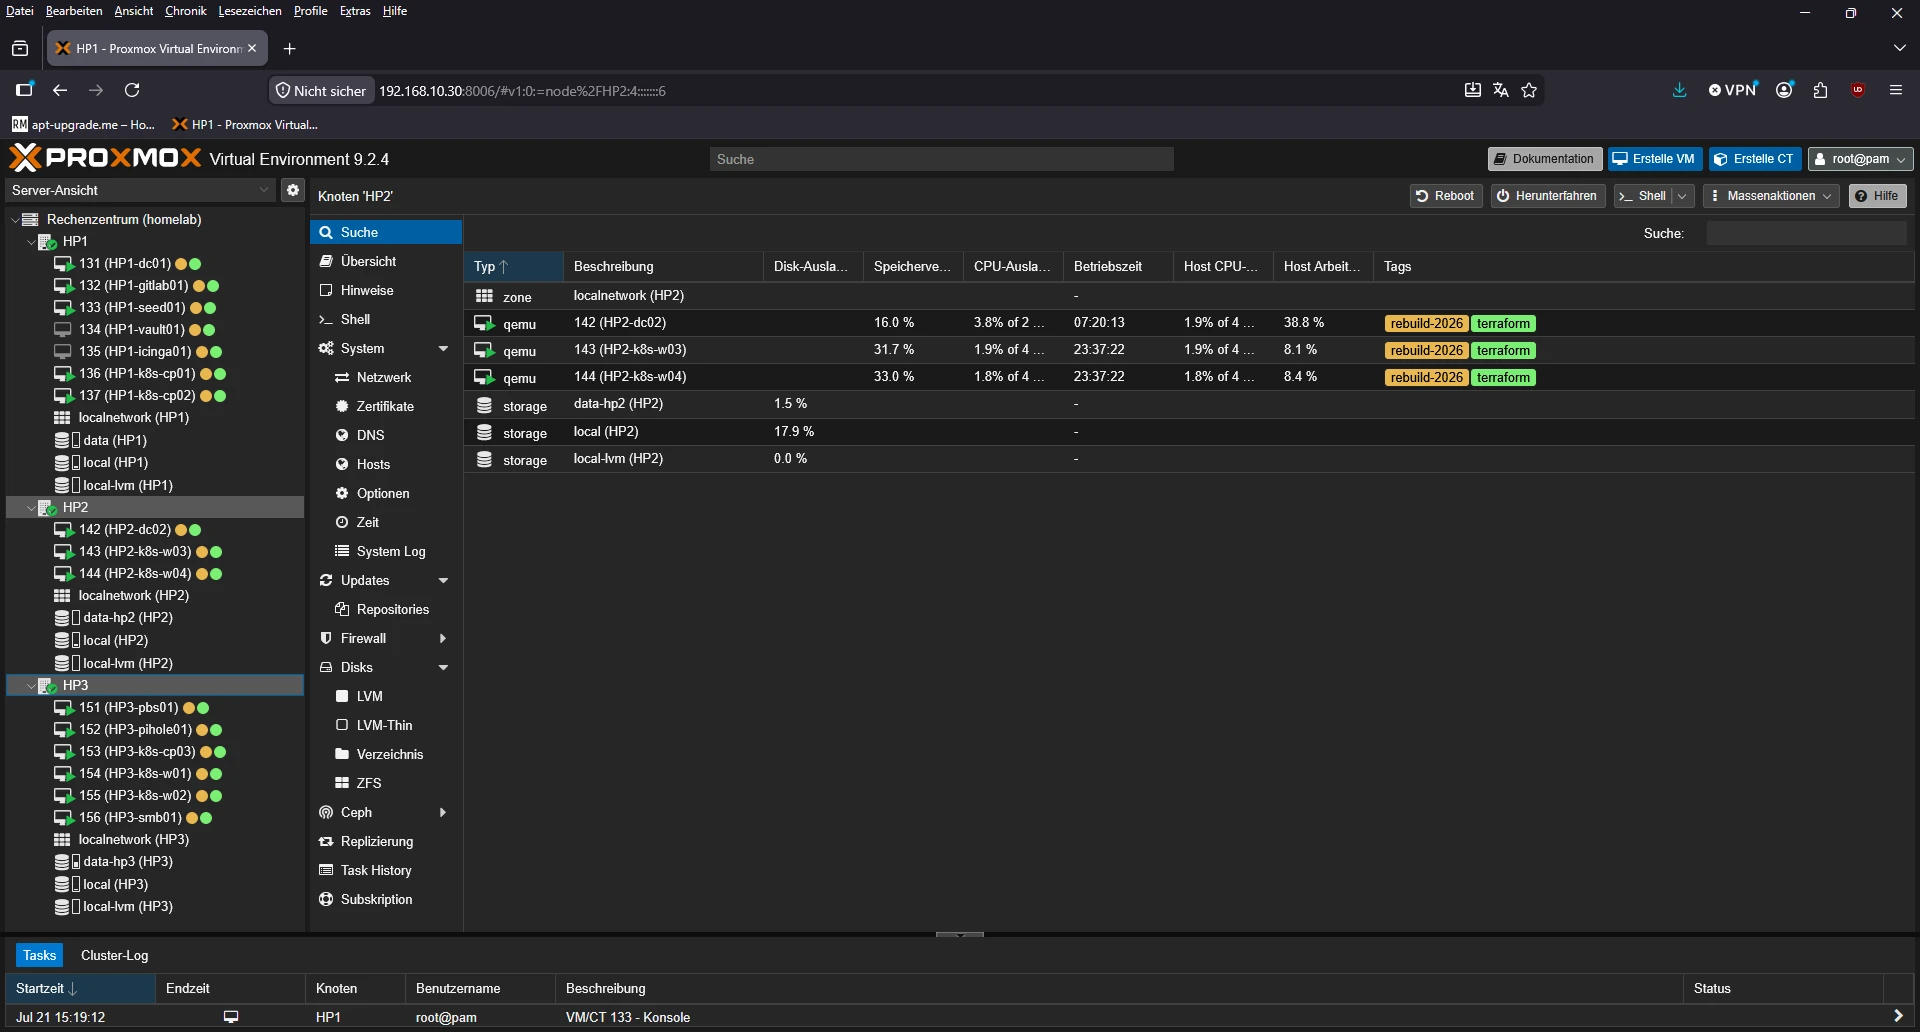
Wszystko poniżej odzwierciedla klaster w takim stanie, w jakim faktycznie działa dziś — wartości pobrałem na żywo prosto z API Proxmoxa, zamiast polegać na notatkach z dnia instalacji.
🖥️ Sprzęt
Trzy maszyny HP, celowo nieidentyczne — to sprzęt z odzysku, a nie dobrany komplet:
| Host | RAM | Dyski | IP zarządzające |
|---|---|---|---|
| HP1 | 64 GB | SSD systemowy 512 GB + SSD 2 TB | 192.168.10.x |
| HP2 | 32 GB | SSD systemowy 512 GB + SSD 2 TB | 192.168.10.x |
| HP3 | 32 GB | SSD systemowy 512 GB + 3×2 TB (ZFS RAIDZ1) | 192.168.10.x |
💽 Instalacja Proxmox VE
Sama instalacja bez fajerwerków: ISO Proxmox VE 9.2 nagrane Rufusem na pendrive, jeden pendrive na maszynę, boot, instalacja, i tak trzy razy. Bez zdalnych nośników wirtualnych, bez PXE — przy trzech maszynach na jednym biurku pendrive to wciąż najszybsza droga od zera do działającego hypervisora.
Każdy węzeł dostał podczas instalacji statyczny adres IP w sieci zarządzającej 192.168.10.x/24 (.30, .40, .50 dla HP1–HP3), która jest jednocześnie siecią, w której żyje klaster i każda VM — więcej o tym kompromisie niżej.
Jeden krok po instalacji na wszystkich trzech: podmiana repozytoriów pakietów. Proxmox domyślnie wskazuje na repozytorium Enterprise, które do faktycznego pobierania aktualizacji wymaga płatnej subskrypcji. Zgodnie z udokumentowanymi krokami samego Proxmoxa wyłączyłem repo Enterprise i skierowałem każdy węzeł na No-Subscription Repository — w porządku do testów/użytku nieprodukcyjnego, czyli dokładnie tego, czym jest homelab, tylko bez tej samej walidacji, którą przechodzi repo Enterprise:
# /etc/apt/sources.list.d/proxmox.sources
Types: deb
URIs: http://download.proxmox.com/debian/pve
Suites: trixie
Components: pve-no-subscription
Signed-By: /usr/share/keyrings/proxmox-archive-keyring.gpg
Gdy to było gotowe, zwykła runda na wszystkich trzech węzłach, zanim zrobiłem cokolwiek innego:
apt-get update
apt-get upgrade
apt-get dist-upgrade
🌐 Sieć
Każdy węzeł ma jedną kartę sieciową zmostkowaną jako vmbr0 (Linux bridge, STP wyłączony) i to do niej później podpina się network_device każdej VM. Na płytach jest drugi wbudowany port sieciowy, ale na razie leży nieużywany — kandydat na dedykowaną sieć dla storage’u lub corosync w przyszłości, ale nie coś, czego trzywęzłowy klaster w homelabie potrzebuje od pierwszego dnia.
To zresztą jedyne świadome uproszczenie warte wspomnienia: corosync (protokół heartbeat/kworum klastra) działa w tej samej sieci co ruch zarządzający i ruch VM, z jednym ringiem:
ring0_addr: HP1 = 192.168.10.x
ring0_addr: HP2 = 192.168.10.x
ring0_addr: HP3 = 192.168.10.x
W klastrze produkcyjnym odizolowałbyś corosync we własnym VLAN-ie albo na osobnych kartach, żeby przeciążona sieć zarządzająca nie mogła spowodować fałszywej utraty kworum. Dla trzech węzłów w domowej sieci, gdzie nic innego nie konkuruje o przepustowość, to ryzyko jest akceptowalne — jest na liście rzeczy do przemyślenia, gdyby to kiedyś urosło ponad homelab. Jeśli kiedyś trafisz na fałszywą utratę kworum, RackNotes ma solidne omówienie matematyki głosów, trybów awarii Corosync, QDevice i ścieżek odzyskiwania: Proxmox cluster quorum loss.
🔗 Tworzenie klastra
Standardowy przebieg pvecm: utworzyć klaster na HP1, a potem dołączyć do niego HP2 i HP3. Z trzema członkami z prawem głosu klaster toleruje wyłączenie dokładnie jednego węzła (2 z 3 głosów), zanim straci kworum — minimalny sensowny układ HA i właśnie powód, dla którego wybrałem trzy węzły zamiast dwóch. Zapytanie do klastra dziś potwierdza, że happy path się utrzymał:
$ pvecm status
Cluster name:   homelab
Quorate:        Yes
Nodes:          3

Nodeid  Ip              Name
1       192.168.10.x   HP1 (local)
2       192.168.10.x   HP2
3       192.168.10.x   HP3
🗄️ Układ storage’u
Tu trzy węzły przestają być identyczne. Drugi dysk każdego węzła (albo dyski, w przypadku HP3) jest celowo skonfigurowany inaczej:
- HP1 & HP2: dodatkowy SSD 2 TB dodany jest jako zwykły directory storage (
data/data-hp2) — bez ZFS, bez RAID, po prostu system plików na dyski VM, obrazy ISO i backupy. Jeden SSD, nie ma czego mirrorować, więc wygrywa najprostsza opcja. - HP3: trzy dyski 2 TB trafiają do puli ZFS w trybie RAIDZ1 (
data-hp3), co daje niecałe 4 TB użytecznej przestrzeni z tolerancją awarii jednego dysku. To węzeł przeznaczony na wszystko, czego nie chcę stracić przez jeden padnięty dysk — pomyśl o replikach Longhorna albo danych MinIO, gdy pojawi się Kubernetes.
Każdy węzeł zachowuje też domyślne storage’e z instalatora: local (główny system plików) i local-lvm (LVM-thin na dysku systemowym), używane przez sam system i jako rezerwa.
🧱 Od ClickOps do Infrastructure as Code
Gdy klaster już stoi, kusi, żeby siedem razy kliknąć „Create VM” w UI Proxmoxa. Dokładnie tak zrobiłem w poprzedniej wersji tego homelabu i każda VM wyszła trochę inna — tu zapomniane ustawienie cloud-init, tam ręcznie wpisany statyczny adres IP, a pół roku później żadnego śladu tego, co właściwie zrobiłem. Nie tym razem: każda VM w tej przebudowie jest zdefiniowana raz, w Terraformie, i da się ją odtworzyć na czystym klastrze.
⚙️ Moduł Terraform
Moduł leży w 01_terraform/ w repozytorium projektu i korzysta z providera bpg/proxmox. Zamiast montować ISO Ubuntu Server i przeklikiwać się przez instalator, każda VM jest klonowana z cloud image Ubuntu 26.04 i konfigurowana w całości przez cloud-init — statyczne IP, DNS, klucz SSH, wszystko — więc nigdzie w pipeline nie ma interaktywnego kroku instalacji:
resource "proxmox_download_file" "ubuntu_cloud_image" {
  content_type = "iso"
  datastore_id = var.image_datastore_id
  node_name    = var.proxmox_node
  url          = var.ubuntu_cloud_image_url
  file_name    = "noble-server-cloudimg-amd64.img"
  overwrite    = false
}

resource "proxmox_virtual_environment_vm" "vm" {
  for_each = local.vms

  name        = each.key
  tags        = ["terraform", "rebuild-2026"]
  node_name   = var.proxmox_node
  vm_id       = each.value.vmid

  disk {
    datastore_id = var.vm_datastore_id
    file_id      = proxmox_download_file.ubuntu_cloud_image.id
    interface    = "scsi0"
    size         = each.value.disk_gb
  }

  initialization {
    ip_config {
      ipv4 {
        address = "${each.value.ip}/${var.network_prefix}"
        gateway = var.network_gateway
      }
    }
    user_account {
      username = var.vm_username
      keys     = var.ssh_public_keys
    }
  }
}
Wszystkie siedem VM — po jednej na rolę w tym kamieniu milowym — zadeklarowane są w jednej mapie locals.vms, więc dodanie później ósmej VM to diff na pięć linii, a nie skopiowany blok resource:
| Nazwa | Rola | IP | RAM | Dysk |
|---|---|---|---|---|
| HP1-dc01 | AD / DNS / Root CA | 192.168.10.x | 4 GB | 60 GB |
| HP1-gitlab01 | GitLab / Container Registry | 192.168.10.x | 8 GB | 120 GB |
| HP1-seed01 | VM deweloperska (Ansible, kubectl, narzędzia) | 192.168.10.x | 4 GB | 60 GB |
| HP1-vault01 | Zarządzanie sekretami (faza 2) | 192.168.10.x | 2 GB | 40 GB |
| HP1-icinga01 | Monitoring | 192.168.10.x | 4 GB | 60 GB |
| HP1-k8s-cp01 | Control plane RKE2 | 192.168.10.x | 8 GB | 80 GB |
| HP1-k8s-cp02 | Control plane RKE2 | 192.168.10.x | 8 GB | 80 GB |
ID maszyn wirtualnych liczone są jako 100 + <ostatni oktet IP> (131–137) — Proxmox wymaga ID ≥ 100, a w ten sposób ID i adres łatwo skojarzyć na pierwszy rzut oka, bez osobnej tabeli.
▶️ Wdrożenie
Gdy token API Proxmoxa i klucz SSH są na miejscu, całe wdrożenie to trzy polecenia:
cp terraform.tfvars.example terraform.tfvars
# edit terraform.tfvars: API URL, API token, node name, SSH key

terraform init
terraform plan
terraform apply
Kilka minut później wszystkie siedem VM istnieje, startuje i odpowiada na przydzielonych adresach IP — a Terraform mówi dokładnie, która jest która:
Outputs:

vm_ids = {
  "HP1-dc01"     = 131
  "HP1-gitlab01" = 132
  "HP1-icinga01" = 135
  "HP1-k8s-cp01" = 136
  "HP1-k8s-cp02" = 137
  "HP1-seed01"   = 133
  "HP1-vault01"  = 134
}
vm_ips = {
  "HP1-dc01"     = "192.168.10.x"
  "HP1-gitlab01" = "192.168.10.x"
  ...
}
🧩 Kilka rzeczy wartych odnotowania
- Cloud image, nie ISO. ISO Ubuntu leżące na lokalnym storage’u HP1 jest przez ten moduł celowo nieużywane — sklonowanie cloud image i skonfigurowanie go przez cloud-init jest szybsze i w pełni bezobsługowe. ISO zostaje tylko na rzadką ręczną instalację.
ignore_changesnafile_iddysku. Bez tego Terraform przy każdym plan chce ponownie importować obraz bazowy, bo ID pobranego pliku nie jest przeznaczone do uzgadniania po początkowym klonowaniu.- Sekrety nigdy nie opuszczają wewnętrznego repo.
terraform.tfvarszawiera prawdziwy token API i klucz SSH i jest w gitignore; dodatkowo hook pre-push aktywnie blokuje jego trafienie do publicznego mirrora tego projektu na GitHubie. - State jest lokalny i to jest w porządku. Jeden operator, jeden laptop odpalający
apply— zdalny backend rozwiązywałby problem, którego jeszcze nie mam.
Dokładniejsze techniczne omówienie modułu — architektura, każda zmienna, pełny spis VM i bieżąca lista wyciągniętych wniosków — znajdziesz w 01_terraform/docs/ w repozytorium (po angielsku, niemiecku i francusku).
⚠️ Cały ten projekt — łącznie z pokazanym poniżej kodem Terraform — to permanentny work in progress. Działa, robi to, co obiecuje, ale wciąż jest betą i jest ciągle przerabiany. Nie traktuj niczego tutaj jako gotowego czy stabilnego.
📊 Martwe pole ballooningu w Windowsie
HP1-dc01 jest provisionowana przez ten moduł jak każda inna VM, ale długo nie zostaje Ubuntu — zaraz potem przerabiam ją na Windows Server, bo tego potrzebuje Active Directory. W chwili, gdy to się stało, wykres RAM w podsumowaniu Proxmoxa zastygł na 100% przydzielonych 4 GB, bez względu na to, jak bardzo VM się nudziła.
Przyczyna: Proxmox nie mierzy zużycia pamięci gościa bezpośrednio. Odczytuje je z wirtualnego urządzenia balloon w QEMU, które raportuje prawdziwe liczby tylko wtedy, gdy wewnątrz gościa działa sterownik, który je dostarcza. Na linuksowych VM w tym klastrze przychodzi to razem z qemu-guest-agent — omówionym już przy poprawce guest agenta powyżej. Windows Server nie ma wbudowanego odpowiednika, więc bez dodatkowego oprogramowania urządzenie balloon nie ma czego raportować, a Proxmox po prostu pokazuje VM przyklejoną do pełnego przydziału.
Rozwiązaniem był drugi wirtualny CD-ROM: zamontowanie ISO ze sterownikami virtio-win i zainstalowanie z niego VirtIO Balloon Driver przez Menedżer urządzeń. To ten sam pakiet sterowników, który zawiera też windowsowy odpowiednik guest agenta — po instalacji wykres w podsumowaniu zaczął śledzić faktyczne obciążenie pamięci zamiast płaskiej linii pod sufitem. Więcej o przerabianiu tej VM w prawdziwy kontroler domeny w następnym wpisie.
🔜 Co dalej
Mając trzywęzłowy klaster z kworum i powtarzalny sposób stawiania VM, kamień milowy 2 zaczyna przerabiać HP1-dc01 w prawdziwy kontroler domeny: Active Directory, DNS i offline’owe Root CA, któremu wszystko inne w tym homelabie w końcu będzie ufać. To temat następnego wpisu.
📚 Więcej w tej serii: Homelab Rebuild 2026
- Homelab Rebuild 2026 — Od homelabu do mini datacenter
- Homelab Rebuild 2026 — Active Directory, pranie Pi-hole’a i litera dysku, która nie chce istnieć
- Homelab Rebuild 2026 — GitLab, seed VM i cisza przed burzą Kubernetesa
- Homelab Rebuild 2026: poczekamy, zobaczymy - Awaria serwera, ślepy zaułek w advisory i mój nowy główny podejrzany