
Z bare metal na K3s: dziennik bojowy migracji Nextclouda
🌐 Także w: English · Deutsch · Français · Español · Italiano · Português · Nederlands
Dziś przeniosłem produkcyjnego Nextclouda z przytulnej natywnej instalacji na bare metal na błyszczący stack K3s/kontenery. Na papierze: pobrać backup, odtworzyć, przełączyć DNS, gotowe. W praktyce: seria małych min lądowych, każda niewidoczna, dopóki na nią nie nadepniesz. Oto dziennik bojowy. 🪖
Spis treści
Krok 1: przerzucić dane 🚚
Najcięższą robotą był rsync ~360 GB danych użytkowników plus dump SQL o wielkości ~330 MB z maszyny backupowej na nowy węzeł. Ponieważ wcześniej tego dnia zrobiłem wstępną synchronizację, ostatni przebieg przesłał już tylko różnicę — całość sprowadziła się do szybkiej kopii przyrostowej. Lekcja stara jak świat: najpierw zasiej, a synchronizacja przy cutoverze będzie malutka.
Krok 2: tor przeszkód wersji major 🎮
Backup to był Nextcloud 32.x. Docelowy stack działa na 34.x. Nextcloud ma jedną twardą zasadę: nie możesz przeskoczyć wersji major. Więc to spacer, krok po kroku:
32.0.14 → 33.0.9 → 34.0.4 (occ upgrade at every step)
Kontenerowy haczyk: kod mieszka w trwałym wolumenie, a Nextcloud odmawia uruchomienia starszego kodu na nowszej wersji danych (“downgrade not supported”). Odtworzenie bazy v32 w podzie, który miał jeszcze kod v34 = natychmiastowa odmowa. Rozwiązanie jest rozkosznie partyzanckie: przypiąć obraz do pasującej wersji, szturchnąć version.php w wolumenie z kodem, żeby entrypoint położył właściwy kod od nowa, i pozwolić każdemu occ upgrade dobiec do końca (readiness probe blokuje, dopóki migracja bazy się nie skończy — potrzebna cierpliwość).
Niewidzialne miny 💣
1. Zabójczy socket antywirusa
Po odtworzeniu aplikacja Pliki rzuciła zaraz po zalogowaniu gołym “Internal Server Error” — a log pozostał pusty, bo awaria nastąpiła poniżej własnego loggera Nextclouda. Przyczyna: odtworzona konfiguracja ponownie włączyła files_antivirus w trybie socket, wskazując na socket demona ClamAV, który istnieje na starej natywnej maszynie, ale nie w kontenerze. Rozwiązanie: wyłączyć aplikację (ten stack robi nocne skany wsadowe). Zdiagnozowane wyłącznie przez to, że coś mi nie pasowało, a nie dzięki jakiejkolwiek linii w logu. Podstępne.
2. Więzienie Let’s Encrypt 🔒
DNS nie wskazywał jeszcze na nową maszynę, więc cert-manager przez całe dni bezskutecznie próbował wystawić certyfikaty. Kiedy w końcu przełączyłem DNS, certyfikaty nadal się nie pojawiały. Dlaczego? Po odpowiedniej liczbie porażek cert-manager parkuje Certificate w wykładniczym back-offie zapisanym w statusie obiektu — następna próba zaplanowana za ~24 godziny. Restart kontrolera? Zignorowany. Usunięcie secretu? Zignorowane. Co naprawdę działa: usunąć obiekt Certificate i pozwolić ingress-shim utworzyć go od nowa, bez historii porażek → natychmiastowe wystawienie.
Pułapka bonusowa: sprawdzenie HTTP-01 w Let’s Encrypt preferuje IPv6. Jeśli przeniesiesz tylko rekord A, a zapomnisz o AAAA, walidacja dalej trafia na stary host i kończy się porażką, podczas gdy wszystko “wygląda” na przełączone. Przenieś oba. Zawsze oba.
Danie główne: checkbox, który kłamał ☑️
Ten kosztował najwięcej drapania się po głowie. Collabora (Nextcloud Office) odmawiała otwierania dokumentów: “Nextcloud Office could not be loaded.” Tymczasem test łączności Office w panelu admina był uspokajająco zielony: “Collabora Online server is reachable.” Po stronie serwera wszystko się zgadzało — discovery 200, capabilities 200, ważne certyfikaty, poprawny URL WOPI, nagłówki WebSocket obecne, identycznie jak na hoście referencyjnym, o którym wiadomo, że działa.
Różnica okazała się jednym ustawieniem przeniesionym ze starego serwera: “Disable certificate verification (insecure)” było zaznaczone (disable_certificate_verification=yes w richdocuments). Na starej maszynie miało to sens — certyfikaty self-signed. Ale teraz, z ważnymi certyfikatami Let’s Encrypt, ten “niebezpieczny” tryb psuje sesję dokumentu WOPI w richdocuments 11.x — zostawiając test łączności w panelu admina idealnie zielonym, bo ten test używa innej ścieżki kodu niż prawdziwy handshake dokumentu.
Dlaczego uważam, że to był winowajca? Bo rozwiązanie było dokładnie takie: odznaczyć pole (usunąć klucz), spróbować ponownie, i dokumenty otworzyły się natychmiast. Moja teoria: ścieżka niebezpieczna/bez weryfikacji i wymiana tokenów WOPI rozjeżdżają się, gdy w grę wchodzi prawdziwe TLS, a błąd wychodzi dopiero w sesji edytora — klasyczna sytuacja “health check jest zielony, ale funkcja nie żyje”, która utrzymuje sysadminów w pokorze. Dwa kolejne klucze pozostałe z produkcji (public_wopi_url, doc_format) wyleciały razem z nim, zgodnie z minimalną konfiguracją hosta referencyjnego.
Fałszywy trop: “czemu tyle aplikacji jest wyłączonych?” 🎣
Po upgradzie cała sterta aplikacji pokazywała się jako wyłączone (dashboard, comments, external storage, …) i przygotowałem się na maraton uzgadniania. Potem porównałem obecny zestaw aplikacji ze stanem starego serwera (wyciągniętym z dumpa bazy sprzed upgradu). Zwrot akcji: na starej maszynie też były wyłączone. Nowa instancja już odpowiadała produkcji. Jedyną prawdziwą ofiarą było metadata, które po prostu nie ma wersji zgodnej z Nextcloudem 34. Czasem straszny diff to po prostu… prawda.
Natywnie vs. kontenery: uczciwa część ⚖️
Nowa instancja wydaje się odrobinę wolniejsza niż stara natywna. RAM i CPU się nudzą (zapasu mnóstwo), a czasy odpowiedzi po stronie serwera to 50–210 ms — całkowicie zdrowo. Różnica jest architektoniczna: kontenery dokładają przeskoki (ingress proxy, sieć overlay, PHP-FPM↔nginx przez sieć podów, baza po drugiej stronie granicy pod/host). Na żądanie to milisekundy; w sumie wielu żądań, które odpala strona Nextclouda, wychodzi z tego “trochę mniej żwawo”. To podatek, który płacisz za powtarzalność, izolację i bezbolesne upgrady — a dla małej organizacji to wymiana, która się opłaca.
Wielkie sprzątanie bazy danych 🗃️
Odtworzenie bazy ze starego serwera ciągnie za sobą całą jego historię. Indeks file cache niósł ścieżki plików starego serwera pod nieaktualnymi ID storage’ów — plus dawno usunięty pakiet OnlyOffice, którego 276 tys. wierszy indeksu przeżyło samą aplikację. Wynik netto: tabela oc_filecache z 1 053 373 wierszami, z czego ~93% to martwy balast, i baza o wielkości 1 GB.
Sprzątanie, przeprowadzone ostrożnie, z backupem i wartościami kontrolnymi (prawdziwe pliki użytkowników i liczba użytkowników nie mogą się zmienić): usunąć 7 osieroconych tabel OnlyOffice, skasować dwa nieaktualne storage’e (starą natywną ścieżkę i wcześniejsze mapowanie kontenera) po sprawdzeniu, że zawierały zero prawdziwych plików — tylko odtwarzalne app-data — a potem OPTIMIZE, żeby oddać zwolnione strony systemowi plików. Wynik:
oc_filecache rows:  1,053,373  →  72,580
database size:          1 GB   →  282 MB   (-72%)
real user files:       56,183  →  56,183   (unchanged ✔)
users:                    151  →  151      (unchanged ✔)
A na dysku: 27 GB osieroconych miniatur podglądów, których indeks właśnie został usunięty. Podglądy to czysty, odtwarzalny cache — usunięcie osieroconego drzewa odzyskuje miejsce, a Nextcloud odbudowuje miniatury na żądanie. (Lekcja z wcześniejszej próby generalnej: nigdy nie reindeksuj osieroconych podglądów — to tylko wrzuca ~500 tys. martwych wierszy z powrotem do tabeli, którą właśnie wyczyściłeś. Zamiast tego je usuń.)
Bonusowy gremlin: puste wykresy sieci 📉
node_exporter radośnie raportował CPU, RAM i dysk do Grafany — ale każdy panel Network Traffic uparcie pozostawał pusty. Metryki node_network_receive_bytes_total po prostu nie było. Wskazówka kryła się w node_scrape_collector_success{collector="netdev"} 0 i w linii logu:
netdev: "couldn't get netstats: socket: address family not supported by protocol"
Nowoczesny node_exporter czyta statystyki kart sieciowych przez socket netlink — a hardening systemd tej usługi miał RestrictAddressFamilies=AF_INET AF_INET6, co po cichu zabrania AF_NETLINK. Kolektor zawodzi bezgłośnie, metryka nigdy się nie pojawia, wykres zostaje pusty. Dodaj AF_NETLINK do allow-listy, reload, restart — i krzywe ruchu ożywają. (Bonusowe déjà vu: dokładnie to samo pominięcie AF_NETLINK ugryzło wcześniej w tym projekcie hardening MariaDB. Sandboxing daje bezpieczeństwo i odbiera netlink.)
Patrząc, jak maszyna myśli 📊
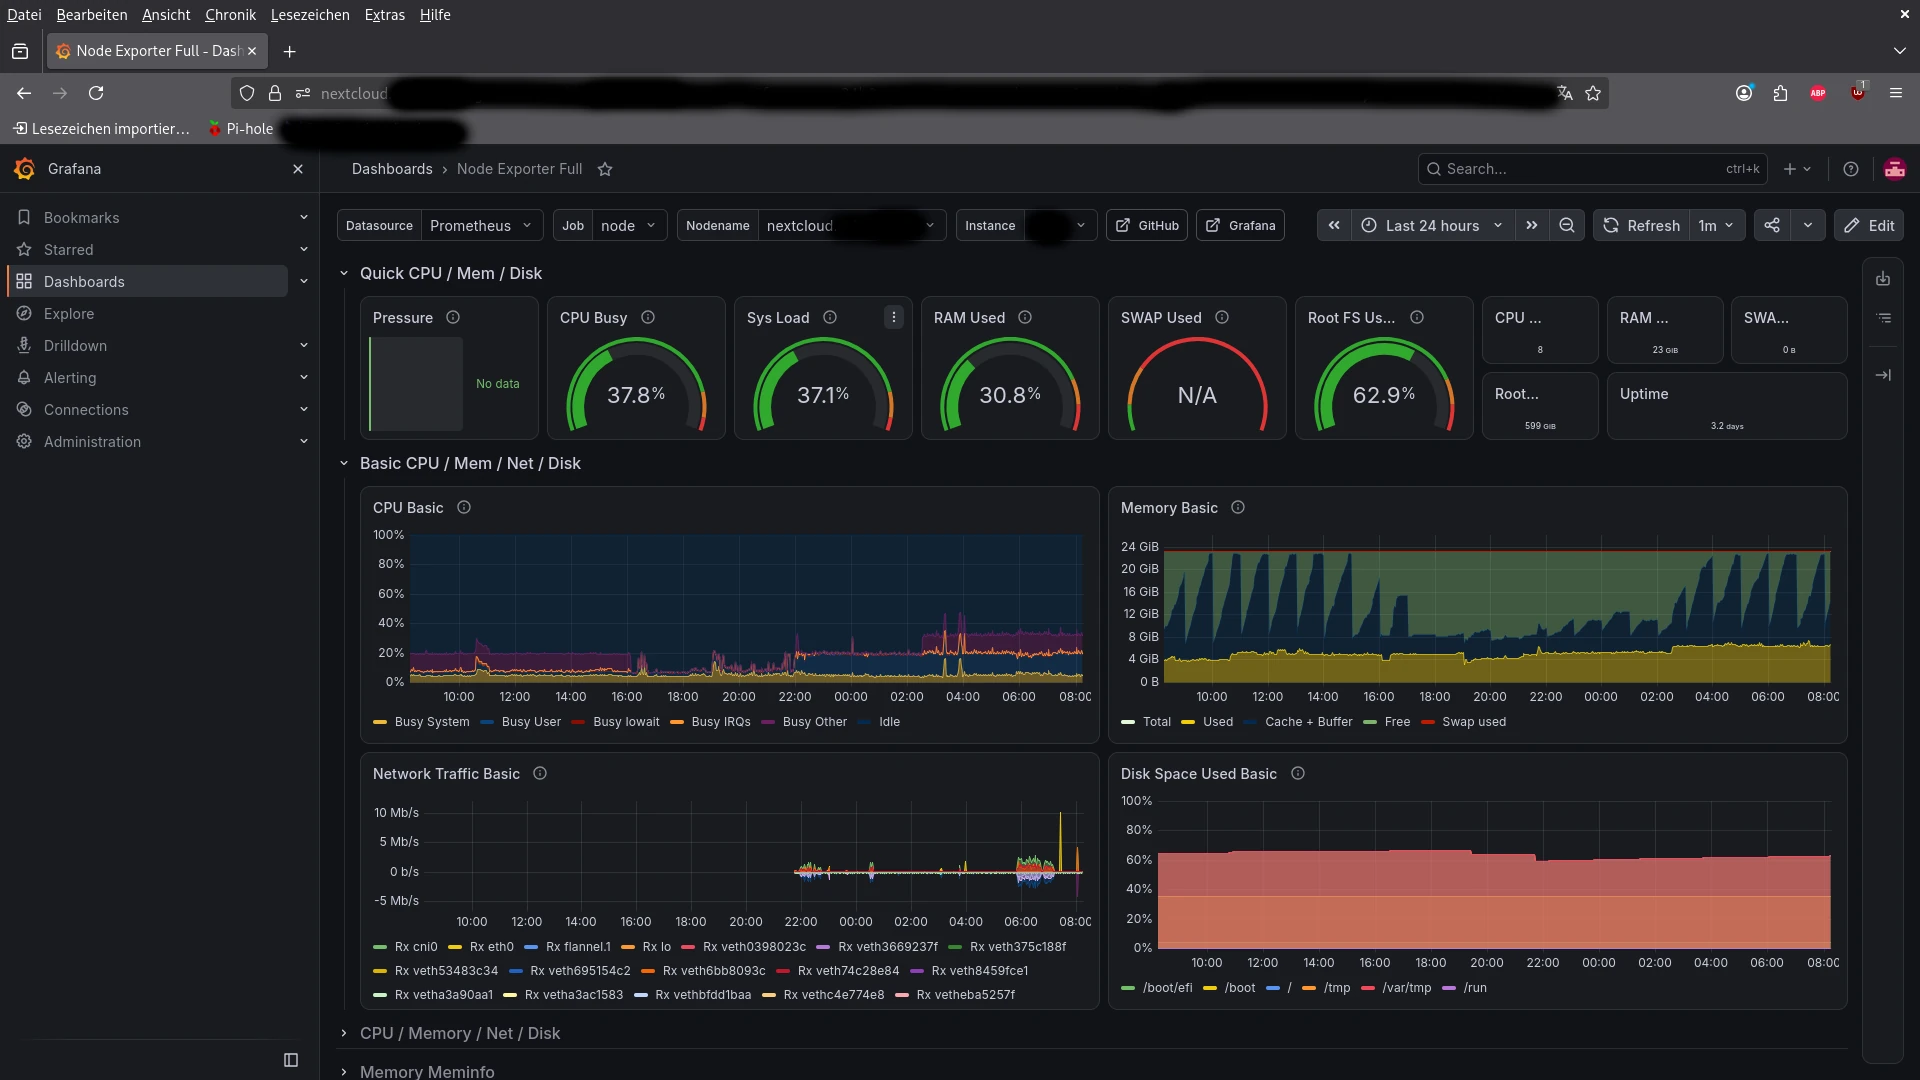
Dwa powiązane ruchy porządkowe domknęły sprawę. Najpierw usunąłem 27 GB osieroconych miniatur podglądów (ich indeks zniknął już przy sprzątaniu bazy powyżej) — podglądy to czysty cache, więc żadnej szkody. Potem, zamiast kazać każdemu wczesnemu testerowi płacić podatek “generuję tę miniaturę, poczekaj chwilę”, odpaliłem pełną regenerację przez occ preview:generate-all. Ten job mielił całą noc, przeżuwając ~35 000 obrazów, PDF-ów i filmów — dashboard powyżej to on przyłapany na gorącym uczynku, a skaner poniżej to ten sam przebieg odbudowujący podglądy plik po pliku.
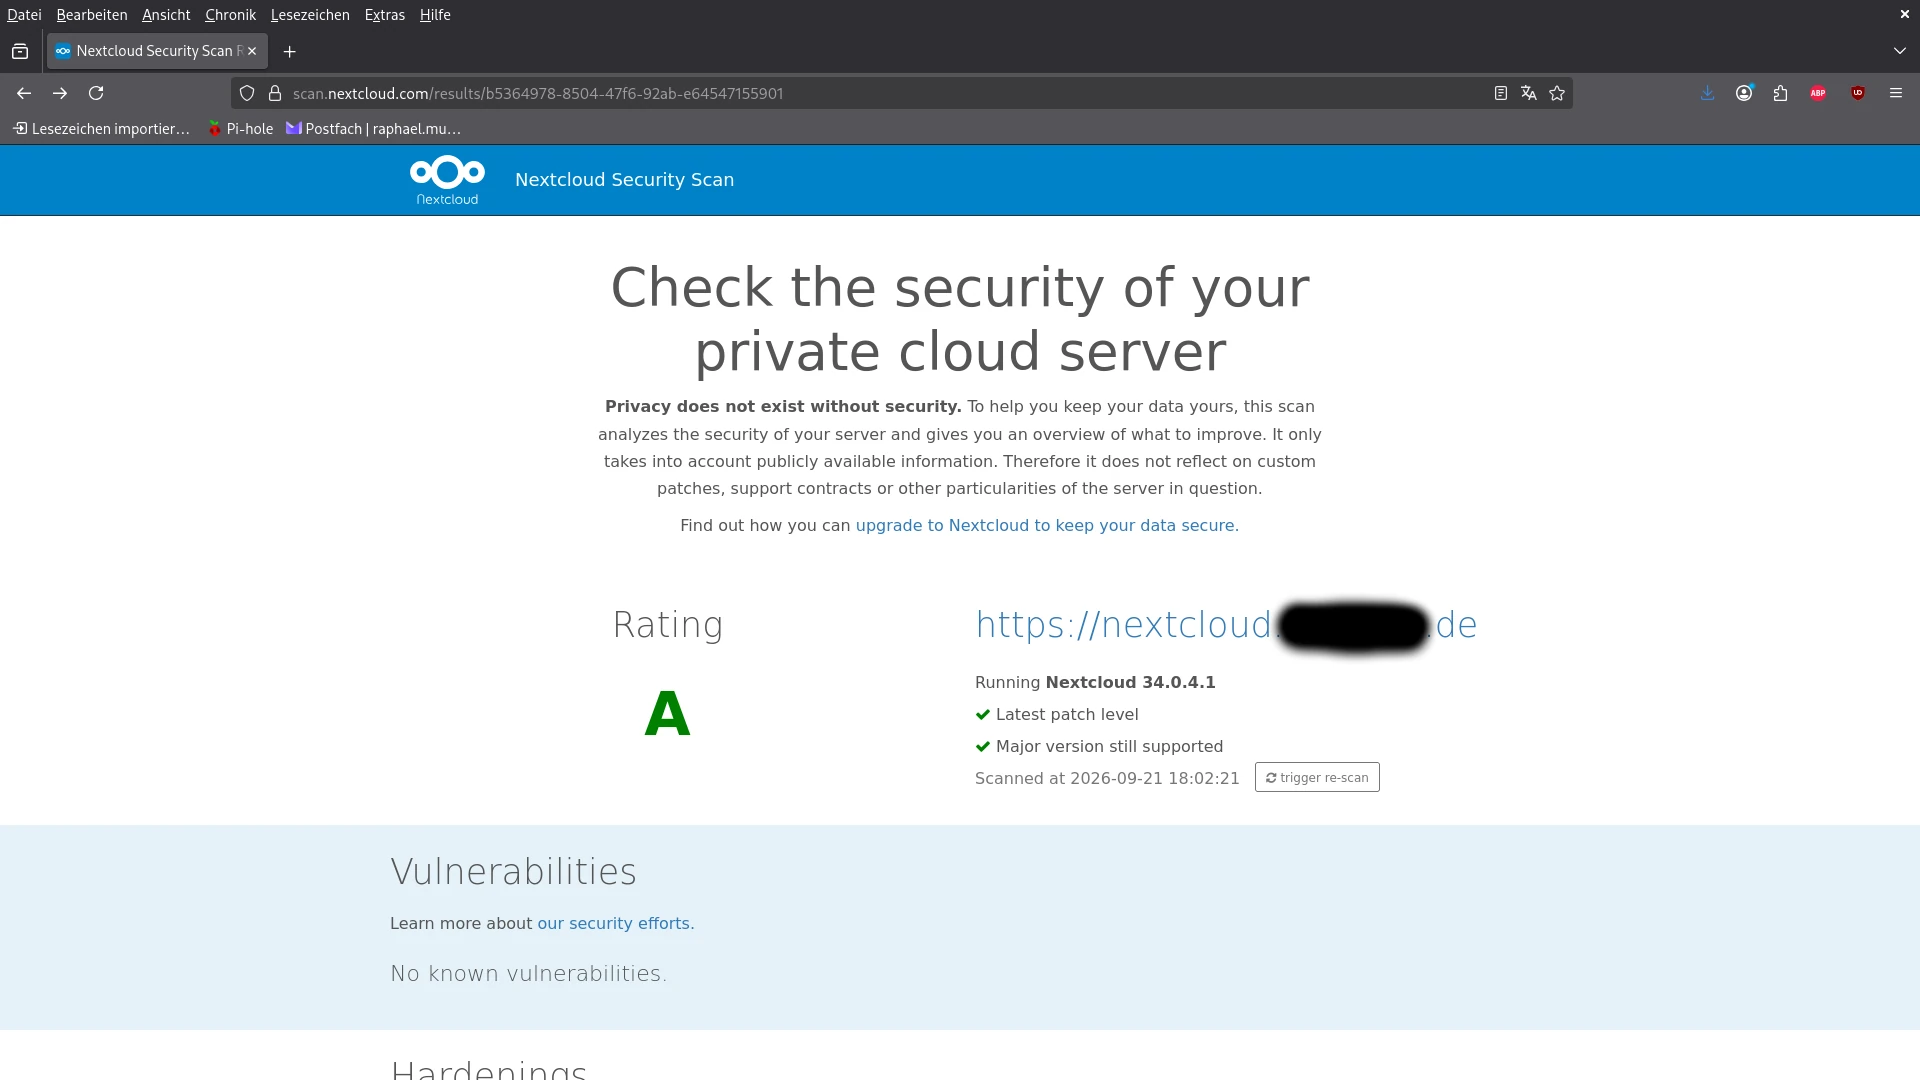
Co prowadzi do małego wyznania: nigdy wcześniej nie miałem takiego dashboardu. Oglądanie CPU, loadu, pamięci i — teraz, gdy gremlin od netlinka jest naprawiony — przepustowości sieci w czasie rzeczywistym daje dziwną satysfakcję. Jestem naprawdę ciekaw, jak to będzie wyglądać w codziennym użyciu: czy zobaczę ładne, czyste szpilki, kiedy ktoś hurtowo wrzuci całą sesję zdjęciową albo zespół ściągnie całą galerię? Jeszcze nie wiem — i to połowa zabawy. Zapytaj mnie za tydzień, kiedy już wystarczająco długo pogapię się na te wykresy, żeby mieć opinie o percentylach, o których istnieniu nie wiedziałem. 😄
Posłowie: probe’y, które naprawdę restartują zawieszony pod 🩺
Dzień później wróciłem i naprawiłem coś, co nie dawało mi spokoju. Pody miały readiness probe’y — Kubernetes wiedział, kiedy nie wysyłać ruchu — ale ich sprawdzenie liveness to był bezzębny kill -0 1, który zauważa coś dopiero, gdy PID 1 już umarł (a wtedy kontenera i tak już nie ma). Proces, który nadal działa, ale się zawiesił — FPM utknął, nie przyjmuje już połączeń na sockecie — po prostu by tam stał, zepsuty, aż człowiek to zauważy. Przy podzie z jedną repliką to dokładnie ten przypadek, który chcesz mieć obsłużony automatycznie.
Rozwiązaniem jest porządny zestaw trzech probe’ów na każdym kontenerze: startupProbe, który wstrzymuje liveness i readiness, aż aplikacja naprawdę nasłuchuje (do ~10 minut tolerancji, żeby wolny occ upgrade albo fala podglądów przy starcie nigdy nie wywołały pętli restartów), readinessProbe, który steruje ruchem, i ciasny livenessProbe — prawdziwe połączenie tcpSocket, nie sprawdzanie PID — który restartuje kontener dopiero, gdy ten naprawdę przestaje odpowiadać. Bramka startowa to element nośny: bez niej liveness probe wystarczająco surowy, żeby złapać zawieszenie, egzekwowałby też kontener, który po prostu wolno się uruchamia. Blog działa na tym samym stacku, więc dla spójności dostał identyczne traktowanie.
Posłowie: strojenie pod sprzęt 🎛️
Kiedy kurz opadł, zaczęła się zabawna część: patrzenie na nowe dashboardy Grafany i strojenie według tego, co faktycznie pokazywały, a nie według tego, co zgadywałem. Maszyna okazała się mieć znacznie więcej zapasu, niż zakładałem — 8 rdzeni, 23 GB RAM, ~16 GB wolnego w spoczynku — więc przestałem skąpić. Collabora poszła z 4 na 6 wstępnie sforkowanych procesów potomnych, a jej limity z 3 na 6 GB i z 2 na 4 rdzenie, co wygładza sporadyczną czkawkę zimnego startu, gdy ktoś pierwszy raz po przerwie otwiera dokument. Przy okazji wylądowało trochę innych szlifów: systemy plików root tylko do odczytu w sidecarach, rozsądniejszy poziom logowania (tylko fatal ukrywa ostrzeżenia, które naprawdę chcesz widzieć) i nauczenie node_exportera, żeby przestał raportować trzy tuziny wirtualnych interfejsów kontenerów, tak by wykres sieci pokazywał tę jedną kartę, która się liczy. Wszystko to mieszka w tym samym repo Ansible — powtarzalne, wersjonowane i nudne w najlepszym możliwym sensie.
Zakładam czarny kapelusz 🕵️
Zanim uznałem sprawę za zamkniętą, zrobiłem to, co powinien zrobić każdy paranoiczny admin: zaatakowałem własną instancję z zewnątrz. Żadnych skanów portów — poza portami webowymi i portem SSH tylko na klucze firewall po cichu odrzuca wszystko, więc niewiele da się znaleźć — tylko żądania, które prawdziwy oportunista wysyła do świeżego Nextclouda, szukając słabego punktu. Krótka wersja: nie było żadnego.
Każda wrażliwa ścieżka zwróciła płaskie 403 — config/, data/, .htaccess, .git/, 3rdparty/, cały komplet. WebDAV i remote.php żądają uwierzytelnienia (401), zanim cokolwiek powiedzą. Nagłówek Server to lakoniczne nginx bez wersji, bez X-Powered-By, bez odcisku PHP do przyłożenia do listy CVE. TLS to 1.3 z ważnym certyfikatem Let’s Encrypt; 1.0 i 1.1 są odrzucane od razu. Pełny zestaw nagłówków bezpieczeństwa jest na miejscu — HSTS z preload, CSP oparta na nonce, nosniff, polityki frame i referrer, zamknięta na cztery spusty permissions policy i ciasteczka __Host-. Własne sprawdzenie integralności kodu Nextclouda raportuje zero zmodyfikowanych plików.
Część, na której zależy mi najbardziej: throttling przeciw brute force jest włączony i — ponieważ łańcuch reverse proxy poprawnie przekazuje prawdziwy IP klienta — hamuje atakującego, a nie mój własny ingress. To jest ten tryb awarii, który po cichu kastruje rate limiting w wielu konfiguracjach za proxy, więc warto to zweryfikować, zamiast zakładać. Nic z tego nie jest egzotyczne; to głównie nudne, poprawne ustawienia domyślne plus kilka świadomych poprawek. I o to właśnie chodzi — najbardziej zniechęcająca rzecz, jaką atakujący może znaleźć, to mur bez szwów. 🧱
Dzień trzeci: wiązanie luźnych końców 🧹
Maraton podglądów z góry w końcu skończył się o świcie trzeciego dnia, po ponad dobie przeżuwania całej biblioteki. Skoro nic już nie pisało do indeksu plików, mogło ruszyć odłożone sprzątanie — a porządne sprawdzenie end-to-end po nim wykryło dwa gremliny, które chowały się na widoku.
“Puste” tabele, które puste nie były
Moje własne notatki mówiły, że pozostałe tabele dawno usuniętych aplikacji (Talk, Polls, Collectives, Maps) są puste i gotowe do usunięcia. Zanim cokolwiek usunąłem, i tak policzyłem wiersze. Nie były puste: kilkadziesiąt stron wiki, kilka ankiet z głosami, kilkadziesiąt pokojów czatu. Nikt ich teraz nie widzi, bo aplikacje nie są zainstalowane — ale zainstaluj aplikację ponownie, a od razu podchwyci swoje stare tabele. Więc zostają. Co poszło: ostatnie resztki OnlyOffice na dysku (najpierw zarchiwizowane, potem usunięte), plus pełny OPTIMIZE, który w 17 sekund wycisnął fragmentację z 59 MB do 2 MB. Lekcja: ufaj liczbie wierszy, a nie własnemu podsumowaniu z wczoraj.
Push zamiast pollingu: notify_push 📡
Klienci synchronizacji Nextclouda normalnie co ~30 sekund pytają serwer: “coś nowego?” Aplikacja notify_push (Client Push) odwraca to — mały demon w Ruście trzyma otwarty WebSocket, a serwer ogłasza zmiany w chwili, gdy się dzieją. (Nie ma to nic wspólnego z powiadomieniami na telefonie; te idą przez push proxy Nextclouda i działały przez cały czas.) Na natywnej maszynie to trzy elementy: aplikacja, usługa systemd i location /push/ w serwerze WWW. Na K3s to te same trzy elementy w innych ubraniach: aplikacja, własny Deployment i trasa Ingress.
Stronę Ansible zbudowałem dzień wcześniej, wyłączoną. Przegląd przed przestawieniem przełącznika wykrył cztery bugi, które dałyby najgorszy możliwy wynik — zielony przebieg playbooka i martwą funkcję, bo każdy krok był ustawiony na tolerowanie błędów. occ działał jako root (Nextcloud odmawia). Binarka była wybierana globem — a alfabetycznie aarch64 jest przed x86_64. Kontener działał jako root z odebranymi wszystkimi capabilities, co brzmi bezpiecznie, dopóki nie zdasz sobie sprawy, że root bez CAP_DAC_OVERRIDE nie przeczyta pliku 0640 należącego do www-data — takiego jak config.php. A ingress przekazywał /push/… bez zmian, podczas gdy demon oczekuje /ws w swoim katalogu głównym.
Nawet po naprawieniu wszystkich czterech pierwszy self-test zwrócił 404 — wyrenderowane przez Nextclouda. Trasa istniała; nginx po prostu nigdy jej nie wybierał. Trasy Nextclouda to łapiący wszystko regex, location ~ "^/", a w nginx regex wygrywa ze zwykłym prefiksem. Więc trasa push też musiała stać się regexem — i nadal przegrywała, bo kontroler ingress wypisuje lokacje regex w kolejności alfabetycznej nazw Ingressów, a nginx bierze pierwsze dopasowanie. notify-push-routes sortuje się po nextcloud-routes; po zmianie nazwy na nextcloud-push-routes (“p” przed “r”) wygrywa. Nie jest to poprawka, z której jestem najbardziej dumny, ale udokumentowana. Wszystkie sześć self-testów zrobiło się zielonych, a pierwsza sesja przeglądarki przeszła na WebSocket (HTTP 101) i otrzymała pierwsze zdarzenia plików. Uczciwy werdykt: dla garstki klientów desktopowych to miły dodatek — zmiany docierają w sekundy zamiast w maksymalnie pół minuty — a nie rewolucja.
Gremlin #1: hardening, który położył bazę danych
W trakcie przebiegu playbooka Nextcloud na moment odpowiedział 500. MariaDB została zatrzymana — czysto, bez crasha. Journal opowiedział historię: dwie sekundy wcześniej rola hardeningu systemu usunęła pakiet rsync jako “nieużywany na tym hoście”. Na hoście bloga to była prawda, tam zostało to sprawdzone. Na hoście Nextclouda pakiet MariaDB-server wymaga rsync — jego narzędzia klastra Galera zawierają skrypt state transfer oparty na rsync, nawet na pojedynczym węźle, który nigdy nie dołączy do klastra. Więc dnf posłusznie usunął razem z nim MariaDB, co zatrzymuje usługę; późniejsza rola zainstalowała oba z powrotem, a kolejna znowu uruchomiła bazę. Efekt netto: dwie do trzech minut przestoju przy każdym przebiegu playbooka, niewidoczne, chyba że akurat patrzyłeś w odpowiednim momencie. Rozwiązanie to jeden warunek: usuwać rsync tylko wtedy, gdy rpm -e --test rsync mówi, że nic od niego nie zależy. “Sprawdzone na hoście A” to nie to samo co “prawdziwe na hoście B”.
Gremlin #2: alerty, które nigdy nie mogły zadziałać
Reguły alertów Grafany — dysk, pamięć, CPU, węzeł niedostępny — wyglądały w UI idealnie. W logu każda z nich przy każdej ewaluacji kończyła się błędem condition must not be empty: kod provisioningu nigdy nie powiedział Grafanie, które zapytanie decyduje o alercie. A ponieważ reguły traktowały błędy ewaluacji jako “OK”, nic nigdy nie zrobiło się czerwone. Jedno brakujące pole, "condition": "B", i teraz ewaluują się poprawnie. Alert, który nie może zadziałać, wygląda dokładnie jak zdrowy system — najgroźniejszy rodzaj zieleni, jaki istnieje. (Podstawowe alerty mailowe przez Monit działały przez cały czas, więc maszyna nie leciała zupełnie na ślepo.)
Gremlin #3: ban za skan portów, którego nie było
Wcześniejsza wersja tego właśnie posta twierdziła, że skan portów “zarabia ci natychmiastowy timeout od fail2ban”. Nie zarabiał. fail2ban reaguje tylko na linie w logach, a firewall loguje odrzucone pakiety z celowo malutką częstotliwością, więc skan po prostu znikał w polityce default-drop. Nieszkodliwie, ale też nikt nie dostawał bana. Firewall miał nawet parę setów opisanych jako “port-scanner blocklist”, i nic związanego ze skanami nigdy ich nie wypełniło. Rozwiązanie mieszka teraz w jądrze: ostatnia reguła przed końcowym dropem liczy próby połączeń na źródło, i widzi tylko pakiety kierowane do zamkniętych portów, więc normalny ruch nigdy się nie liczy. Źródło, które dalej puka, jest przez jakiś czas odrzucane na wszystkich portach. Bez logów, bez demona, bez parsowania.
Wdrożenie tego wyciągnęło na wierzch jeszcze jedną pułapkę. Standardowa usługa nftables przeładowuje się przez flush ruleset, a na hoście Nextclouda kube-proxy, flannel i Calico też trzymają swoje reguły w nftables. Więc każda zmiana firewalla czyściła też własną sieć Kubernetesa, nawet na półtorej minuty, aż się ponownie zsynchronizowała. Teraz ruleset podmienia tylko własną tabelę, w jednym atomowym kroku.
Dni od czwartego do szóstego: czytanie logów jak detektyw 🔎
Kiedy kurz opadł, praca zmieniła się z “niech działa” na “obserwuj dalej”. Przez kilka dni rutyna była prosta: czytać nextcloud.log, logi kontenerów i log ingressu, a przy każdej linii, która wyglądała dziwnie, pytać dlaczego, aż znajdzie się odpowiedź. Jeden warunek wstępny w ogóle to umożliwił: poziom logowania podniesiono z 4 (tylko fatal) do 2 (ostrzeżenia). Na poziomie 4 nic z poniższego by się nie pokazało. Cichy log nie zawsze oznacza zdrowy serwer. Czasem to po prostu wyciszony serwer.
Gremlin #4: jail, który pilnował martwego pliku
fail2ban działał, jaile nginx były “aktywne”, a lista banów była pusta. Przez całe dni. Spokojny tydzień czy zepsuty jail? Kontroler ingress zapisuje swój access log do pliku, którego nazwa kończy się licznikiem (…/0.log, 1.log, …), a każdy restart kontenera zaczyna nowy. fail2ban rozwija glob w logpath tylko przy starcie jaila. Po reboocie fail2ban wstaje przed kontenerem ingressu, przyczepia się do starego pliku, a potem wiernie śledzi log, do którego nikt już nie pisze, na obu hostach. Rozwiązaniem jest mały timer systemd, który zauważa, kiedy zmienia się zestaw plików logów ingressu (i raz po każdym starcie), i przeładowuje tylko jaile nginx. Narzędzie bezpieczeństwa, które melduje “wszystko spokojnie”, bo patrzy na zły plik, jest gorsze niż żadne, bo myślisz, że jesteś chroniony.
Gremlin #5: ping-pong z właścicielem
Przy każdym przebiegu playbooka status.php Nextclouda na chwilę zwracał błąd, a katalog danych oblewał własny test zapisywalności, po czym sam się naprawiał później w tym samym przebiegu. Winowajcą były dwie role, które się ze sobą nie zgadzały. Rola SELinux tworzyła katalogi hostPath jako root:root, a rola deployu ustawiała je na 33:33 (www-data). Każdy przebieg przerzucał właściciela tam i z powrotem, i dopóki następna rola tego nie przywróciła, Nextcloud stał przed katalogiem danych, do którego nie wolno mu było pisać. Teraz obie role ustawiają tego samego właściciela i tryb, i ping-pong się skończył. Dwie role, z których każda robi coś “poprawnego”, wciąż mogą razem dać buga.
Gremlin #6: podglądy Office i ściana 1 MB
Małe pliki Word i Excel dostawały ładne miniatury na liście plików, większe nie. Żadnego błędu w UI, tylko ogólna ikona. Odpowiedź była w logu ingressu: 413 Request Entity Too Large przy każdym wywołaniu convert-to do Collabory. Nextcloud renderuje podglądy Office, wysyłając dokument do Collabory, a domyślny limit ciała żądania w nginx to 1 MB. Trasa Nextclouda miała hojny limit, ale trasa Collabory nigdy żadnego nie dostała. Jedna adnotacja (client-max-body-size: 2g) to naprawiła, a dotknięte podglądy można po prostu wygenerować ponownie. Nieliczne pozostałe błędy convert-to to dokumenty, których Collabora naprawdę nie umie otworzyć, a to problem pliku, nie konfiguracji.
Gremlin #7: zdjęcie 108 megapikseli
Niektóre zdjęcia wciąż nie miały miniatur, a aplikacja ciągle dostawała 404 dla ich podglądów. Wszystkie pochodziły z jednego telefonu, ze 108 megapikselami i 12 032 pikselami szerokości. Zdekodowanie obrazu tej wielkości zajmuje około 430 MB RAM, a preview_max_memory w Nextcloudzie ma domyślnie 256 MB. Powyżej tego Nextcloud nawet nie próbuje. Po cichu pomija podgląd. Podniesione do 512 (własny limit PHP jest daleko powyżej), i zdjęcia w końcu dostały swoje miniatury.
Przy okazji podglądy dostały też zdjęcia HEIC z iPhone’a. To jedna linia w enabledPreviewProviders, z haczykiem: ustawienie tego klucza zastępuje wbudowaną listę domyślną zamiast ją rozszerzać, więc wartości domyślne (PNG, JPEG, GIF, tekst, OpenDocument…) trzeba powtórzyć, inaczej skończysz z podglądami HEIC i bez podglądów JPEG. To, co teraz zostało bez podglądu, to kwestia danych, a nie konfiguracji: kilkadziesiąt 400-bajtowych resztek po nieudanym uploadzie sprzed lat, trochę pustych plików i garstka PNG-ów większych niż 50 MB.
Gremlin #8: konfiguracja, która nigdy nie dotarła
Weryfikacja poprzedniej poprawki po przebiegu playbooka ujawniła coś gorszego. Nowe wartości były w ConfigMapie Kubernetesa, ale custom.config.php w działającym podzie miał jeden dzień. Plik jest montowany przez subPath, a montowanie subPath jest kopiowane raz przy starcie kontenera i nigdy nie jest aktualizowane. Kubernetes aktualizuje zwykłe wolumeny ConfigMap na żywo, ale montowań subPath już nie. Więc każda zmiana konfiguracji w repo zaczynała działać dopiero przy następnym przypadkowym restarcie poda. (Poprawka podglądów działała w międzyczasie tylko dlatego, że została ustawiona też przez occ.)
Standardowym rozwiązaniem jest adnotacja checksum/config w szablonie poda: SHA-256 z wyrenderowanych szablonów konfiguracji. Zmień konfigurację, a zmieni się hash, przez co Kubernetes przetoczy poda. Zostaw konfigurację w spokoju, a nic się nie stanie. Blog dostał to samo dla swoich konfiguracji nginx i PHP. Lekcja: “playbook przeszedł na zielono” i “ustawienie jest aktywne” to dwa różne twierdzenia, więc sprawdź plik wewnątrz kontenera.
Jak wygląda zdrowy log 🩺
Po tym wszystkim codzienny przegląd stał się nudny, i właśnie o to chodzi. Typowy dzień ma teraz garstkę linii w nextcloud.log: podgląd, którego nie dało się otworzyć, notice z PHP. Reszta to szum, który warto znać na pamięć, żeby nie wyruszać co rano na polowanie na duchy:
- Collabora “Broken pipe” / “Connection reset”, około 60 na godzinę, nawet o 3 w nocy: druga strona zamknęła połączenie, zanim Collabora skończyła pisać. Nieszkodliwe.
- nginx “access forbidden” na
/data/.ncdatai/.env: pierwsze to własny test bezpieczeństwa Nextclouda sprawdzający, czy katalog danych nie jest dostępny z sieci, drugie to bot. Oba blokowane celowo. - “config differs from the latest version of this image” przy każdym starcie poda: rola sama zarządza tymi plikami (na przykład Redis z hasłem), więc mają się różnić.
- notify_push “Self test failed” zaraz po reboocie: sprawdzenie TLS raz kończy się błędem certyfikatu (najpewniej ingress przez kilka sekund serwuje jeszcze swój domyślny certyfikat, zanim załaduje prawdziwy). Minutę później self-test jest 6/6 na zielono.
Sens tej listy nie leży w samych wpisach. Kiedy już wiesz, jak wygląda to, co nieszkodliwe, ta jedna linia, która nie jest nieszkodliwa, od razu rzuca się w oczy. To cały trik monitorowania logów. To nie magia, tylko znajomość punktu odniesienia.
Werdykt ✅
Działa na produkcji. Certyfikaty ważne, edycja w Office działa, dane nienaruszone, użytkownicy niczego nie zauważyli. Sama migracja to były łatwe 20%; pozostałe 80% to było polowanie na ustawienia i zachowania, które psują się tylko dokładnie w nowych warunkach. Jak zawsze: serwer nigdy nie był problemem — były nim założenia. 😄
Dzień trzeci dodał do tego przypis. Najpaskudniejsze bugi to nie te, które crashowały — to te, które zostawały zielone: checkbox, tolerujący błędy playbook, reguła alertu, która nie mogła zadziałać. Jeśli ta migracja nauczyła mnie jednego nawyku, to sprawdzania samej rzeczy, a nie rzeczy, która o niej raportuje. 🔍
Jeszcze jedno: to nie było moje jedyne rodeo z Nextcloudem. Jako wolontariusz prowadzę też drugą instancję produkcyjną — mniejszą, z mniejszą ilością danych i mniejszą liczbą zarejestrowanych użytkowników — i wszystko, czego się tu nauczyłem, okazało się naprawdę przydatne. Więc ona jest następna: w ciągu najbliższych dwóch tygodni przeniosę ją na ten sam stack K3s, mając nadzieję, że za drugim razem nadepnę na znacznie mniej tych min. 🤞
Pełny stack Ansible stojący za tym wszystkim — role WordPressa i Nextclouda, ingress, cert-manager, monitoring i każdy wspomniany wyżej trik hardeningowy — jest na GitHubie, bez sekretów i szczegółów hostów: github.com/aptupgrademe/www_k3s. Ta migracja to kamień milowy v3.0.0, więc możesz przeglądać dokładnie ten stan, który opisuje ten post, a nie to, czym akurat dziś jest HEAD.
📚 Więcej w tej serii: Nextcloud z bare metal na K3s