
iLO zna temperaturę, ale nie wczorajszą: historia temperatur dla racka w moim homelabie
🌐 Także w: English · Deutsch · Français · Español · Italiano · Português · Nederlands
Wszystko zaczęło się od prostego pytania w leniwe popołudnie: jak ciepłe są właściwie moje trzy serwery? iLO odpowiedziało natychmiast: powietrze na wlocie 22 do 25 °C, wentylatory na biegu jałowym 6 %, wszystko na zielono. Świetnie. Potem pytanie uzupełniające: a w czasie lipcowej fali upałów? Cisza. iLO 5 pokazuje temperatury i wentylatory wyłącznie na żywo. Bez historii, bez wykresu, bez „zeszłego wtorku”. Więc sam ją zbudowałem i jest na GitHubie: aptupgrademe/ilo-thermal.
Ten sam schemat pracy co zawsze: ja zadaję pytania i podejmuję decyzje, mój współadmin AI (Claude) odczytuje iLO przez Redfish, pisze kod i dwa razy sprawdza każdą liczbę, której ma zaufać. Ta ostatnia część okazała się ważniejsza, niż się spodziewałem.
Spis treści
🌡️ Pierwsze spojrzenie: który czujnik naprawdę coś znaczy?
iLO 5 w DL20 Gen10 Plus udostępnia kilkanaście czujników temperatury. Nie wszystkie są przydatne, a dwa z nich kłamią.
| Czujnik | HP1 | HP2 | HP3 | Werdykt |
|---|---|---|---|---|
| 01-Inlet Ambient | 24 °C | 25 °C | 22 °C | Ten, który się liczy: powietrze zasysane z przodu |
| BMC (układ iLO) | 69 °C | 71 °C | 77 °C | Wygląda groźnie, ale nie jest: samonagrzewanie układu, limit 110 °C |
| CPU 1 | 40 °C | 40 °C | 40 °C | 🤨 identycznie na wszystkich trzech, przy 0 % i 11 % obciążenia |
| AHCI HD Max | 40 °C | 40 °C | 40 °C | 🤨 ta sama historia |
Trzy serwery, różne obciążenie, wszędzie dokładnie 40 °C? To pachniało placeholderem, więc sprawdziliśmy dyski z Windowsa przez SMART: 31 do 35 °C. iLO po prostu nie potrafi odczytać dysków innych niż HPE i wpisuje stałą. Lekcja pierwsza: zweryfikuj czujnik, zanim zbudujesz na nim alerting.
🗺️ Mapa czujników: przód to y = 1, tył to najwyższe y
Następne pytanie było tym ciekawym: czy w ogóle zauważyłbym kumulację ciepła za rackiem? Te modele nie mają czujnika na wylocie. Ale Redfish od HPE mówi, gdzie siedzi każdy czujnik: Oem.Hpe.LocationXmm i LocationYmm tworzą siatkę, w której y = 1 to wlot z przodu, a najwyższe y to sam tył; x to pozycja na szerokość. Mimo „mm” w nazwie to komórki siatki, nie milimetry: wartości biegną tylko od ok. 1 do 14 w serwerze o szerokości 43 cm. Jak głęboka jest siatka, zależy od modelu: w DL20 tylny rząd to y = 13–14, w bardziej kompaktowym MicroServerze siatka kończy się na y = 13. Z tyłu są dwa rodzaje czujników:
- Czujniki układów (BMC, sieciowy układ LOM): zdominowane przez własne ciepło, bezużyteczne dla przepływu powietrza.
- Czujniki stref powietrza (
BMC Zone,PCI 1 Zone): mierzą powietrze wokół siebie, z niewielkim samonagrzewaniem.BMC Zonena HP2 pokazywał 28 °C, tylko 3 °C powyżej wlotu. To mój zastępczy czujnik wylotu.
I tu kluczowy wniosek: sama temperatura z tyłu nic nie mówi, bo podąża za pomieszczeniem. Ciepłe popołudnie podnosi przód i tył. Kumulację zdradza różnica. Jeśli tył-minus-przód rośnie ze zwykłych +3 °C, podczas gdy wlot i obciążenie pozostają takie same, gorące powietrze nie ma którędy uciec. Drugi wczesny wskaźnik: wentylatory przyspieszają, chociaż na wlocie nie jest cieplej.
📍 Lokalizacja, lokalizacja, lokalizacja: cztery stopnie od góry do dołu
Pierwsze godziny historii pokazały jedną rzecz wyraźnie: to, gdzie serwer stoi w racku, liczy się bardziej niż to, który to serwer. To samo pomieszczenie, ten sam rack, to samo obciążenie spoczynkowe, a mimo to powietrze na wlocie różni się o kilka stopni, konsekwentnie, przy każdym odczycie:
| Serwer | Pozycja | Wlot (śr.) | Zakres | Strefa tylna (śr.) |
|---|---|---|---|---|
| HP2 (DL20 Gen10 Plus) | góra racka | 25.9 °C | 25–26 °C | 28.9 °C |
| HP1 (DL20 Gen10 Plus) | środek | 23.9 °C | 23–24 °C | 26.9 °C |
| HP3 (MicroServer Gen10 Plus v2) | blisko dołu | 21.9 °C | 21–22 °C | 25.9 °C |
33 odczyty w pierwszych pięciu godzinach spokojnego wieczoru; wszystkie wentylatory na minimum 6–8 %.
Od dołu do góry temperatura wlotu rośnie w równych krokach po dwa stopnie: 21.9 → 23.9 → 25.9 °C. To cztery stopnie między serwerem przy dole a tym na górze, a między nimi nic poza wysokością. Fizyka jest prosta: ciepłe powietrze unosi się do góry. Wylot wszystkiego poniżej zbiera się u góry racka, a górny serwer część tego powietrza zasysa z powrotem, zwłaszcza gdy góra racka jest zamknięta albo nad nim jest ciasno. Zauważ, że różnica tył-przód wynosi na wszystkich trzech maszynach te same +3–4 °C. Same serwery zachowują się identycznie; różni się powietrze, które dostają.
Dlaczego to ważne:
- Górny serwer pierwszy dochodzi do każdego limitu. W letnie popołudnie przy 30 °C HP3 wciąż miałby komfort, a HP2 już pukałby do progu ostrzeżenia. Planuj pod najcieplejsze miejsce, nie pod średnią.
- Porównuj każdy serwer z nim samym. Stałe „normalne” dla całego racka oznaczałoby HP2 jako permanentnie podejrzany. Dlatego reguły alertów używają 7-dniowej mediany każdego serwera.
- Rozmieszczenie to darmowe pokrętło do strojenia. Postaw na dole maszynę, która grzeje się najbardziej albo jest najważniejsza, zaślep puste jednostki racka panelami, żeby wylot nie przemykał z powrotem na przód, i zostaw górze racka miejsce do oddychania.
Wyznanie: nie doceniłem tego. Kiedy serwery trafiały do racka, strategia rozmieszczenia brzmiała, powiedzmy, „gdzie akurat było wolne miejsce”. Fizyka przepływu powietrza nie miała prawa głosu. Jeśli rack kiedyś dostanie nowy układ, serwery pójdą jak najniżej, ułożone razem na dole, gdzie powietrze jest najchłodniejsze.
Górne miejsce ma zresztą już właściwego lokatora: switch. Według karty katalogowej jest on przewidziany do stabilnej pracy przy znacznie wyższych temperaturach otoczenia niż serwery, więc z ciepłym powietrzem na górze radzi sobie dużo lepiej niż ProLiant. Zasada, którą z tego wyciągam: najcieplejsze miejsce dostaje urządzenie, które najlepiej znosi ciepło, a nie to, które przyszło ostatnie.
We wrześniu nieszkodliwe. Ale teraz dokładnie wiem, którego serwera pilnować w sierpniu, i mam liczby, żeby sprawdzić, czy przestawiony rack naprawdę pomaga.
🧰 Skrypt: nudny z premedytacją
ilo_thermal.py to jeden plik Pythona, tylko biblioteka standardowa. Bez pip, bez requests, bez matplotlib, nic, co mogłoby się zepsuć przy następnym upgradzie dystrybucji. Co 10 minut uruchamia go cron:
- Zbieranie: jeden tylko do odczytu
GETprzez Redfish na każde iLO po dane termiczne. Skrypt łączy się po IP, ale weryfikuje certyfikat TLS względem mojego własnego root CA oraz nazwę w certyfikacie, bo jump host nie korzysta z DNS-a AD. Tak, PKI homelabu z jednego z wcześniejszych wpisów znowu się opłaca. - Zapis: wszystko trafia do SQLite. Mniej więcej 100–150 MB na trzy serwery i 400 dni, pełny rok do porównań.
- Ocena: reguły alertów poniżej.
- Raport: jeden samodzielny plik HTML z wykresami.
🚨 Kiedy podnosi alarm?
| Reguła | Wyzwalacz |
|---|---|
| Limit wlotu | ≥ 30 °C ostrzeżenie, ≥ 35 °C krytyczny (HPE dopuszcza te maszyny do 35 °C otoczenia) |
| Skok temperatury | +4 °C w ciągu godziny: padnięta klimatyzacja, zamknięte drzwi, grzejnik, który ktoś „tylko na chwilę tam postawił” |
| Kumulacja ciepła z tyłu | różnica tył-minus-przód ≥ jej 7-dniowa mediana + 5 °C i ≥ 8 °C |
| Wentylatory bez powodu | wentylatory 20 punktów powyżej normy, choć na wlocie nie jest cieplej: zablokowany przepływ albo kurz |
| Czujnik niesprawny | dowolny czujnik lub wentylator, który nie zgłasza OK |
| iLO nieosiągalne | trzy nieudane odpytania z rzędu |
„Normalne” to zawsze mediana danego serwera z ostatnich siedmiu dni, więc cieplejsze miejsce HP2 na górze nie liczy się jako anomalia. To normalność HP2. Te reguły bazowe uzbrajają się dopiero po dniu historii; świeża instalacja nie będzie cię budzić z powodu szumu. Alerty mają stan: jeden mail na początku, przypomnienie co 12 godzin i mail „rozwiązane” na końcu. Żadnego dywanowego bombardowania skrzynki.
😴 Kolektor śpi, iLO nie
Jest haczyk: mój jump host nie działa 24/7. Odpytywanie działa tylko wtedy, gdy on działa, a ponieważ iLO nie przechowuje historii temperatur, godziny, w których był wyłączony, po prostu przepadają. Raport uczciwie pokazuje je jako luki, zamiast rysować przez noc mylącą prostą linię.
Ale coś iLO jednak przechowuje: Integrated Management Log. Każde zdarzenie sprzętowe (przegrzanie, awaria wentylatora, utrata zasilania, błędy pamięci czy PCIe) jest tam zapisane ze znacznikiem czasu, niezależnie od tego, czy ktoś patrzy. Więc skrypt zapamiętuje najwyższy EventNumber, jaki widział dla każdego iLO, a linia @reboot w cronie uruchamia go dwie minuty po starcie. Wszystko nowsze jest raportowane z oryginalnym znacznikiem czasu.
Żeby to przetestować, cofnęliśmy kursor HP2. Skrypt od razu wygrzebał Uncorrectable PCI Express Error z 23 lipca, którego nikt nigdy nie zauważył:
IML HP2 CRIT: iLO log 2026-07-23 20:29:31 UTC [PCI Bus]: Uncorrectable PCI Express Error Detected.
              (Segment 0x0, Bus 0x1, Device 0x0, Function 0x2)
Jednorazowy, nigdy więcej się nie powtórzył, ale dokładnie taki, o jakim chcesz wiedzieć. Dwa szczegóły trzymają to w ryzach: pierwsze uruchomienie tylko ustawia kursor, więc w pierwszym mailu nie dostajesz całej historii życia swoich serwerów. A klasa IML Network jest domyślnie ignorowana, bo HPE loguje każdy spadek linku jako „Critical”, a to dzieje się przy każdym restarcie po patchu. (Przy okazji grzebania IML pokazał też, że wszystkie trzy serwery straciły link sieciowy dokładnie w tej samej sekundzie 26 września, na 90 sekund. To nie trzy padające serwery, tylko jeden restartujący się switch.)
📈 Raport
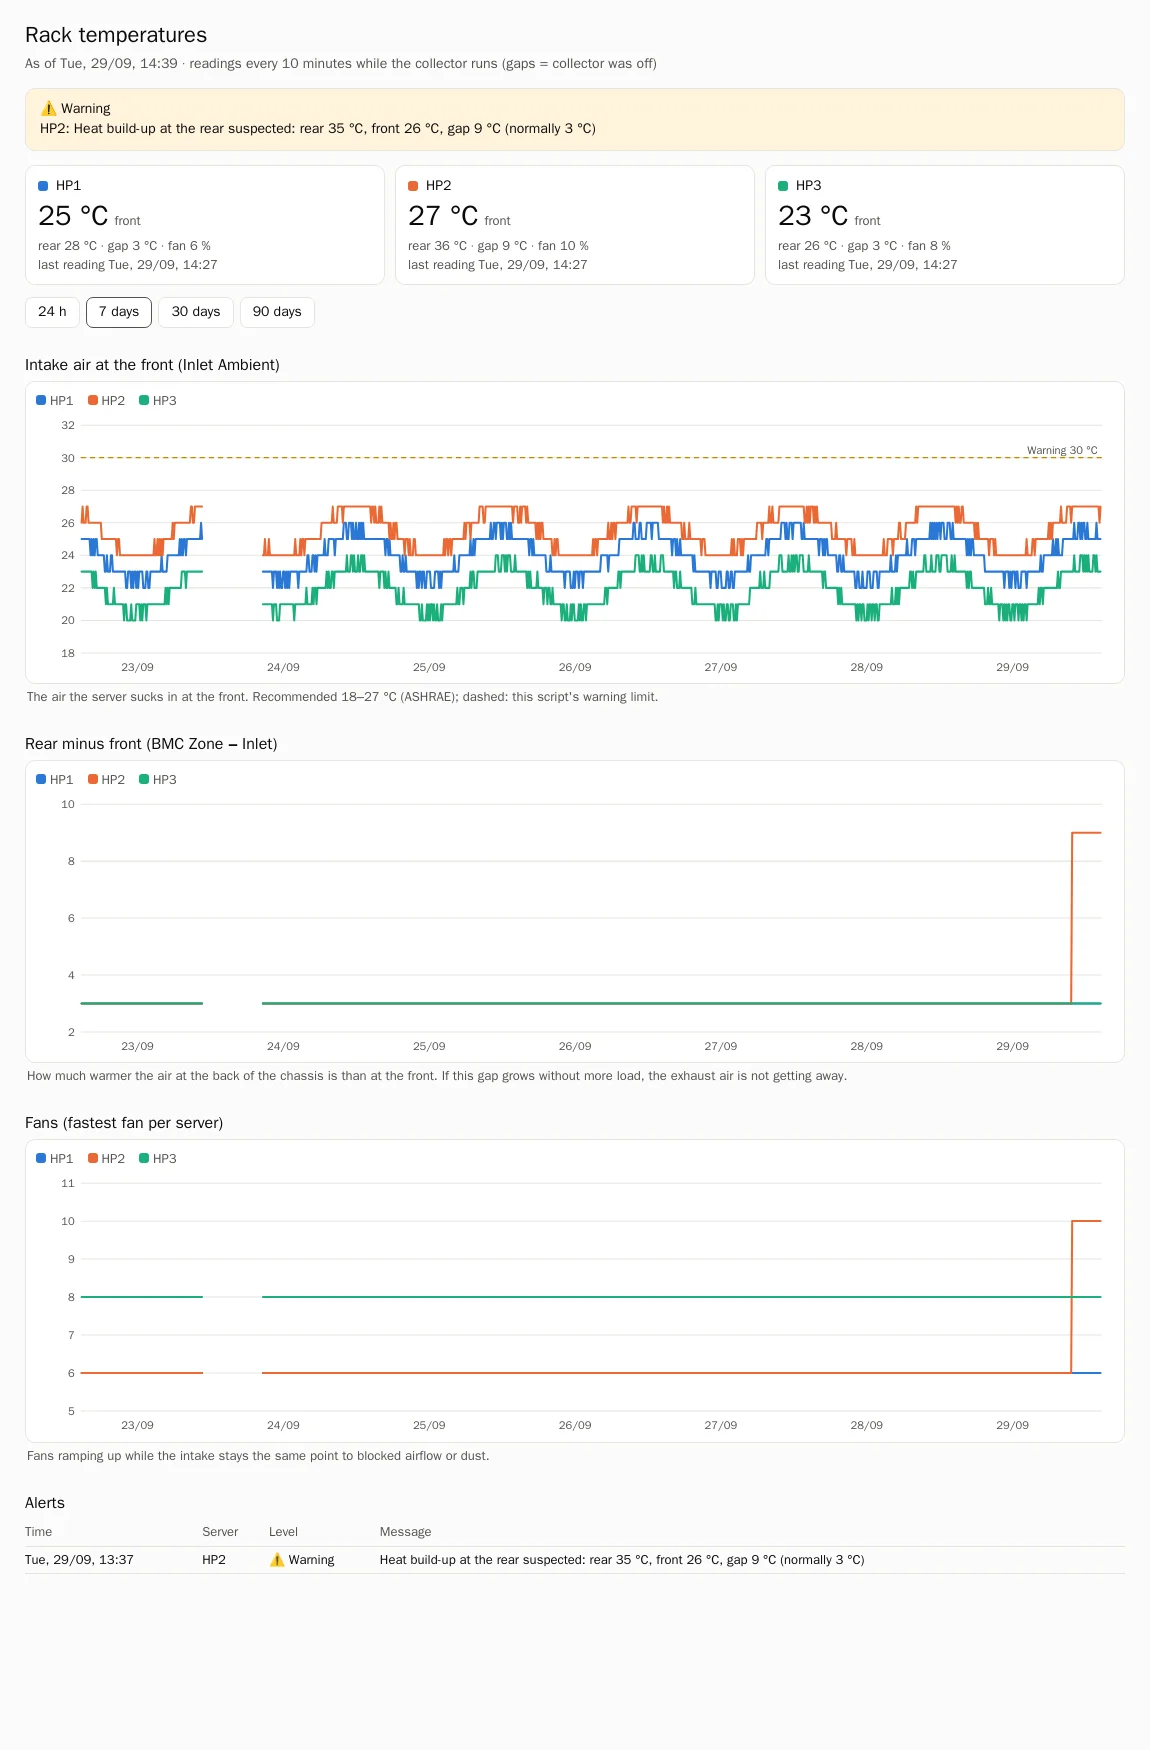
- Trzy wykresy: powietrze na wlocie (z linią ostrzeżenia), różnica tył-minus-przód, wentylatory. Jedna miara na wykres, żadnych zbrodni z podwójną osią.
- Zakresy czasu 24 h / 7 / 30 / 90 dni, podpowiedzi po najechaniu ze wszystkimi serwerami w danej chwili, luki tam, gdzie kolektor był wyłączony.
- Kafelki statusu, baner alertu i historia alertów, łącznie z nadrobionymi wpisami z IML.
- Tryb jasny i ciemny, jeden plik HTML, bez zewnętrznych zależności. Otwórz lokalnie albo wrzuć na udział sieciowy.
📦 Bierz
Wszystko jest w repozytorium: github.com/aptupgrademe/ilo-thermal. Pełna dokumentacja po angielsku, niemiecku, francusku i hiszpańsku: instalacja, konto iLO tylko do odczytu (uprawnienie Login to wszystko, czego potrzeba), każdy klucz konfiguracji, każda reguła alertu, troubleshooting i jak dopasować dwa wzorce nazw czujników do innych modeli ProLiant. Raport i alerty mówią po angielsku lub niemiecku.
git clone https://github.com/aptupgrademe/ilo-thermal.git ~/ilo-thermal
cd ~/ilo-thermal
cp ilo_thermal.conf.example ilo_thermal.conf && chmod 600 ilo_thermal.conf
# edit: iLO account, CA file, hosts, optional SMTP
./ilo_thermal.py collect && ./ilo_thermal.py report

# crontab
*/10 * * * * $HOME/ilo-thermal/run.sh
@reboot      sleep 120; $HOME/ilo-thermal/run.sh
⚠️ Zastrzeżenie
To projekt hobbystyczny, opublikowany w stanie, w jakim jest na licencji MIT. Nie ponoszę żadnej odpowiedzialności za jego poprawne działanie, za pominięte lub fałszywe alerty ani za jakiekolwiek szkody w sprzęcie, danych czy czymkolwiek innym wynikające z jego użycia. Nie zastępuje on własnej ochrony termicznej twoich serwerów ani profesjonalnego systemu monitoringu. Zawsze sprawdź wartości w iLO, zanim na ich podstawie coś zrobisz. Testowane na iLO 5 z DL20 Gen10 Plus i MicroServer Gen10 Plus v2; wszystko inne na twoją odpowiedzialność.
🎯 Wniosek
iLO to fantastyczna migawka i fatalna pamięć. Pół popołudnia zamieniło migawkę w historię, a po drodze nauczyło mnie, że dwa z moich czujników raportują fikcję, że góra racka to zawsze ciepłe miejsce (u mnie cztery stopnie cieplej) i że prawdziwym wskaźnikiem wylotu jest różnica, a nie temperatura. Teraz jest jesień i wszystko jest nudne i zielone. Następnego lata będę miał rok danych do porównania. O to właśnie chodzi. 🌡️📉