
Cztery miliardy tokenów później: jak wygląda miesiąc z asystentem AI w liczbach
Zapytałem małe narzędzie konsolowe, co mój asystent AI zrobił dla mnie w cztery tygodnie. Odpowiedź: prawie cztery miliardy tokenów, 80 powieści tekstu i rachunek na 1400 dolarów, którego nigdy nie musiałem zapłacić. Spojrzenie na liczby - dla osób, które nigdy nie słyszały słowa "token".
🌐 Także w: English · Deutsch · Français · Español · Italiano · Português · Nederlands
Od kilku miesięcy duża część tego bloga i kodu Ansible, który za nim stoi, powstaje razem z asystentem AI: Claude, w wersji wiersza poleceń, czyli Claude Code. Pisze kod, uruchamia polecenia na serwerach, czyta pliki logów i szkicuje artykuły; ja decyduję, sprawdzam i dość często mówię “nie, nie tak”. W pewnym momencie chciałem wiedzieć, ile to wszystko właściwie daje. Nie w odczuciach, w liczbach.
Jest do tego małe narzędzie społeczności, ccusage. Czyta pliki logów, które Claude Code trzyma na moim własnym komputerze, i je sumuje. Jedna linia w terminalu:
npx ccusage@latest daily --since 20260923
npx pobiera narzędzie, uruchamia je raz i znowu o nim zapomina. Czyta tylko lokalne pliki logów i nie wysyła nigdzie nic z ich zawartości; jedyne, co pobiera z internetu, to aktualny cennik. Oto co wyszło dla czterech tygodni od 23 września do 21 października 2026.
Spis treści
🔢 Surowe liczby
| Wartość | |
|---|---|
| Dni z jakimkolwiek użyciem | 25 z 29 |
| Tokeny łącznie | 3 973 410 229 - prawie cztery miliardy |
| … z czego ponownie odczytane z “pamięci” (cache) | 3,90 miliarda (98 %) |
| … nowo zapisane do pamięci | 60,5 miliona |
| … napisane przez asystenta | 8,7 miliona |
| … wpisane przeze mnie jako nowe dane wejściowe | 18 342 |
| Najbardziej pracowity dzień | 19 października: 377 milionów tokenów |
| Wyliczona cena według cennika | 1407 dolarów amerykańskich |
🧩 Czym właściwie jest token?
Model językowy nie czyta liter ani całych słów, czyta tokeny: kawałki słów. “Firewall” to mogą być dwa tokeny, “the” to jeden, a długie niemieckie słowo jak “Datenbankverbindung” może mieć cztery albo pięć. Z grubsza 100 tokenów to około 75 angielskich słów. Wszystko liczy się w tokenach: co wchodzi, co wychodzi i - to jest ciekawa część - co model musi przeczytać ponownie.
📚 98 % ponownego czytania
Najbardziej zaskakujący wiersz tabeli to cache. Z prawie czterech miliardów tokenów 3,9 miliarda wcale nie było nowych. To była ta sama rozmowa, przeczytana jeszcze raz.
Tak działa taki asystent: nie ma pamięci między dwoma krokami. Przed każdą pojedynczą odpowiedzią - każdym poleceniem, które uruchamia, każdym plikiem, który czyta - dostaje ponownie całą dotychczasową rozmowę: moje pytania, swoje odpowiedzi, każdy fragment logu, każdy plik. Długa sesja pracy na serwerze łatwo dorasta do rozmiaru krótkiej książki, a ta książka jest czytana od nowa przed następnym krokiem. I następnym. I następnym.
Wyobraź sobie urzędnika, który przed napisaniem każdego zdania listu czyta całą teczkę od pierwszej strony. To mój asystent. Na każdy token, który napisze, ponownie czyta około 450. Dobra wiadomość: ponowne czytanie jest tanie. Dostawca trzyma rozmowę gotową w cache, więc ponownie przeczytany token kosztuje tylko około jednej dziesiątej nowego. Co też wyjaśnia, dlaczego cztery miliardy tokenów brzmią znacznie dramatyczniej, niż są.
✍️ Co to oznacza w codziennych kategoriach
- 80 powieści. 8,7 miliona tokenów napisanych przez asystenta to około 6,5 miliona słów - mniej więcej 80 powieści średniej długości. Wydrukowane dałyby stos papieru wysoki na około 2,6 metra. Większość z tego, uczciwie mówiąc, to nie literatura, tylko pliki konfiguracyjne, polecenia powłoki i wyjaśnienia, dlaczego firewall zrobił coś nieoczekiwanego.
- 23 lata czytania. Gdyby człowiek chciał przeczytać wszystkie cztery miliardy tokenów w normalnym tempie, bez snu, bez kawy, bez weekendów, potrzebowałby około 23 lat. Przy ośmiu godzinach dziennie byłoby to całe życie zawodowe.
- 475 razy więcej odpowiedzi niż pytań. Moje własne nowe dane wejściowe to 18 342 tokeny - kilka stron tekstu w cztery tygodnie. Krótkie polecenia w stylu “sprawdź logi”, “tak, zrób to tak” albo “czemu to jest na czerwono?”. Reszta pochodzi od asystenta: wszystko, co przeczytał na serwerach, napisał i wyjaśnił.
- Cztery dni wolnego. 25 z 29 dni miało jakieś użycie. Najwyraźniej nawet asystent AI dostaje czasem weekend - a raczej jego człowiek.
💸 Rachunek, który nigdy nie przyszedł
Narzędzie wylicza też cenę: 1407 dolarów amerykańskich za cztery tygodnie, około 56 dolarów na aktywny dzień, 118 w najbardziej pracowitym. Brzmi jak dużo - i to nie jest to, co zapłaciłem.
Ta liczba to koszt takiego użycia według cennika API, czyli interfejsu, którego firmy używają, żeby wbudować model we własne produkty. Tam rozlicza się każdy pojedynczy token: nowe wejście, wyjście, zapis do cache, odczyt z cache, każde według własnej stawki. ccusage po prostu mnoży moje liczby tokenów przez te stawki.
Ja zamiast tego korzystam z subskrypcji, planu Pro, który według cennika kosztuje około 20 dolarów amerykańskich miesięcznie. Subskrypcja to ryczałt z limitami użycia: pracujesz, aż osiągniesz limit dla danego okna czasowego, a potem czekasz, aż się zresetuje. Te 1407 dolarów to więc “co by było, gdyby” - ile kosztowałaby ta sama ilość pracy, gdyby każdy token rozliczano osobno. Dla prywatnego projektu ryczałt to oczywisty wybór; dla firmy, która wbudowuje model w swój produkt, cena za token to normalny przypadek.
Te limity zresztą nie są teoretyczne. Najdroższym pojedynczym zadaniem miesiąca było późniejsze tłumaczenie bloga: wszystkich 111 istniejących wpisów na niemiecki, francuski i hiszpański. Trwało to kilka dni i wiele sesji, bo ciągle wpadałem na pięciogodzinny limit - praca zatrzymywała się w połowie artykułu, a nowa sesja podejmowała ją, gdy okno się zresetowało. Tłumaczenie to jednoczesne czytanie i pisanie, i to w dużych ilościach; widać to w statystykach, gdzie 9 i 11 października należą do bardziej pracowitych dni. Ludzki tłumacz potrzebowałby na to miesięcy. Asystent potrzebował kilku dni i mojej cierpliwości do licznika resetu.
⚡ A ile komputerów musiało do tego pracować?
To pytanie, na które najchętniej bym odpowiedział, i to, na które nie potrafię uczciwie odpowiedzieć liczbą. Model nie działa na moim komputerze, tylko w centrach danych, na wyspecjalizowanych układach zbudowanych dokładnie do tego rodzaju obliczeń. Jak duży jest model, ile układów odpowiada na jedno zapytanie i ile energii kosztuje jeden token - tego dostawca nie publikuje, a każda precyzyjna liczba byłaby tu zmyślona.
Co można powiedzieć: model tej klasy w ogóle nie uruchomi się na domowym PC. Potrzebuje znacznie, ale to znacznie więcej pamięci, niż ma zwykły komputer. A ponowne czytanie z cache wymaga dużo mniej obliczeń niż liczenie czegoś nowego - i właśnie dlatego jest o tyle tańsze. Te 98 % ponownego czytania oznaczają więc dużo mniej pracy w centrum danych, niż sugeruje surowa liczba tokenów.
🏗️ Co z tego wyszło
Liczenie tokenów jest zabawne, ale prawdziwe pytanie brzmi: do czego się przydały. W ciągu około pięciu miesięcy powstało to:
| Rozmiar | |
|---|---|
| Role Ansible | 39 |
| Kod (taski, szablony, skrypty) | około 36 000 linii, z czego jedna piąta to komentarze i wyjaśnienia |
| Dokumentacja operacyjna | w trzech językach, około 16 000 linii |
| Wpisy na blogu | około 30, każdy w czterech językach |
| Serwery | ten blog i dwie instancje Nextcloud, utwardzone i monitorowane |
Ile by to trwało klasycznie, pisane ręcznie? Dla kodu infrastruktury często przyjmuje się z grubsza 30 do 80 gotowych, przetestowanych linii dziennie - łącznie z researchem, próbami na prawdziwych serwerach i troubleshootingiem, który często trwa dłużej niż samo pisanie. Doliczając dokumentację i tłumaczenia, szacunek wychodzi na dwa do trzech lat pracy na pełen etat dla jednej doświadczonej osoby. Ta osoba musiałaby też jednocześnie dogłębnie znać SELinux, Kubernetes, firewalle, bazy danych, Nextcloud, WordPress i monitoring - a to rzadkość.
Ja też nie jestem tą osobą. Ale po drodze wiele się nauczyłem, i to dużo szybciej, niż byłoby to możliwe inaczej. Za każdym razem, gdy coś nie działało, od razu dostawałem wyjaśnienie: dlaczego SELinux odrzuca przejście, czym jest nagłówek hop-by-hop, dlaczego baza danych działa bez ochrony, choć wszystko mówi “enforcing”. To nauka dokładnie w chwili, gdy pojawia się pytanie - prywatny korepetytor, który zawsze ma czas i nigdy nie mówi “najpierw przeczytaj rozdział 7”. Podręcznik wyjaśnia mnóstwo rzeczy, których w danej chwili nie potrzebuję, a ta jedna strona, której potrzebuję, jest gdzieś w środku. Tutaj zgłębiałem temat celowo, zadawałem pytania uzupełniające, a deep dive’y na tym blogu to to, co z tego zostało.
Linie kodu to zgrubna miara, a szacunek to wyczucie rzędu wielkości, nie faktura. Ważniejsze jest to, czego liczby nie pokazują: asystent niczego nie zdecydował sam. Każda zmiana na serwerze produkcyjnym była najpierw omówiona, każdy wynik sprawdzony, a niektóre z najlepszych odkryć wzięły się z prostego “to wygląda dziwnie, możesz sprawdzić jeszcze raz?”. Deep dive o SELinux opisuje dwa z nich. Gdzieś koło dwudziestego dnia zrozumiałem też, skąd się wziął ten stary informatyczny żart - że niektórzy z nas rozmawiają więcej ze swoją AI niż z prawdziwymi ludźmi, łącznie z własnym partnerem. Na swoją obronę: AI ani razu nie narzekała, że tłumaczę reguły firewalla przy kolacji. AI przejmuje skrupulatność; odpowiedzialność zostaje przy człowieku. A to jest projekt prywatny - co oznacza, że konkuruje o czas ze wszystkim innym w życiu. I o to właśnie chodzi: właśnie dlatego, że ten czas jest ograniczony, tempo pracy z AI zrobiło różnicę. Kilka wolnych godzin nie wystarczy, żeby ręcznie napisać firewall. Wystarczy, żeby go omówić, sprawdzić i wdrożyć.
🔍 Co zdradzają statystyki
- Duże tematy robią duże dni. Najbardziej pracowity dzień, 19 października, to dzień, w którym powstawały i były testowane ostatnie części Ansible tour i artykuł o SELinux - dużo czytania na serwerach, dużo tekstu.
- Kontekst to prawdziwy czynnik kosztów. Nie to, co ja wpisuję, ani nawet to, co pisze asystent, tylko to, ile musi mieć w pamięci. Długie sesje z wieloma fragmentami logów są drogie; krótkie, skupione zadania są tanie.
- To nie model pisze najwięcej. On czyta. 450 przeczytanych tokenów na każdy napisany - to mniej “maszyna do kreatywnego pisania”, a bardziej “bardzo szybki kolega, który za każdym razem czyta całą teczkę”.
🧔 Moje osobiste zdanie - trochę zaczepne i tylko moje
Dla mnie prawdziwa wartość tego wszystkiego to nie sprytne odpowiedzi. To czas. Dwa do trzech lat pracy w około pięć miesięcy - to różnica między projektem, o którym bym marzył, a projektem, który działa. Hardening, monitoring, dokumentacja w trzech językach, blog w czterech: nic z tego nie istniałoby w tej formie bez asystenta, po prostu dlatego, że ludzkie życie ma ograniczoną liczbę wieczorów.
Oto więc moje osobiste zdanie, jako kogoś z 20 latami doświadczenia zawodowego, kto ręcznie napisał więcej niż dość plików konfiguracyjnych: w moich własnych prywatnych projektach pisanie kodu infrastruktury linia po linii ręcznie nie pasuje już do czasów. Dla mnie to jak karta perforowana naszej epoki - uczciwe, godne podziwu, a dla mnie osobiście sposób na spędzenie trzech lat nad czymś, co teraz mogę zrobić w kilka miesięcy. To nie jest ocena kogokolwiek innego: niektórzy z najbardziej skrupulatnych administratorów, jakich znam, piszą każdą regułę sami i mają ku temu dobre powody. Ja po prostu przeniosłem swoją staranność gdzie indziej - do pytań, przeglądu, testów i decyzji. Tam uważam człowieka za niezastąpionego i tam idzie mój zaoszczędzony czas.
Ręcznie pisany Ansible oczywiście przetrwa, i słusznie - obok płyt winylowych, klawiatur mechanicznych i osoby, która z zasady kompiluje własne jądro. Może kiedyś dołączę do nich z nostalgii. W moich własnych projektach, w tym odrobinie wolnego czasu, który zostaje obok rodziny i pracy, nie jest to już jednak metoda, którą wybieram.
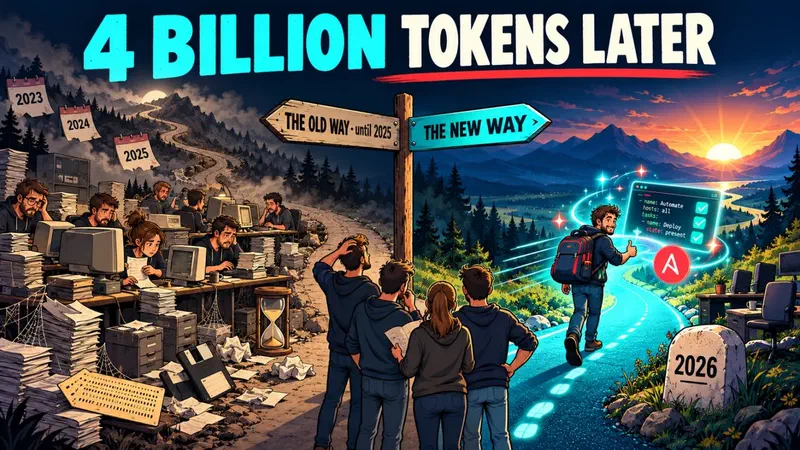
A jednak jest też mniej wesoła strona tego wszystkiego i byłoby nieuczciwie ją pominąć. Dwa do trzech lat pracy jednej osoby w pięć miesięcy - odwracając to, oznacza to także: projekt, który kiedyś długo zajmował mały zespół, teraz potrzebuje jednej osoby i asystenta. Dla mnie, z prywatnym projektem i ograniczonym czasem, to czysty zysk. Dla zespołów i zawodów, które żyły właśnie z takiej starannej pracy ręcznej, to realne pytanie i nikt jeszcze nie ma na nie dobrej odpowiedzi. Prawa ścieżka jest szybsza. Jest też bardziej pusta.
Myślę, że wielu z nas stoi teraz na tym rozwidleniu, czy tego chcemy, czy nie - administratorzy, programiści, autorzy tekstów technicznych, tłumacze. Ja wybrałem prawą ścieżkę, bo w mojej sytuacji jest wyraźnie lepsza - w innych sytuacjach odpowiedź może być zupełnie inna. Ale co jakiś czas oglądam się przez ramię. Ludzie, którzy wciąż stoją przy drogowskazie, nie są zacofani. Ważą coś, co zasługuje na to, by to zważyć.
🎬 Podsumowanie
Cztery miliardy tokenów brzmią jak liczba z science fiction. Przełożone na codzienność to kolega, który nigdy nie ma dość ponownego czytania całej teczki, w cztery tygodnie pisze 80 powieści konfiguracji i przysłałby rachunek na 1400 dolarów, gdyby nie było ryczałtu. Zostaje kod, który działa, serwery lepiej chronione niż wcześniej i blog, który teraz mówi w czterech językach. I świadomość, że najkrótsze zdanie we wszystkich tych miliardach - “tak, zrób to tak” - wciąż było najważniejsze.
I ostatnia osobista uwaga. Oficjalnie nazywam ten blog i kod na GitHubie moim wolontariatem w 2026 roku – po prostu lepiej to brzmi na imprezach 😉 Szczerze mówiąc, jest to jednak przede wszystkim najlepsze dokształcanie, jakie kiedykolwiek miałem: uczę się technicznie niesamowicie dużo, więcej w kilka miesięcy niż na niejednym szkoleniu, bo każde pytanie dostaje odpowiedź dokładnie wtedy, gdy się pojawia, a mój skąpy wolny czas idzie na rozumienie zamiast na szukanie. Wydajnie, skutecznie, ani minuty straconej. Napisane przez xenniala, urodzonego w 1979 roku, czyli dokładnie o rok za wcześnie, by oficjalnie zaliczać się do cyfrowych tubylców, ale akurat na tyle późno, by dorastać między magnetofonem kasetowym a pierwszym modemem – więc krzywa uczenia się jest stroma, ale frajda też. Część wolontariacka przychodzi jako bonus: wszystko kończy się jako coś, z czego każdy, gdziekolwiek na świecie, może korzystać za darmo, jeśli stoi przed tymi samymi zadaniami: bezpiecznym uruchamianiem WordPressa lub Nextcloud na własnych serwerach. Jeśli zaoszczędzi to komuś w innym kraju kilka wieczorów, te cztery miliardy tokenów były dobrze wydane.
Jeśli chcesz zobaczyć swoje własne liczby: npx ccusage@latest daily w terminalu na komputerze, na którym działa Claude Code. Czyta tylko lokalne pliki i nie pobiera niczego poza cennikiem.