
Świąteczny film dla zespołu – w połowie chmura, w połowie homelab
Świąteczny film dla naszego zespołu monitoringu, zrobiony z AI: sceny z ludźmi z chmury, dźwięk, muzyka, montaż i szlify na moim własnym sprzęcie. Co gdzie działało lepiej – i co mimo wszystko poszło nie tak.
🌐 Także w: English · Deutsch · Français · Español · Italiano · Português · Nederlands
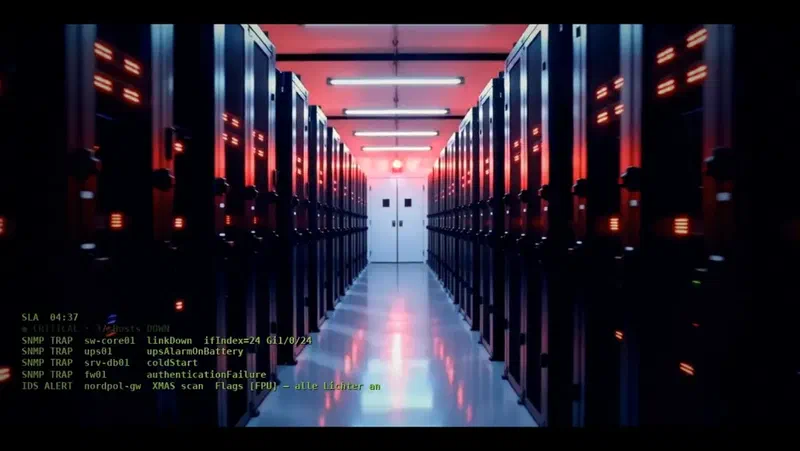
Do wewnętrznego kalendarza adwentowego naszego zespołu monitoringu chciałem krótki film: w centrum danych diody LED przeskakują z zielonego na czerwony, alarm, bicie serca, przewijanie – a na końcu winny jest oczywiście Mikołaj, który potknął się o „kabel od Wi-Fi”. Efekt to niecałe 100 sekund filmu, który szlifowałem przez ponad 70 wersji z Claude Code jako asystentem reżysera.
Ciekawsze od samego filmu jest pytanie, które części pochodziły z chmury, a które działały na moim własnym sprzęcie. W skrócie: obrazy, które się liczą, przyszły z chmury – cała reszta działała lokalnie.
Spis treści
☁️ Z chmury: sceny z ludźmi
Do samych scen wideo użyłem ArtCraft, subskrypcji dającej dostęp do kilku komercyjnych modeli:
- Seedance 2.0 (wideo): centrum danych, centrum monitoringu, zbliżenie na diody, Mikołaj z poirytowanym reniferem. 4-sekundowy klip w 720p kosztuje około 100 kredytów.
- Nano Banana Pro (edycja obrazów): zdjęcie grupowe – koledzy jako sylwetki, czapki Mikołaja, śnieg. 15 kredytów za obraz.
Nie sterowałem ArtCraft przez interfejs, tylko przez serwer MCP: Claude Code pisze prompt, wgrywa obrazy referencyjne i pobiera wynik. Z jedną stałą zasadą: przed każdym zadaniem Claude podaje koszt i czeka na moje „Start” – wysłanego zadania nie da się odwołać.
Wniosek: jeśli chodzi o realistycznych ludzi w ruchu, chmura jest dziś wyraźnie z przodu. Ale każdy klip kosztuje prawdziwe pieniądze, a kredyty znikają szybciej, niż myślisz – na koniec saldo było puste, zanim powstał ostatni pomysł.
🖥️ Lokalnie: wszystko wokół obrazów
Resztę zrobiła maszyna z kartą graficzną RTX (8 GB pamięci wideo):
- ComfyUI jako rama dla lokalnych modeli
- MMAudio: efekty dźwiękowe pasujące do obrazu – parskające renifery, szeleszczące kable, potknięcie
- ACE-Step: szkice muzyczne w różnych stylach; finalny film używa wolnego od tantiem epickiego utworu z biblioteki muzycznej
- Chatterbox (text-to-speech): narrator
- Whisper: kontrola, czy „Icinga” i „Zabbix” są wymawiane wyraźnie
- RIFE: klatki pośrednie z AI do slow motion
- ffmpeg i Python: cięcie, przejścia, tekst, iris wipe, napisy końcowe w stylu maszyny do pisania, zakończenie w terminalu z
systemctl status weihnachtenoraz mastering głośności
Lokalnie próby kosztują tylko prąd i czas. Tam dzieje się większość iteracji: jeden głos brzmiał blaszanie, inny miał angielski akcent, muzyka była zbyt popowa – dwanaście wariantów jednej kwestii to lokalnie żaden problem.
Wniosek: chmura dostarcza drogi surowy materiał, homelab robi z niego film. Dzięki temu koszty są niskie, a kontrola zostaje u ciebie.
🎞️ Gdzie lokalnie nie wystarcza – a gdzie jest lepiej
Na początku próbowałem tworzyć lokalnie również sceny wideo, z Wan 2.1/2.2. Przy 8 GB pamięci wideo wyniki były toporne: prymitywne twarze, nienaturalny chód, za krótkie klipy.
Tak to wyglądało w praktyce – ten sam alarm w centrum danych, wygenerowany w całości na domowym PC (karta graficzna RTX 3050 z 8 GB): najpierw zgrubny szkic z Wan 2.1 (1.3B), potem dopracowany z Wan 2.2 A14B. Porównaj to ze zwiastunem powyżej, gdzie sceny z ludźmi pochodzą z chmury.
W drugą stronę „mądrzejsze” AI bywało gorszym wyborem:
- Upscaling do 1080p: Real-ESRGAN wyostrzał krawędzie, ale powierzchnie robiły się woskowe. Klasyczny upscaling z lekkim wyostrzeniem wyglądał naturalniej.
- Klatki pośrednie: estymacja ruchu w ffmpeg dawała artefakty blokowe przy szybkich dłoniach i na wzorach diod w szafach. RIFE był dużo czystszy – tylko tam, gdzie dioda przeskakuje z zielonego na czerwony, RIFE też wymyślił błędną klatkę. W tym miejscu jest teraz oryginał.
Wniosek: „więcej AI” nie znaczy automatycznie lepiej. Każde narzędzie gdzieś wymyśla szczegóły, których nie ma – i trzeba je znaleźć.
👀 Sprawdzanie tego, czego nie widać
Claude nie potrafi ani odtworzyć wideo, ani go usłyszeć. Kontrole szły więc okrężną drogą: pojedyncze klatki i contact sheety, głośność na scenę (sceny różniły się wcześniej nawet o 15 dB), rozpoznawanie mowy pod kątem wymowy i ukrytych wokali, porównywanie obrazów pod kątem dokładnych łączeń.
Mimo to znalazłem błędy, których nie pokazał żaden pomiar: kobiece „Aaa”, które w rzeczywistości było artefaktem na końcu nagrania głosu, szare, zaszumione tło po filtrze obrazu, nakładkę tekstową przelatującą przez pomieszczenie podczas przenikania. A raz 2,5-sekundowe wydłużenie po prostu nic nie zrobiło – bez komunikatu o błędzie.
Wniosek: mierzenie nie zastępuje oglądania. Narzędzia znajdują poziomy i formaty, ludzie znajdują to, co wygląda „dziwnie”.
🔧 Aktualizacja z listopada 2026: co doszło od tamtej pory
Od czasu świątecznego filmu zrobiłem kilka krótkich prywatnych klipów: skok spadochronowy nad miastem, kaskaderski numer z dwoma samochodami, taniec na Marsie, breakdance na placu. Po drodze zestaw narzędzi urósł:
- Klatka początkowa i końcowa dla Seedance: na początku serwer MCP potrafił przekazywać tylko obrazy referencyjne. Rozszerzyłem go tak, żeby klip mógł zaczynać się od zadanego obrazu i kończyć na innym. Scena zaczyna się wtedy dokładnie tam, gdzie skończyła poprzednia, a jeśli klatka początkowa i końcowa to ten sam obraz, osoba po szalonym ruchu wraca do pozycji wyjściowej. Nie działa to za każdym razem: raz model całkowicie zignorował klatkę początkową.
- Kilka zdjęć referencyjnych jednej twarzy (Nano Banana Pro): przy jednym zdjęciu twarz odpływa. Sześć do ośmiu zdjęć z różnych kątów wyraźnie przybliża efekt. Rozmiar też ma znaczenie: twarz o szerokości zaledwie 60 pikseli na obrazie jest w większości wymyślona.
- Lokalny face swap (InsightFace z GFPGAN): tam, gdzie twarz z chmury wciąż nie pasowała, face swap na moim własnym komputerze wstawia prawdziwą twarz do nieruchomego obrazu, uśrednioną z kilku zdjęć referencyjnych. Model rozpoznawania twarzy mierzy wynik: podobieństwo wzrosło z około 0,5 do 0,87. Ograniczenia: podmienia twarz, ale nie włosy, przejmuje mimikę obrazu docelowego, a przy szybkim ruchu migocze. Dlatego używam go tylko tam, gdzie twarz jest spokojna.
- Przepływ optyczny i usuwanie tła (OpenCV, rembg): przepływ optyczny pokazał w liczbach, że w jednym klipie kamera przez trzy sekundy dryfowała do tyłu – coś, co zauważyłem, ale nie umiałem udowodnić. rembg wyciął samochód, dzięki czemu sztuczny dym z opon mógł znaleźć się za nim, a nie na nim.
- Dźwięk warstwami: odgłosy silnika i opon jako osobne warstwy MMAudio na scenę, pod ciągłą ścieżką ACE-Step, która ścisza się pod efektami. Jedna niespodzianka: limiter w ffmpeg domyślnie podnosi poziom. Dopiero z
level=disabledszczyty zostały poniżej 0 dBFS; wcześniejsze miksy były o około 2 dB za głośne.
Wniosek: chmura wciąż dostarcza ruch, ale część lokalna urosła z montażu do naprawy. Twarze, błędy kamery i dźwięk naprawiam teraz w domu, zamiast płacić za nowy klip.
🧾 Rachunek
- Chmura: miesięczna subskrypcja plus kredyty – prawie wszystko na garść 4-sekundowych klipów i kilka edycji obrazów.
- Lokalnie: brak bieżących kosztów, ale czas GPU – upscaling całego filmu trwa około 45 minut.
- Czas: największa pozycja. Większość wersji poszła na timing, dźwięk i szczegóły, a nie na nowe sceny.
Wniosek: pieniądze siedzą w kilku klipach z chmury, czas w wielu lokalnych iteracjach.
🎯 Lekcje
- Chmura do ludzi, lokalnie wszystko inne – homelab z 8 GB nie potrafi dziś zrobić realistycznych ludzi w ruchu.
- Potwierdzaj koszt przed każdym zadaniem w chmurze – wysłane to wysłane.
- Zapisuj każdą wersję pod nową nazwą – nie raz starsza okazywała się lepsza.
- Używaj narzędzi AI selektywnie – czasem klasyczna metoda jest uczciwsza niż model.
- Oglądaj i słuchaj sam – pomiary pokazują, czy coś jest poprawne, a nie czy działa.
- Naprawiaj lokalnie, zanim wygenerujesz od nowa – face swap czy cięcie nic nie kosztują, nowy 10-sekundowy klip kosztuje 250 kredytów.