
Żona była szybsza niż mój monitoring: Zabbix w kontenerach pilnuje teraz mojej sieci domowej
Access point Wi-Fi przestał odpowiadać, a jedyną osobą, która to zauważyła, była moja żona. Od tamtej pory Zabbix 7.0 LTS działa rootless w kontenerach Podmana na moim domowym serwerze i wysyła maila, gdy jakieś urządzenie milknie. Konfiguracja, pułapki i gdzie co znaleźć w interfejsie.
🌐 Także w: English · Deutsch · Français · Español · Italiano · Português · Nederlands
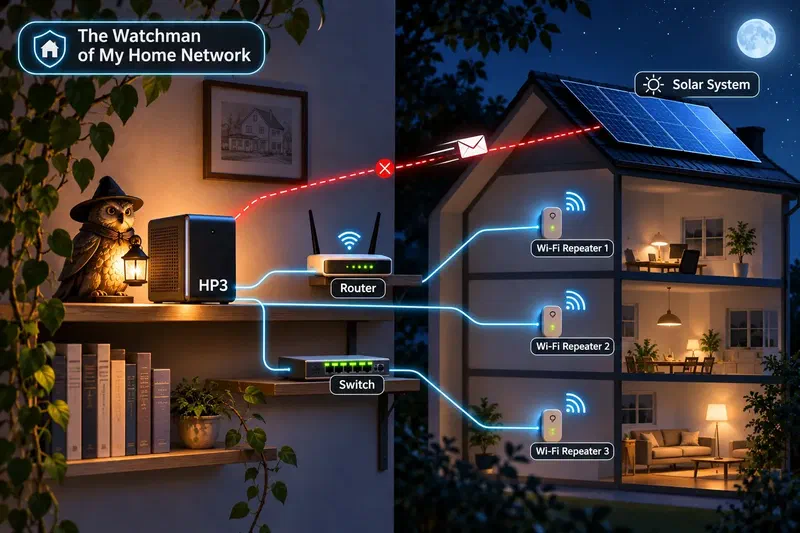
W skrócie: Nieco ponad dwa tygodnie temu moja żona wróciła do domu i nie miała Wi-Fi. Access point na parterze nie odpowiadał nawet na ping. Wyłączyć, włączyć – i od tamtej pory wszystko działa. Nikt poza nią tego nie zauważył, łącznie z moim monitoringiem. Teraz Zabbix 7.0 LTS działa w czterech rootless kontenerach Podmana na moim serwerze NAS i wysyła maila, gdy tylko jakiś element sieci domowej przestaje odpowiadać. Ten wpis opisuje konfigurację, co musiałem dodatkowo ustawić, gdzie się zacięło i gdzie co znaleźć w interfejsie webowym.
Spis treści
📶 Jak to się zaczęło
Żona wróciła do domu, telefon nie pokazywał Wi-Fi, a ona – co zrozumiałe – nie była zachwycona. Od razu to potwierdziłem: access point na parterze był nieosiągalny, ani przez interfejs webowy, ani pingiem. Wtyczka z gniazdka, kilka sekund czekania, wtyczka z powrotem. Od około 14 dni działa bez najmniejszej czkawki. Dlaczego padł, nadal nie wiem. To jedna z tych rzeczy, które zdarzają się raz i za nic nie chcą się powtórzyć.
Dużo bardziej przeszkadzało mi coś innego: dlaczego dowiedziałem się o tym od żony, a nie od monitoringu? Odpowiedź jest prosta. Prometheus i Grafana pilnują moich serwerów, a uptime check co pięć minut sprawdza z zewnątrz, czy blog i Nextcloud są osiągalne. Nikt nie patrzył na małe pudełka w sieci domowej – router, repeatery, switch, stację bazową telefonu, falownik fotowoltaiki. Nie mają agenta; można je tylko zapytać, czy odpowiadają.
Wniosek: Monitoring obejmuje dokładnie to, do czego go zbudowałeś. Luki to często niepozorne urządzenia, które po prostu działają – dopóki nie przestaną.
🔭 Czym jest Zabbix?
Zabbix to oprogramowanie open source do monitoringu: nieprzerwanie obserwuje serwery, urządzenia sieciowe, aplikacje i usługi. Alexei Vladishev zaczął go w 2001 roku jako narzędzie wewnętrzne, a wersja 1.0 ukazała się w 2004. Dziś rozwija go firma Zabbix SIA z Rygi na Łotwie. Oprogramowanie jest całkowicie darmowe – nie ma płatnej „enterprise edition" z ukrytymi funkcjami; firma zarabia na wsparciu, szkoleniach i certyfikacji. Do wersji 6.4 Zabbix był na licencji GPLv2, od 7.0 na AGPLv3. Co półtora roku wychodzi wydanie LTS, utrzymywane przez pięć lat.
Z czego Zabbix jest znany:
- Wszystko w jednym. Zbieranie danych, przechowywanie, reguły alertów, powiadomienia, dashboardy, mapy i raporty to jeden produkt z jednym interfejsem webowym. Z Prometheusem i Grafaną to kilka narzędzi, które składasz sam.
- Z agentem i bez. Agent Zabbixa (dziś zwykle Agent 2, napisany w Go i rozszerzalny wtyczkami) mierzy systemy operacyjne i aplikacje od środka. Dla urządzeń, na których nic nie da się zainstalować, są sprawdzenia bezagentowe: ping, porty TCP, HTTP, SNMP, IPMI, SSH i więcej.
- Sieci i SNMP. Zabbix jest szczególnie popularny przy switchach, routerach, firewallach, UPS-ach i drukarkach. Istnieją gotowe szablony dla niezliczonych urządzeń.
- Szablony i automatyczne wykrywanie. Szablon łączy sprawdzenia, alerty i wykresy. Dzięki low-level discovery Zabbix sam ustala, jakie systemy plików, karty sieciowe czy dyski ma urządzenie, i tworzy pasujące sprawdzenia.
- Duże środowiska. Proxy rozkładają monitoring na wiele lokalizacji; Zabbix jest zbudowany z myślą o dziesiątkach tysięcy urządzeń.
- Kompletne API. Wszystko, co potrafi interfejs, działa też przez JSON-RPC – całą konfigurację do tego wpisu zrobiłem skryptem korzystającym z API.
Gdzie spotkasz Zabbixa: u dostawców internetu i operatorów telekomunikacyjnych, w centrach danych, w bankach, urzędach i na uczelniach, w wielu działach IT średnich firm – wszędzie tam, gdzie mieszany krajobraz serwerów, sprzętu sieciowego i urządzeń specjalnych trzeba pilnować z jednego miejsca.
Druga strona medalu: Zabbix jest potężny i interfejs to pokazuje. Konfiguracja siedzi w bazie danych, a nie w plikach tekstowych, co utrudnia „configuration as code" w porównaniu z Prometheusem. A słownictwo – host, item, trigger, template, action – musi się raz utrwalić, zanim wszystko nabierze sensu.
Swoją drogą: zaraz po instalacji mapa na dashboardzie pokazywała Rygę – tam Zabbix ma siedzibę.
Wniosek: Zabbix to szwajcarski scyzoryk wśród narzędzi do monitoringu. Swoje mocne strony pokazuje zwłaszcza przy wielu różnych urządzeniach bez własnego agenta.
🎯 Cel i dlaczego Zabbix
Wymaganie było celowo skromne: mail, gdy wewnętrzny element przestaje odpowiadać. Dla urządzeń bez agenta oznacza to ping tam, gdzie urządzenie odpowiada na pingi, oraz test połączenia TCP na porcie takim jak 80 czy 443 tam, gdzie ma interfejs webowy.
Doszło drugie życzenie: chcę też wiedzieć, kiedy padnie sam internet – i dostać wtedy jednego maila „internet nieosiągalny" zamiast pięciu osobnych alertów, po jednym dla każdego zewnętrznego serwera.
Mały skrypt też by to załatwił. Mimo to wybrałem Zabbixa, z dwóch powodów. Po pierwsze, Zabbix ma dokładnie te sprawdzenia bezagentowe od ręki, do tego historię, wykresy, zależności między alertami i wysyłkę maili. Po drugie, z zawodowej ciekawości chcę zdobyć więcej praktycznego doświadczenia z Zabbixem – samemu zbudować, samemu skonfigurować, samemu wyłożyć się jak długi, zamiast tylko o tym czytać. Sieć domowa to idealny poligon: dość prawdziwa, żeby miało to sens, dość mała, żeby błąd nie bolał.
Wybrałem Zabbix 7.0 LTS (7.0.32). Wersja 8.0.0 właśnie wyszła, ale nie muszę być pierwszy w kolejce do wydania „zero", kiedy jednocześnie uczę się narzędzia.
Wniosek: Kiedy uczysz się nowego narzędzia, prawdziwy mały problem jest lepszy niż demo. A wydanie LTS usuwa jedną niewiadomą z równania.
🧱 Konfiguracja: cztery kontenery, bez roota
Zabbix działa na HP3, moim serwerze NAS z Debianem i ZFS. I tak jest włączony całą dobę i ma spory zapas (4 rdzenie, 32 GB RAM, z czego ponad jedna trzecia wolna). Całość składa się z czterech kontenerów:
| Kontener | Zadanie | Limit pamięci |
|---|---|---|
| PostgreSQL 17 | konfiguracja, pomiary, historia | 1 GB |
| zabbix-server | wykonuje sprawdzenia, ocenia je, wysyła maile | 768 MB |
| zabbix-web | interfejs webowy (nginx + PHP) na porcie 8080 | 512 MB |
| zabbix-agent2 | mierzy sam HP3: CPU, RAM, dyski, sieć | 256 MB |
Kluczowe decyzje za tym stojące:
- Rootless Podman zamiast Dockera jako root. Wszystko działa na moim zwykłym użytkowniku, więc błąd w kontenerze nie ląduje na NAS-ie jako root.
- Quadlet zamiast Compose. Każdy kontener to mały plik
.containerw~/.config/containers/systemd/. Podman zamienia je w zwykłe usługi systemd – z zależnościami, restartem po awarii i startem przy bootowaniu. Żeby usługi użytkownika startowały bez logowania, trzeba raz wykonaćloginctl enable-linger. - Sieć hosta zamiast NAT. Z
Network=hostpingi i testy TCP idą prosto do sieci domowej, bez translacji adresów Podmana po drodze. PostgreSQL z kolei nasłuchuje jawnie tylko na127.0.0.1. - Stałe limity pamięci i CPU, żeby Zabbix nigdy nie przeszkadzał NAS-owi. W praktyce wszystkie cztery kontenery razem zużywają około 180 MB.
- Żadnych haseł w plikach. Hasło do bazy to Podman secret przekazywany kontenerom jako plik, a hasło admina interfejsu webowego zmieniłem przez API zaraz po pierwszym starcie.
To jest plik dla serwera:
[Unit]
Description=Zabbix server
Requires=zabbix-db.service
After=zabbix-db.service

[Container]
ContainerName=zabbix-server
Image=docker.io/zabbix/zabbix-server-pgsql:alpine-7.0.32
Network=host
Environment=DB_SERVER_HOST=127.0.0.1 POSTGRES_USER=zabbix POSTGRES_DB=zabbix
Environment=POSTGRES_PASSWORD_FILE=/run/secrets/zabbix-db-pw
Secret=zabbix-db-pw
AddCapability=NET_RAW
PodmanArgs=--memory=768m --cpus=1

[Service]
Restart=always

[Install]
WantedBy=default.target
Wniosek: Quadlet zamienia kontenery w zwykłe usługi systemd. Nie potrzebujesz orkiestratora kontenerów, a systemctl --user status pokazuje wszystko w jednym miejscu.
💾 Gdzie trafia baza danych?
Oczywistym pytaniem było, czy baza należy na systemowy SSD, czy do puli ZFS, która właściwie jest przeznaczona na udziały plikowe. Wybrałem pulę. HP3 ma wyłącznie SSD, także trzy dyski w RAIDZ1 – więc szybkość nie jest argumentem przeciwko puli. W zamian baza przeżyje tam utratę jednego dysku, ZFS wykrywa uszkodzone bloki dzięki sumom kontrolnym, a katalog leży w moim datasecie domowym, który komputer backupowy i tak kopiuje w nocy. Systemowy SSD ma ponad 400 GB wolnego miejsca, ale to pojedynczy dysk i nie jest objęty backupem.
Ilości danych są skromne: po pierwszym dniu baza ma poniżej 100 MB. Osobny dataset ZFS z rozmiarem bloku dostrojonym pod PostgreSQL byłby czystszy, ale wymaga roota – przy tej skali nie warto.
Wniosek: Najszybszy dysk nie jest automatycznie właściwy. Dla bazy danych redundancja i backup liczą się bardziej niż ostatnie kilka procent wydajności.
📡 Co jest monitorowane
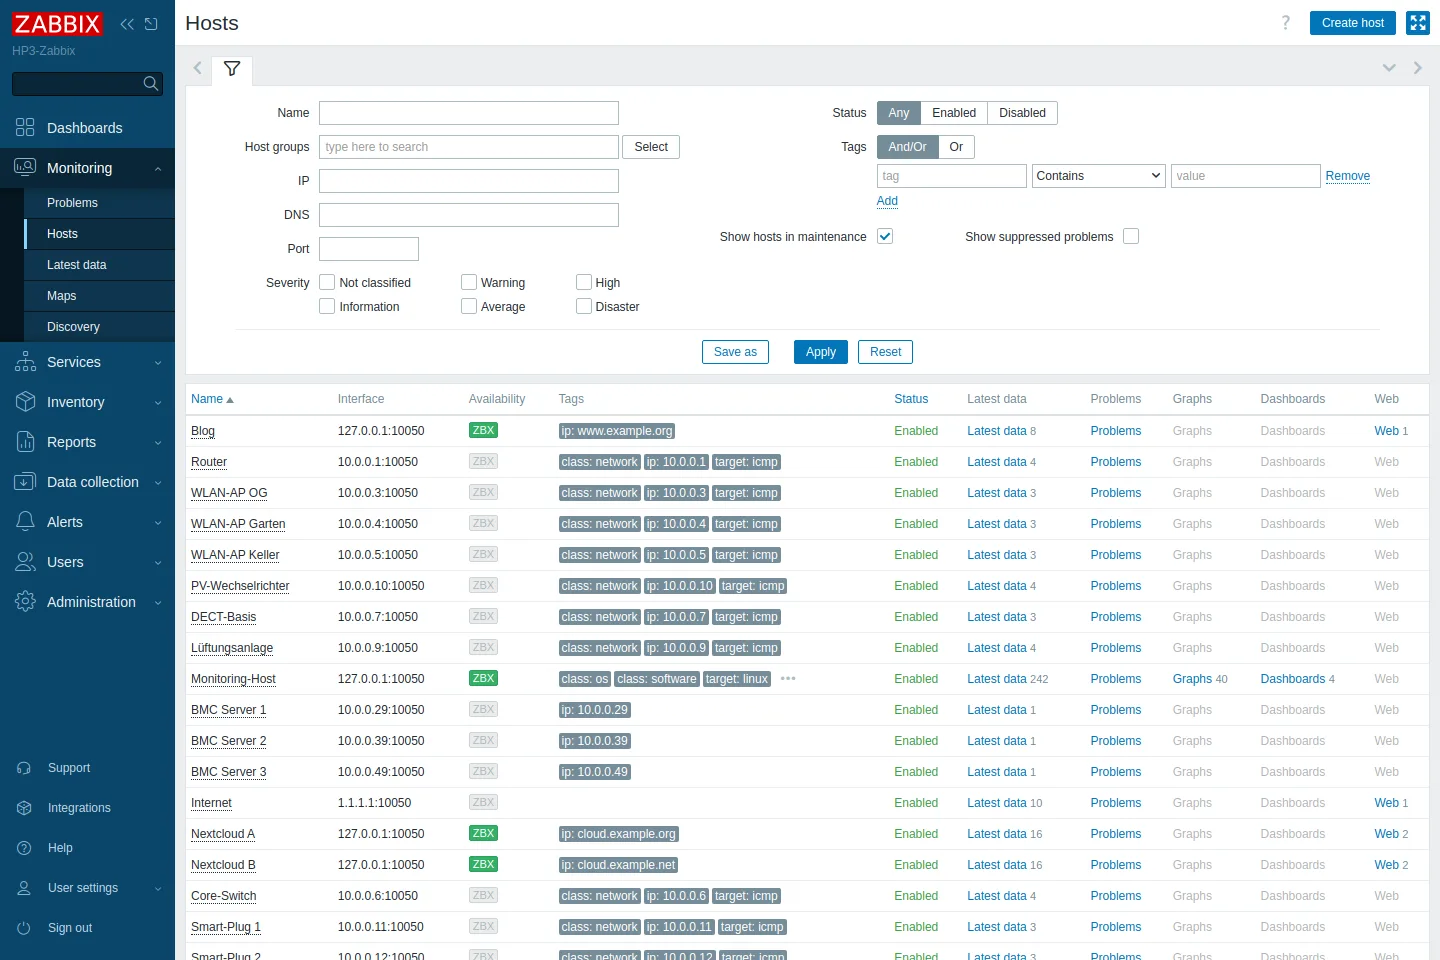
W Zabbiksie sieć jest podzielona na dwie grupy hostów: LAN dla urządzeń w domu i External dla moich serwerów w centrum danych.
W LAN Zabbix co minutę sprawdza:
- Ping do routera, trzech repeaterów Wi-Fi, switcha, stacji bazowej telefonu, systemu wentylacji, falownika i dwóch inteligentnych gniazdek. Zabbix ma do tego szablon ICMP Ping. Oznacza urządzenie jako niedostępne, gdy trzy pingi z rzędu zostaną bez odpowiedzi – czyli po mniej więcej trzech minutach. Pojedynczy zgubiony ping nie wywołuje alarmu.
- Dodatkowo port TCP wszędzie tam, gdzie działa interfejs webowy: 443 na routerze i switchu, 80 na wentylacji i falowniku. Klucz to
net.tcp.service[tcp,<ip>,<port>], a i ten alert odpala dopiero po trzech nieudanych próbach. - Tylko TCP 443 dla kontrolerów zdalnego zarządzania (BMC) trzech serwerów. Siedzą w tej samej sieci, ale liczy się to, czy odpowiada ich interfejs.
Szczegół, którego bez Zabbixa bym nie miał: alert portu zależy od alertu pingu. Jeśli urządzenie padnie całkowicie, dostaję jednego maila („unavailable by ICMP ping"), nie dwa. Alert portu odzywa się dopiero wtedy, gdy urządzenie odpowiada na ping, a jego interfejs webowy nie.
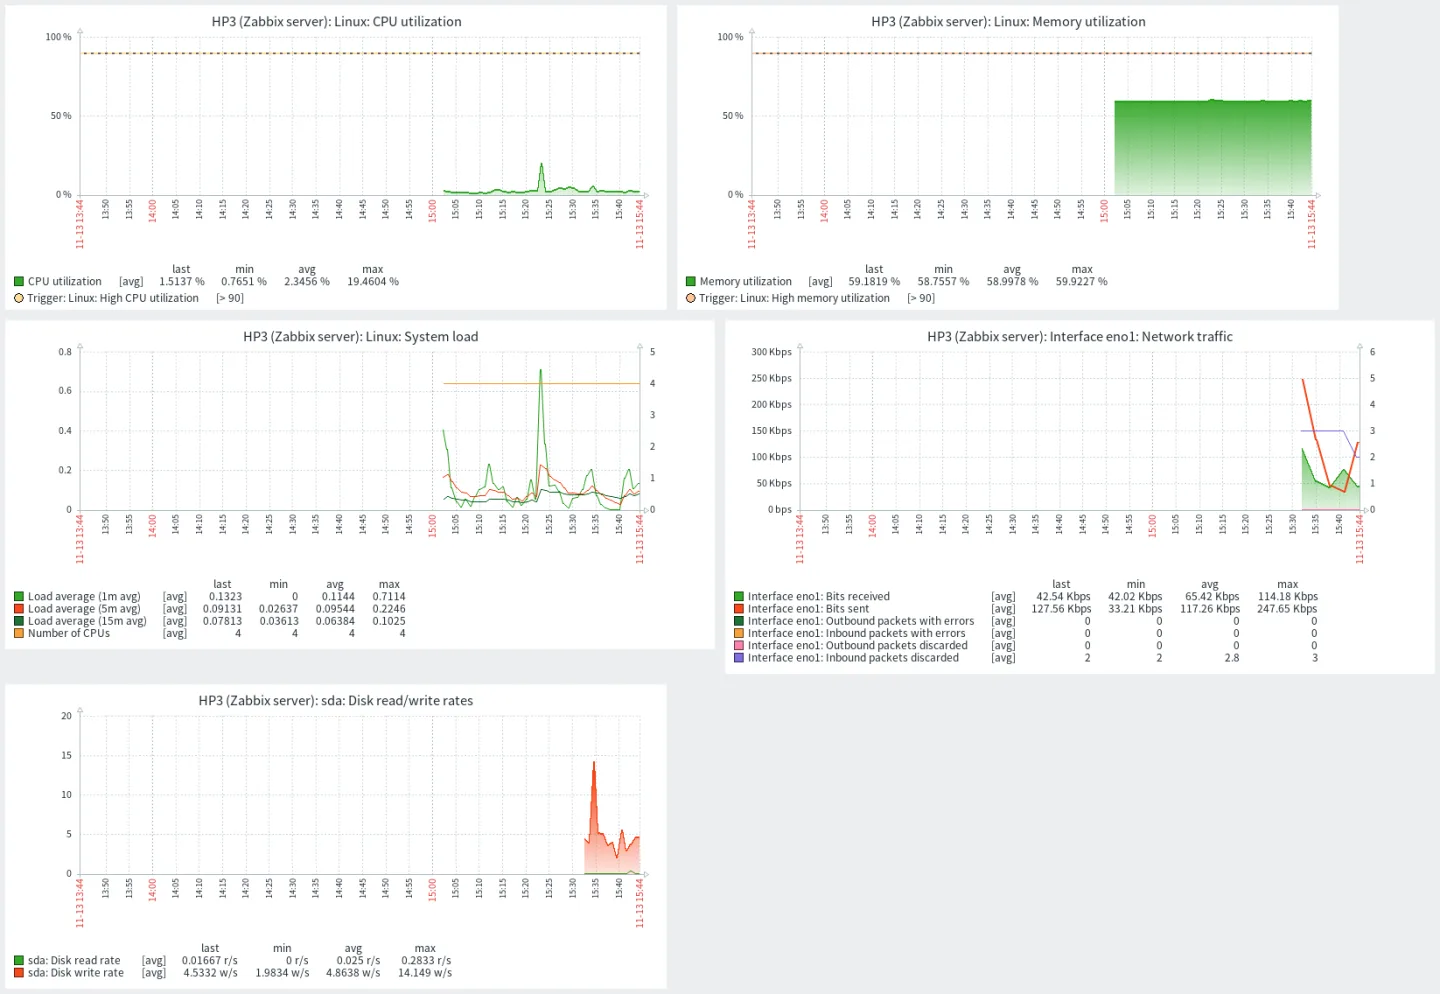
Sam HP3 mierzy Agent 2: CPU, RAM, load, swap, procesy, każdą kartę sieciową, datasety ZFS i I/O czterech SSD. Szablon Linux by Zabbix agent obejmuje to wszystko, a Zabbix sam tworzy wykresy.
Zewnętrzne serwery – blog i dwie instancje Nextcloud – są sprawdzane przez web scenarios: jedno zapytanie co dwie minuty, z oczekiwanym HTTP 200 i konkretnym fragmentem treści. Dla bloga to koniec strony głównej, dla Nextcloud status.php musi zawierać "maintenance":false, dla Collabory musi odpowiedzieć WOPI discovery. Do tego agent co sześć godzin odczytuje certyfikaty TLS i ostrzega 14 dni przed ich wygaśnięciem.
Sam internet sprawdza osobny host o nazwie „Internet": co minutę pinguje dwa niezależne publiczne serwery DNS (1.1.1.1 i 9.9.9.9) i pobiera https://www.google.com/generate_204, adres przeznaczony dokładnie do takich testów łączności, który zwraca tylko „204 No Content". Alert „internet nieosiągalny" odpala dopiero wtedy, gdy oba serwery milczą trzy razy z rzędu – czkawka u jednego dostawcy to nie awaria internetu. Alerty zewnętrznych serwerów od niego zależą: jeśli internet leży, przychodzi dokładnie jeden mail.
Czego na tych serwerach celowo nie sprawdzam, to SSH ani otwarte porty. Gołe połączenie z portem 22 bez logowania trafia do logu sshd, a fail2ban może z tego zrobić bana na mój własny domowy IP. Szybki test kilku portów uruchomiłby blokadę skanowania portów w firewallu. Za to jedno zapytanie HTTPS co dwie minuty to zupełnie normalny odwiedzający.
Wniosek: Dobre alerty są oszczędne. Trzy nieudane próby zamiast jednej i zależności między alertami sprawiają, że mail naprawdę coś znaczy.
🐛 Pułapki
Nie ma konfiguracji bez niespodzianek. Te były najbardziej pouczające:
- Na początku ping w ogóle nie działał. Każde sprawdzenie pingu kończyło się
sh: /usr/sbin/fping: Operation not permitted. W obrazie serwerafpingma file capabilitycap_net_raw=ep. Jeśli kontenerowi brakuje tej capability, jądro odmawia nawet uruchomienia programu – nie tylko pingu. Poprawka to jedna linia:AddCapability=NET_RAWw pliku Quadlet serwera. - Wykrzyknik w nazwie hosta. Zabbix odrzuca „FRITZ!Box" jako nazwę hosta. Nazwa techniczna dopuszcza tylko litery, cyfry, spacje, kropki, podkreślenia i myślniki. Dlatego Zabbix oddziela nazwę techniczną od visible name – tę drugą widzisz wszędzie.
- „Wolny" IP wcale nie był wolny. Do testu maili chciałem zasymulować awarię i skierowałem urządzenie testowe na adres, który nie odpowiedział podczas mojego skanu pingiem. Zabbix zgłosił wtedy 66 % utraty pakietów – jednak coś tam było, tylko odpowiadało niestabilnie. Do testów używam teraz adresu z zakresu dokumentacyjnego (192.0.2.1, RFC 5737), który gwarantowanie nigdy nie odpowie.
- Świeża instalacja Zabbixa nie wysyła maili. Action zgłaszająca problemy administratorom jest domyślnie wyłączona, a użytkownik admin nie ma adresu mailowego. Bez tych dwóch kroków wszystko świeci na zielono, a i tak żaden alert nie dochodzi.
- Agent w kontenerze nie widzi hosta automatycznie. Statystyki CPU, RAM, sieci i dysków i tak pochodzą z jądra hosta. Dla systemów plików zamontowałem korzeń hosta tylko do odczytu pod
/hostfsi makrem dopuściłem wyłącznie prawdziwe systemy plików; inaczej pojawiają się wewnętrzne overlay mounty Podmana. Dyski agent znalazł dopiero wtedy, gdy pliki urządzeń od/dev/sdado/dev/sddbyły widoczne w kontenerze – choć i tak czyta tylko/proc/diskstats. - Strefa czasowa i format godziny. Interfejs był ustawiony na UTC i pokazywał „03:26 PM". W Administration → General → GUI ustawiłem Europe/Berlin i format 24-godzinny.
Wniosek: Żaden z problemów nie tkwił w samym Zabbiksie. Siedziały na szwach: kontener i jądro, dane testowe i rzeczywistość, ustawienia domyślne i oczekiwania.
✉️ Test: zainscenizowana awaria
Konfiguracja maili jest udowodniona dopiero, gdy mail dojdzie. Zabbix używa tego samego konta SMTP, którego HP3 już używa do swoich maili statusowych (port 587, STARTTLS). Do testu skierowałem urządzenie na adres dokumentacyjny i czekałem:
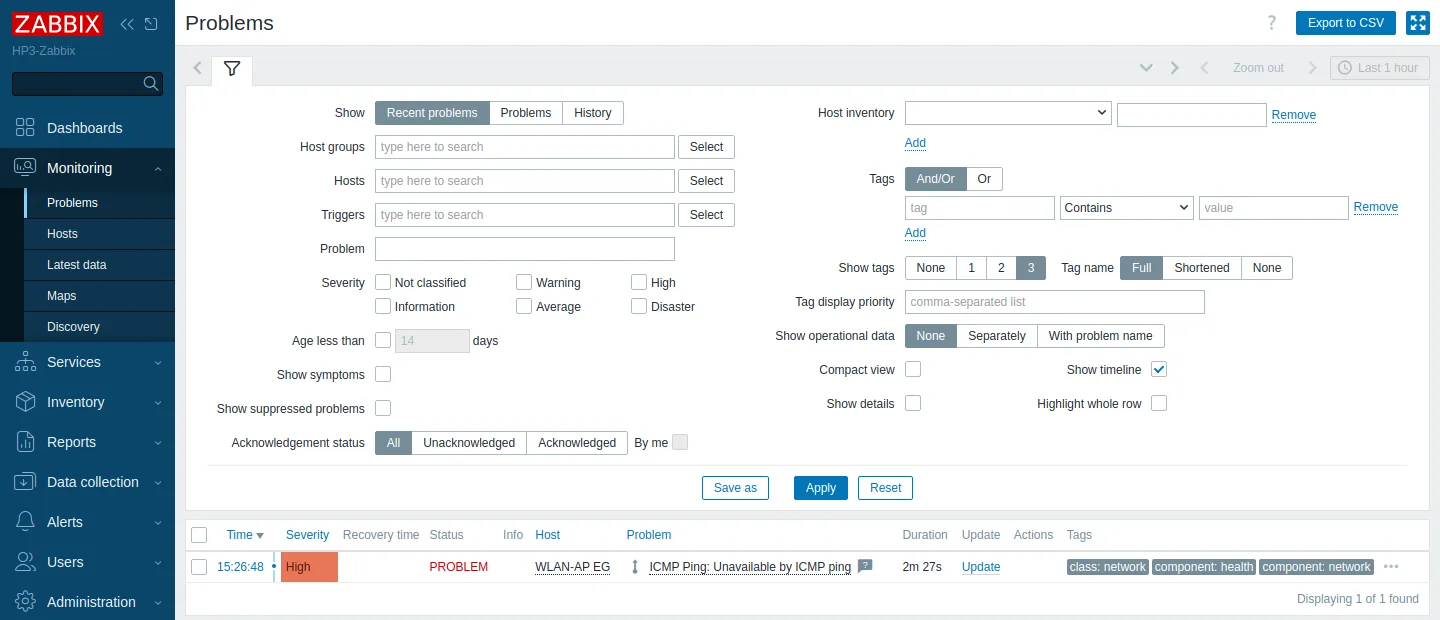
- Po około trzech minutach przyszedł mail „Problem: ICMP Ping: Unavailable by ICMP ping".
- Gdy skierowałem adres z powrotem na prawdziwe urządzenie, przyszło „Resolved in 1m 0s".
Urządzenie testowe potem usunąłem. Do zrzutów ekranu w tym wpisie zainscenizowałem awarię jeszcze raz, z wyłączonymi powiadomieniami – dlatego niedziałający access point nazywa się na obrazkach „WLAN-AP EG" (parter).
Wniosek: Alert, którego nigdy nie przetestowano, to założenie. Celowo wywołana awaria kosztuje pięć minut i dowodzi działania całego łańcucha od pingu do skrzynki odbiorczej.
🧭 Wycieczka po interfejsie
Na początku Zabbix przytłacza: nawigacja ma dobry tuzin głównych pozycji z wieloma podstronami. Na co dzień w sieci domowej potrzebujesz jednak tylko kilku miejsc. Ta tabela to moja apteczka – pod nią każda pozycja wyjaśnia, co tam znajdziesz.
| Chcę … | Menu w Zabbix 7.0 |
|---|---|
| zobaczyć na jeden rzut oka, czy wszystko działa | Dashboards → Global view |
| wiedzieć, co jest teraz zepsute, i potwierdzić problem | Monitoring → Problems (przycisk Update) |
| zobaczyć, kiedy coś padło w przeszłości | Monitoring → Problems, filtr History |
| sprawdzić stan konkretnego urządzenia | Monitoring → Hosts, potem Latest data lub Graphs |
| zobaczyć najnowsze wartości wszystkich urządzeń | Monitoring → Latest data |
| sprawdzić, czy blog i Nextcloud odpowiadają | Monitoring → Hosts, kolumna Web |
| dodać nowe urządzenie | Data collection → Hosts → Create host |
| dodać sprawdzenie portu do urządzenia | Data collection → Hosts → urządzenie → Items i Triggers |
| wpisać planowaną przerwę (bez maili) | Data collection → Maintenance |
| przejrzeć gotowe pakiety sprawdzeń | Data collection → Templates |
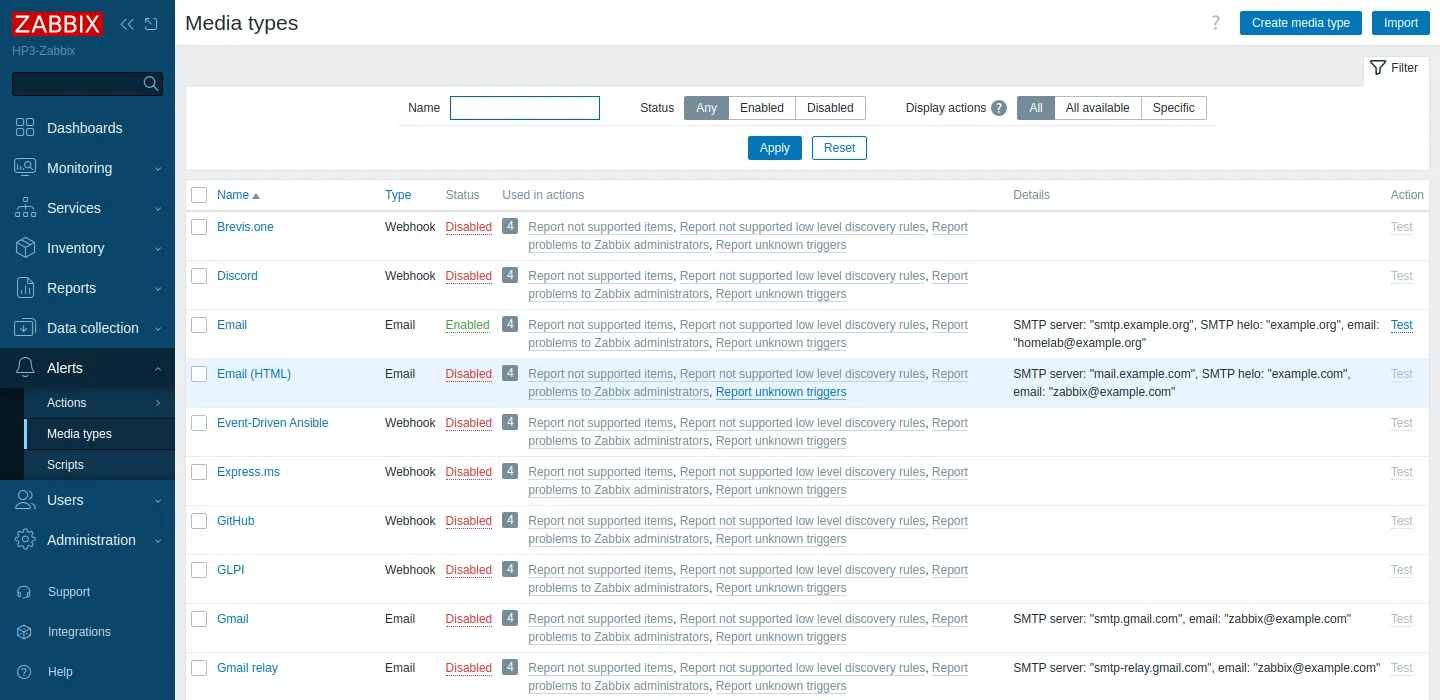
| skonfigurować serwer pocztowy i wysłać mail testowy | Alerts → Media types → Email (link Test) |
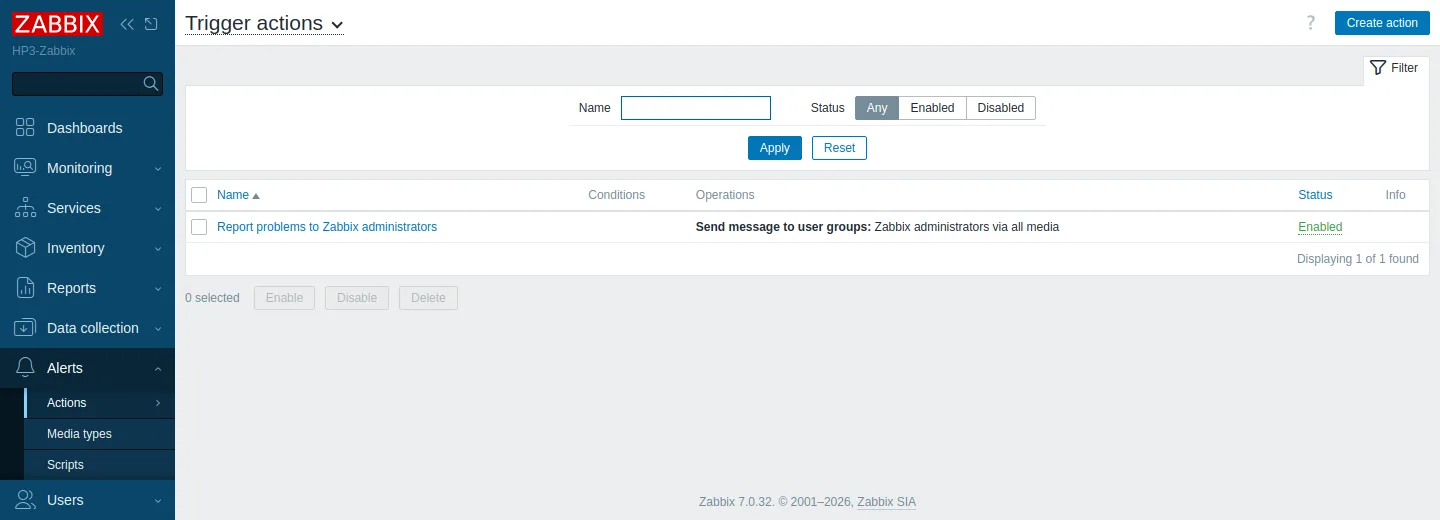
| zdecydować, kto dostaje powiadomienie o problemie | Alerts → Actions → Trigger actions |
| wpisać własny adres mailowy | Users → Users → Admin → Media |
| zobaczyć, jakie maile zostały wysłane | Reports → Action log |
| zmienić strefę czasową i język | Administration → General → GUI |
| zmienić własne hasło | User settings → Profile |
Dashboards → Global view: przegląd
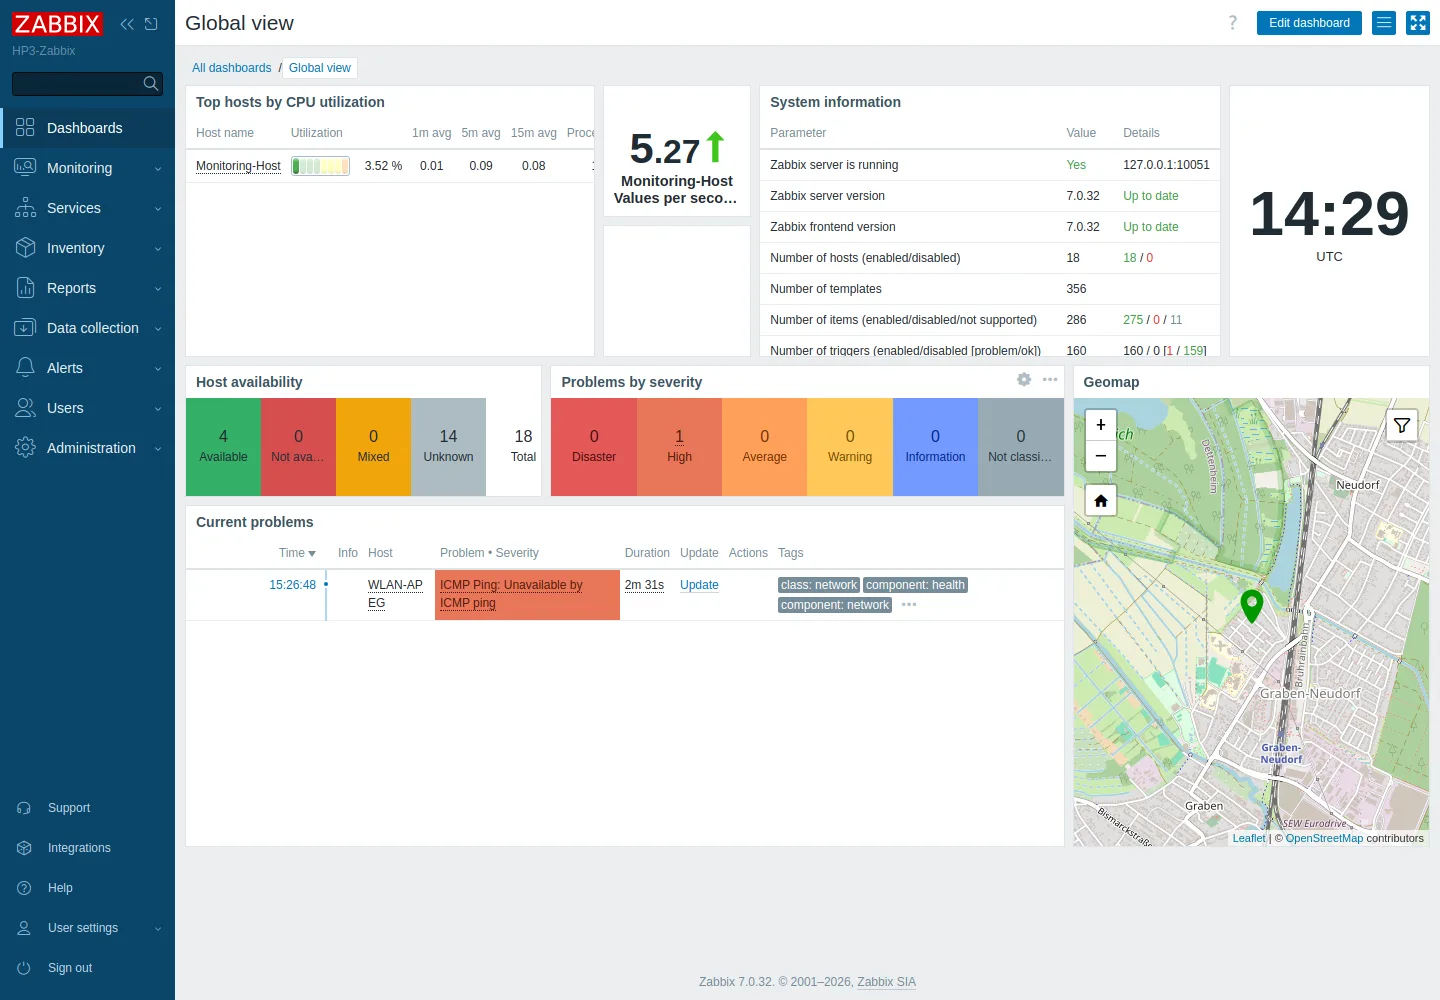
Strona startowa pokazuje dostępność wszystkich hostów, problemy według severity, bieżące problemy i mapę. Kafelek „Host availability" na początku myli: urządzenia bez agenta pojawiają się na szaro jako „Unknown". To nie błąd – po prostu nie mają agenta; ich stan jest w sprawdzeniach pingu i portów. Mapa (Geomap) umieszcza urządzenia w lokalizacji zapisanej w ich inwentarzu; wpisałem miasto, a nie dokładny adres.
Monitoring → Problems: co jest teraz zepsute
To najważniejsza strona. Każdy otwarty problem jest tu wymieniony z początkiem, czasem trwania i severity. Przyciskiem Update potwierdzasz problem („zajmuję się tym") i zostawiasz komentarz. Filtr History pokazuje też rozwiązane problemy – przydatne, żeby później sprawdzić, kiedy access point ostatnio zniknął.
Monitoring → Hosts i Latest data: stan każdego urządzenia
Monitoring → Hosts (obrazek wyżej, w „Co jest monitorowane") wymienia każde urządzenie z linkami do najnowszych wartości, problemów, wykresów i web scenarios. Latest data pokazuje surowe wartości: czy ostatni ping wrócił, ile trwał, czy port był otwarty. Każda wartość prowadzi do wykresu.
Monitoring → Hosts → Web: zewnętrzne serwery
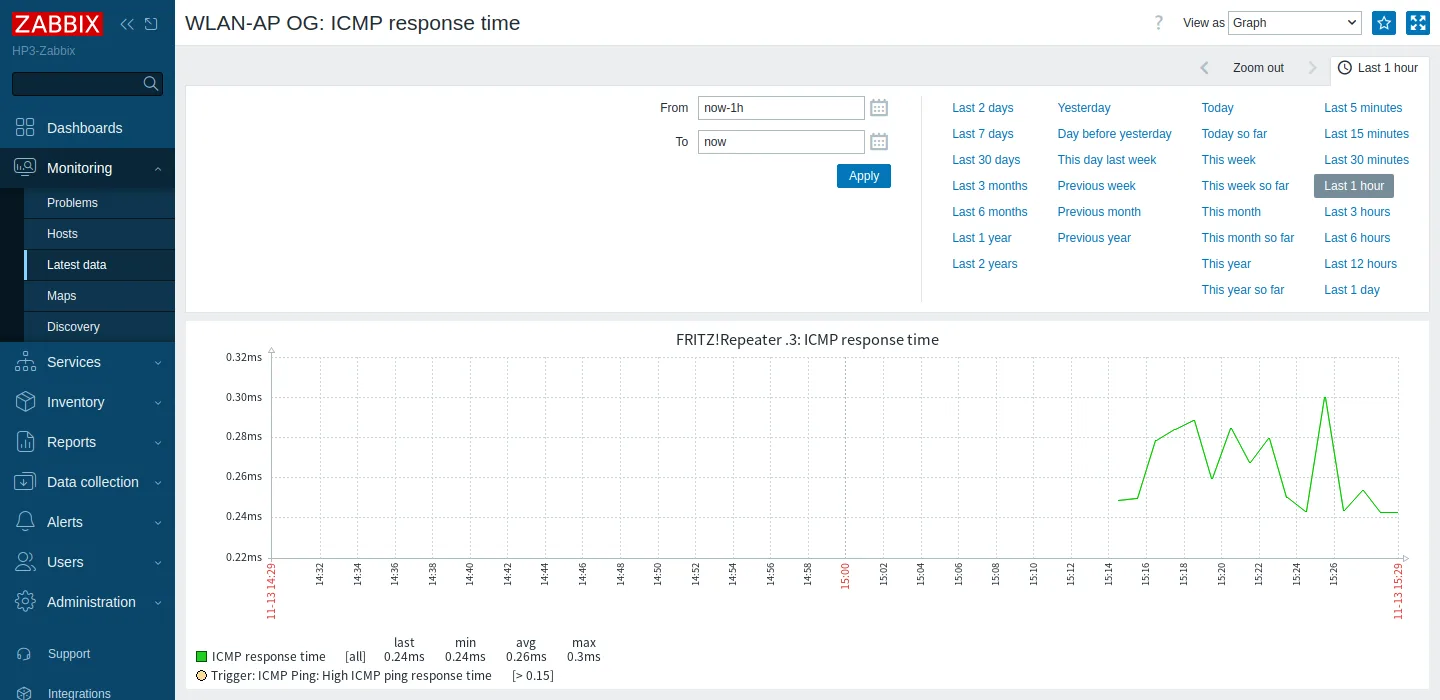
Zabbix 7.0 nie ma do tego osobnej pozycji w menu: w Monitoring → Hosts kliknij link Web obok urządzenia. Tam są web scenarios dla bloga, Nextcloud i Collabory, z czasem i wynikiem ostatniego uruchomienia. Kliknięcie nazwy pokazuje czas odpowiedzi i szybkość pobierania w czasie. Jeśli scenariusz zawiedzie, mówi, który krok padł i z jakim błędem.
Data collection → Hosts: dodawanie nowego urządzenia
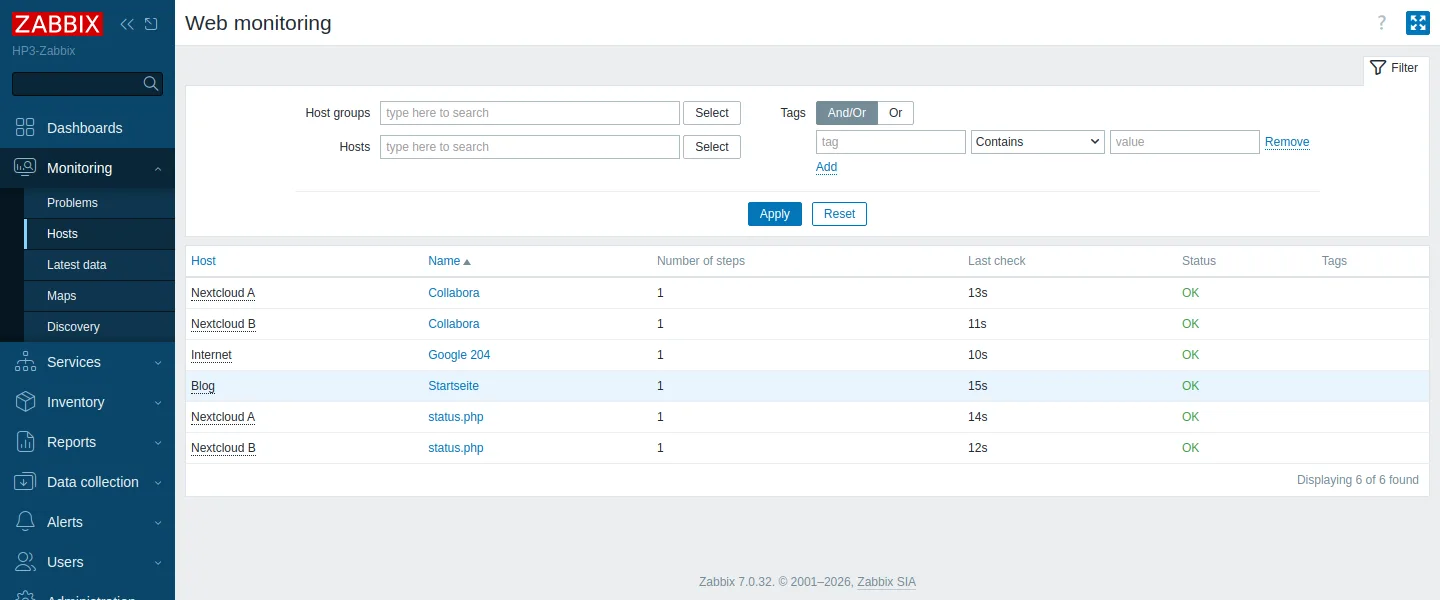
Nowe urządzenia dodaje się w Data collection → Hosts → Create host. Dla urządzenia, które potrzebuje tylko sprawdzenia pingu, wystarczy pięć pól:
- Host name – nazwa techniczna, tylko proste znaki.
- Visible name – nazwa wyświetlana wszędzie.
- Templates – wybierz ICMP Ping.
- Host groups – na przykład LAN.
- Interfaces – jeden interfejs z adresem IP urządzenia. Typ nie ma znaczenia dla pingu; Zabbix bierze adres z interfejsu.
Zapisz, gotowe – pierwsze wartości przychodzą w ciągu minuty. Żeby sprawdzać też port, dodaj w Items hosta item typu Simple check z kluczem net.tcp.service[tcp,,443], a w Triggers alert w rodzaju max(/<host>/net.tcp.service[tcp,,443],#3)=0.
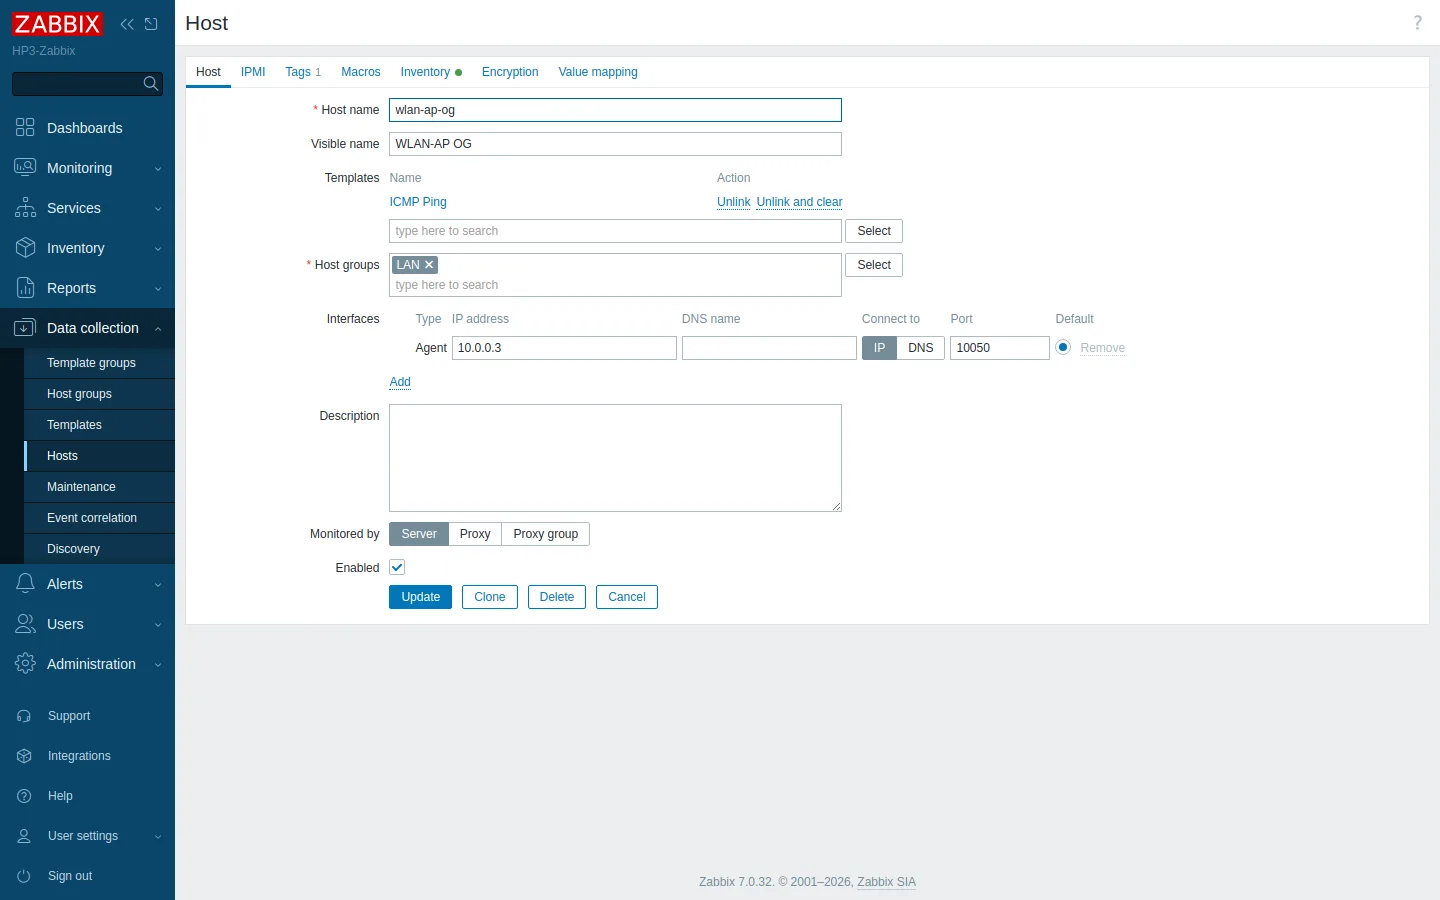
Tuż obok jest Data collection → Maintenance. Tam wpisujesz okresy, w których urządzenia są celowo wyłączone – na przykład komputer backupowy, który działa tylko od czasu do czasu. W tych okresach nie są wysyłane żadne maile.
Alerts → Media types i Actions: żeby mail doszedł
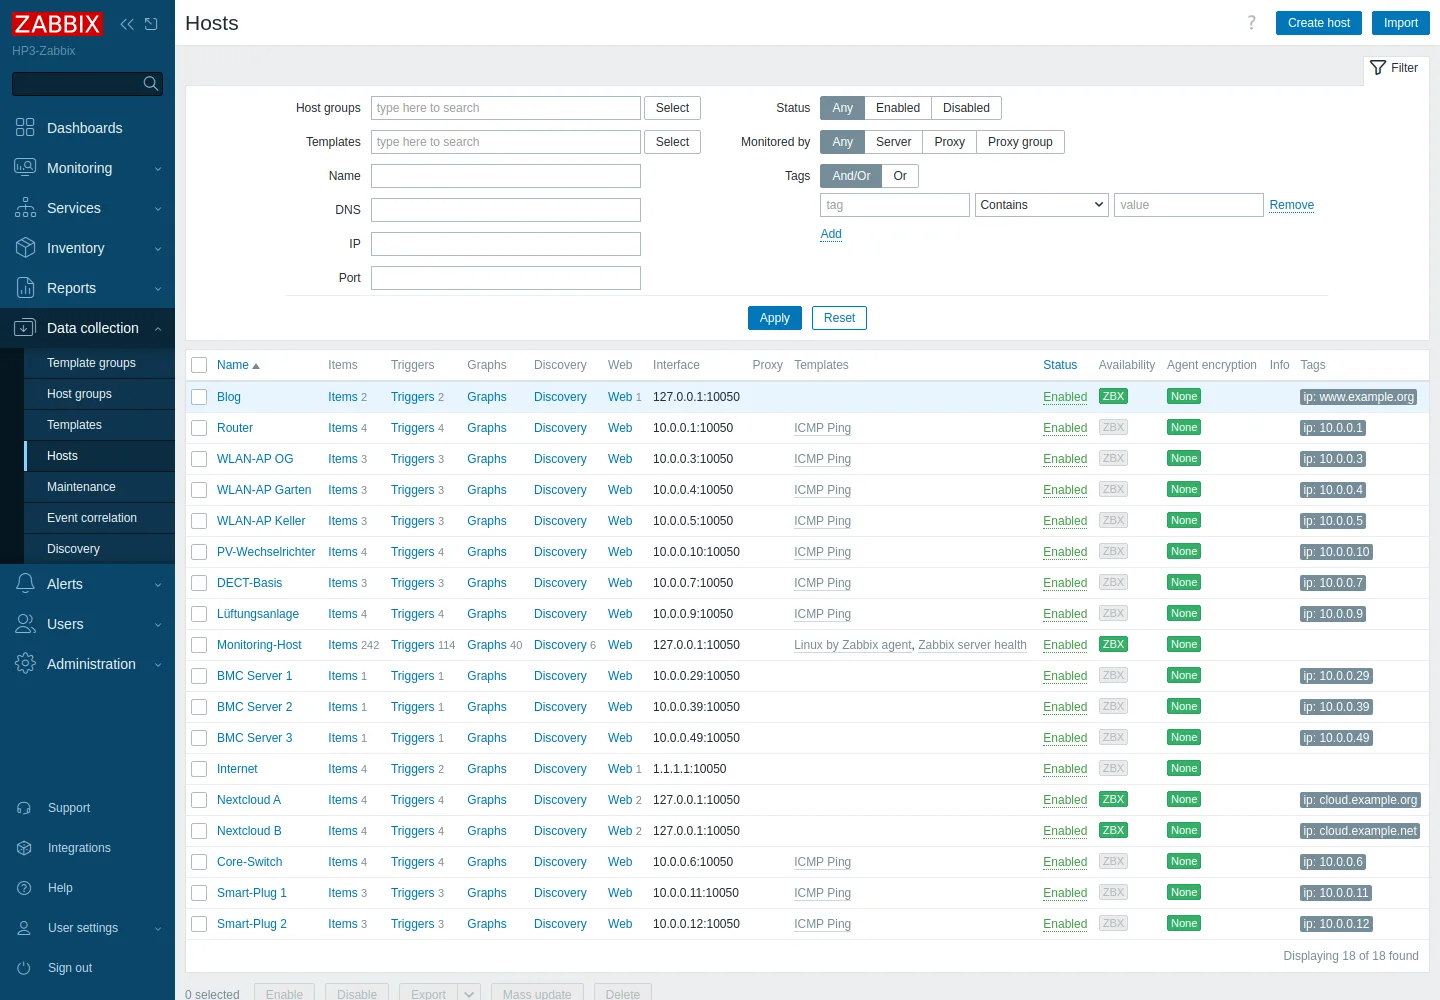
Dwa miejsca decydują, czy mail w ogóle zostanie wysłany:
- Alerts → Media types → Email: serwer SMTP, port, szyfrowanie, nadawca i dane logowania. Link Test wysyła stąd mail testowy.
- Alerts → Actions → Trigger actions: istniejąca action Report problems to Zabbix administrators musi mieć status Enabled. Określa, kto dostaje powiadomienie o problemie i o jego ustąpieniu.
Potem odbiorca: wpisz własny adres w Users → Users → Admin → Media.
Sam HP3: wykresy jak w Grafanie
Dla HP3 Zabbix sam zbudował wykresy z szablonu Linux: CPU, pamięć, load, sieć dla każdej karty, zajętość każdego datasetu ZFS i I/O dysków. Znajdziesz je w Monitoring → Hosts → Graphs albo na dashboardzie hosta, który Zabbix tworzy automatycznie.
Wniosek: Ze wszystkich pozycji menu na co dzień potrzebujesz czterech: Problems, Hosts, Latest data i Create host. Reszta to konfiguracja, którą robisz raz.
🔄 Co dalej
Niektóre sprawdzenia istnieją teraz podwójnie: mój dotychczasowy uptime check nadal testuje bloga i Nextcloud, a Zabbix też. To celowe. Oba działają równolegle przez kilka tygodni, potem zdecyduję, czy Zabbix zastąpi uptime check. Po stronie Zabbixa są historia i czasy odpowiedzi, po stronie uptime checka to, że jest malutki i prawie nic nie może się w nim zepsuć.
Równie ważne było dla mnie, żeby wszystko dało się z powrotem usunąć. Ponieważ całość działa rootless na moim użytkowniku, usunięcie oznacza zatrzymanie czterech usług, skasowanie czterech plików i jednego katalogu. Spisałem te kroki podczas konfiguracji.
Na razie Zabbix pyta większość urządzeń tylko o jedno: „Jesteś tam jeszcze?" W następnym wpisie ma zajrzeć do ich środka:
- FRITZ!Box i repeatery przez TR-064. Nie mówią po SNMP, ale ten interfejs podaje stan łącza internetowego, szybkość synchronizacji i liczbę klientów WLAN. To jest prawdziwy zysk: access point może odpowiadać na pingi, a mimo to przestać nadawać WLAN. „Ani jednego klienta przez trzy godziny" to alert, który naprawdę pomaga.
- Switch przez SNMP. Ze standardowym MIB (IF-MIB) Zabbix widzi stan, błędy i ruch każdego portu i zgłasza, gdy port padnie.
- Sprzęt serwerów przez iLO. Dla wentylatorów, temperatur, zasilaczy i dysków Zabbix ma gotowy szablon odpytujący Redfish (HTTP).
- Instalacja fotowoltaiczna. Falownik Fronius ma własny interfejs JSON, Solar API. Zabbix może go odpytywać bez dodatkowego oprogramowania i rysować z tego wykresy uzysków.
- Mniej maili podczas awarii. Jeśli dziś padnie switch, każde urządzenie za nim wyśle własnego maila. Dzięki zależnościom między alertami Zabbix wie, że wszystko wisi na switchu, i zgłasza tylko switch.
- Drugi kanał alertów, na przykład powiadomienie push na telefon (ntfy), na wypadek gdyby padła sama ścieżka mailowa. Do tego krótsze przechowywanie pomiarów i nocny backup bazy.
I szczerze mówiąc, mam nadzieję, że pierwszy prawdziwy mail od Zabbixa każe na siebie długo czekać.
Wniosek: Uruchomienie nowego narzędzia obok starego niewiele kosztuje i pokazuje, czy na co dzień jest lepsze. Spisanie od razu sposobu usunięcia zdejmuje ryzyko z próbowania.
🎯 Lekcje
- Monitoring widzi tylko to, do czego go zbudowałeś. Ciche luki to urządzenia bez agenta.
- Alert jest udowodniony dopiero wtedy, gdy celowo wywołana awaria wyląduje w skrzynce – łącznie z ustąpieniem.
- Sprawdzaj ustawienia domyślne: Zabbix nie ma domyślnie aktywnej action mailowej, a strefa czasowa to UTC.
- Przy kontenerach problemy często siedzą na granicy z jądrem: capabilities, pliki urządzeń, mounty.
- Do testów używaj adresów, które na pewno do nikogo nie należą – „nie odpowiedział podczas skanu" nie znaczy „wolny".
🔧 Uzupełnienie: mniej zapisów na SSD
Po publikacji pojawiło się pytanie, czy ciągłe małe zapisy szkodzą RAIDZ zbudowanemu z SSD. Zmierzyłem więc, co baza faktycznie zapisuje: około 750 transakcji na minutę, z czego dobre 110 wymuszało natychmiastowy zapis na dysk przez fsync – prawie dwa na sekundę. Każdy fsync nie pozwala ZFS zbierać zapisów w RAM-ie i zapisywać ich w paczkach, a w RAIDZ każdy mały blok ląduje na dyskach razem ze swoją parzystością.
W porównaniu z żywotnością SSD to nieszkodliwe: około 200 do 300 MB dziennie to nic dla dysków, z których każdy ma deklarowane około 1300 TB zapisów. Ponieważ serwer wisi na UPS-ie, i tak przestawiłem PostgreSQL na zapisy wsadowe – cztery opcje w pliku Quadlet bazy:
| Ustawienie | Efekt |
|---|---|
synchronous_commit=off | Commit nie czeka już na dysk; log transakcji jest zapisywany w tle |
wal_writer_delay=2000ms | Proces w tle zapisuje tylko co 2 sekundy zamiast co 200 ms |
checkpoint_timeout=15min | Checkpointy co 15 zamiast co 5 minut, mniej stron danych zapisywanych dwukrotnie |
wal_compression=lz4 | Log transakcji jest kompresowany |
Wynik, na minutę przy porównywalnym obciążeniu:
| przed | po | |
|---|---|---|
wymuszone zapisy (fsync) | 111 | 30 |
| log transakcji | ~80 KB | ~72 KB |
Cena: jeśli mimo UPS-a zabraknie prądu, może brakować pomiarów z ostatnich kilku sekund. Baza pozostaje spójna – przy synchronous_commit=off PostgreSQL traci tylko najnowsze transakcje, nigdy nie uszkadza starszych. Dla danych monitoringu to dobra wymiana.
Wniosek: Najpierw mierz, potem optymalizuj. Samo pierwsze ustawienie prawie nic nie dało; dopiero pomiar pokazał, że proces w tle nadal zapisywał każdą drobną zmianę osobno w rytmie 200 ms.
Zrzuty ekranu są zanonimizowane: nazwy urządzeń, adresy IP, domeny i adresy mailowe zostały przed ich zrobieniem zastąpione neutralnymi placeholderami, a awaria jest zainscenizowana.