Deep Dive: Hugo – co robi generator stron statycznych, co zastąpiło moje wtyczki WordPressa i jak działa wyszukiwanie bez serwera
Czym jest Hugo i czym różni się od WordPressa, co przejęło zadania Yoast, Polylang i wtyczek cache, jak działa pole wyszukiwania na stronie bez serwera, jak dodaję wpis i aktualizuję Hugo – i które pułapki wyszły dopiero w eksploatacji.
🌐 Także w: English · Deutsch · Français · Español · Italiano · Português · Nederlands
Deep Dive z serii wokół Ansible Tour. Tour objaśnia role, deep dive’y – technikę pod spodem: jak działa, dlaczego jest tu używana właśnie tak i co po drodze poszło nie tak.
Na początku listopada ten blog przeniósł się z WordPressa na Kubernetesie na Hugo. O eksperymencie z prawdziwymi liczbami i o samej przeprowadzce piszę gdzie indziej. Ten wpis to przegląd, który sam chciałbym mieć przed startem: czym właściwie jest Hugo, co przejęło zadania wtyczek WordPressa, jak działa pole wyszukiwania na stronie, która nie ma w ogóle kodu po stronie serwera, co robię, gdy dodaję wpis albo aktualizuję Hugo, i gdzie mnie zaskoczył.
Spis treści
🧭 Czym jest Hugo
Drukarnia zamiast kuchni
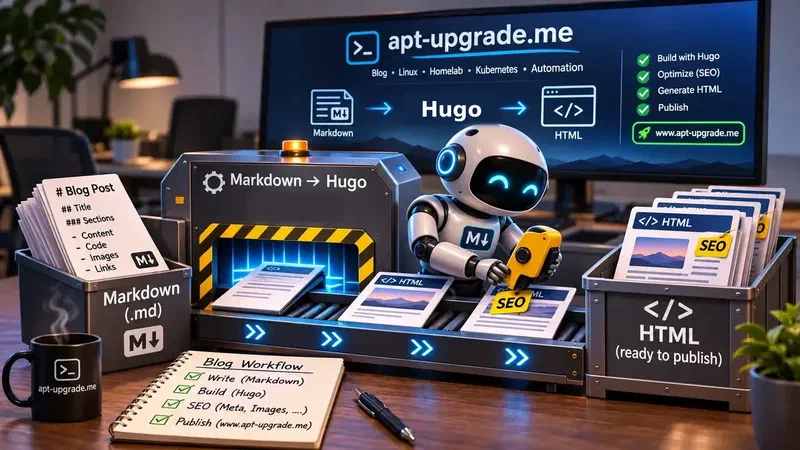
WordPress działa jak kuchnia w restauracji: za każdym razem, gdy gość coś zamawia, PHP gotuje stronę z bazy danych – chyba że wtyczka cache ma już gotowy talerz. Hugo działa jak drukarnia: drukuje każdą stronę raz, z wyprzedzeniem, a serwer WWW tylko wydaje gotowe egzemplarze. Kiedy przychodzi czytelnik, nic się nie gotuje.
Technicznie Hugo to static site generator: jeden program napisany w Go, który czyta pliki Markdown, szablony i obrazy, a zapisuje folder pełen HTML, CSS, obrazów i feedów. Ten folder to strona. Może go serwować dowolny serwer WWW; tutaj to zwykły nginx.
Jedna binarka, dwie edycje
Hugo to jeden plik wykonywalny bez zależności – bez PHP, bez bazy danych, bez Node.js. Występuje w edycji standardowej i extended; ta druga dodaje kodowanie WebP i Sass. Ten blog używa edycji extended, wersji 0.169.0, bo każdy obraz jest podczas builda skalowany i konwertowany do WebP.
Wniosek: Hugo przenosi całą pracę z chwili wizyty na chwilę publikacji. Cała reszta tego wpisu z tego wynika.
⚖️ Hugo kontra WordPress
| Pytanie | WordPress | Hugo |
|---|---|---|
| Kiedy powstaje strona? | Przy każdym żądaniu (albo z cache) | Raz, podczas builda |
| Co działa na serwerze? | PHP, MariaDB, często Redis | Tylko serwer WWW |
| Powierzchnia ataku | Logowanie, admin, wtyczki, XML-RPC, PHP | Pliki statyczne |
| Regularne aktualizacje | Core, wtyczki, motywy, PHP | nginx; Hugo tylko na maszynie buildowej |
| Gdzie piszę? | Edytor w przeglądarce | Edytor tekstu, Git |
| Komentarze, formularze | Wbudowane | Potrzebna zewnętrzna usługa |
| Szybkość | Z cache: 58 ms dla strony głównej | 57 ms – bez różnicy |
| Waga strony (główna, bez obrazów) | 25 plików, 198 KB | 3 pliki, 9,5 KB |
Liczby pochodzą z moich własnych pomiarów sprzed przeprowadzki. Szybkość nie była powodem: dobrze scache’owany WordPress jest równie szybki. Powodami była reszta tabeli – brak logowania do atakowania, brak cotygodniowych aktualizacji wtyczek, brak bazy danych do backupu i strona mniejsza o 95 %.
Z czego zrezygnowałem: z edytora w przeglądarce, z komentarzy i z wygody instalowania funkcji jednym kliknięciem.
Wniosek: WordPress to program, który produkuje stronę. Hugo produkuje stronę raz i usuwa się z drogi. Czy to lepsze, zależy od tego, czy potrzebujesz czegoś, co potrafi tylko działający program.
🔧 Jak działa Hugo
Treść: Markdown z front matter
Każdy wpis to plik Markdown. Na górze jest front matter, blok YAML, który Hugo czyta jako dane. Wpis na tym blogu zaczyna się tak:
---
title: 'Zabbix in Containers Watches My Home Network'
slug: zabbix-in-containers-watches-my-home-network
date: '2026-11-13T15:40:00+01:00'
translationKey: zabbix-heimnetz-2026-11
description: 'Short summary for search results, at most about 155 characters.'
categories:
- linux
tags:
- zabbix
image: uploads/2026/11/zabbix-watchman.webp
imageAlt: What the picture shows, for screen readers and search engines
---
Pod drugim --- zaczyna się tekst. Markdown obsługuje nagłówki, listy, tabele i kod; tam, gdzie to nie wystarcza, dozwolony jest surowy HTML (unsafe = true w ustawieniach Goldmarka), co ma znaczenie dla wpisów przekonwertowanych z WordPressa.
Foldery, sekcje i adresy
site/
├── content/en/posts/   posts in English (one folder per language)
├── content/de/posts/   posts in German, and so on for eight languages
├── layouts/            templates: the theme
├── assets/             CSS and JavaScript, processed by Hugo
├── uploads/            images and downloads
├── i18n/               interface words per language ("Read more", "Search")
├── data/               menus, flags, footer text as JSON
└── hugo.toml           configuration
hugo.toml decyduje o adresach: posts = "/:year/:month/:day/:slug/" zachowuje schemat URL-i, którego używał WordPress, więc żaden stary link się nie zepsuł. Kategorie i tagi to taxonomies; Hugo sam buduje stronę dla każdej kategorii i każdego tagu.
Szablony
Szablony używają języka szablonów Go. baseof.html to rama każdej strony, page.html pojedynczy wpis, home.html strona główna, a partials to elementy wielokrotnego użytku – nagłówek, sidebar, <head> ze wszystkimi meta tagami. Nie używam gotowego motywu: layouty zostały napisane tak, żeby wyglądały jak stary motyw WordPressa.
Pipeline zasobów
Hugo sam przetwarza pliki: resources.Get "css/main.css" | minify | fingerprint minifikuje arkusz stylów i wstawia hash do nazwy pliku, dzięki czemu przeglądarki mogą go cache’ować na zawsze. Obrazy są skalowane podczas builda – na przykład obraz podglądu dla mediów społecznościowych powstaje z obrazu wpisu w rozdzielczości 1200 px i jest zmniejszany, aż zejdzie poniżej 280 KB, czyli limitu dla podglądów w WhatsAppie.
Wielojęzyczność od początku
Każdy język ma w hugo.toml własny folder treści, etykietę i locale. Wpisy, które do siebie należą, mają wspólny translationKey; dzięki niemu Hugo zna tłumaczenia każdej strony i buduje przełącznik języka oraz linki hreflang. Ten blog ma teraz osiem języków – angielski, niemiecki, francuski, hiszpański, włoski, portugalski, niderlandzki i polski.
Podgląd i szkice
hugo server buduje stronę w pamięci i serwuje ją na localhost:1313; każdy zapisany plik przeładowuje przeglądarkę. draft: true trzyma wpis poza prawdziwym buildem, podobnie jak data w przyszłości – o tym więcej niżej.
Wniosek: treść, szablony i konfiguracja to trzy osobne rodzaje plików. Możesz zmienić wygląd, nie dotykając ani jednego wpisu, i napisać wpis, nie wiedząc, jak działają szablony.
🧩 Gdzie podziały się wtyczki
W WordPressie prawie każda funkcja była wtyczką. W Hugo funkcja jest albo wbudowana, albo jest kilkoma liniami szablonu, albo małym skryptem uruchamianym po buildzie.
| Wtyczka WordPressa | Zadanie | Teraz |
|---|---|---|
| Yoast SEO | Tytuł, description, canonical, Open Graph, dane strukturalne | head.html (jeden szablon dla wszystkich stron) |
| Yoast SEO | Sitemap | Wbudowana w Hugo, własny szablon sitemap.xml z hreflang |
| Yoast SEO | „Twój wpis nie ma description” | check_posts.py: build się zatrzymuje |
| Polylang | Języki, przełącznik języka | Wbudowane w Hugo |
| CompressX | Obrazy WebP, mniejsze rozmiary | Przetwarzanie obrazów w Hugo |
| Autoptimize | Minifikacja CSS, JS, HTML | hugo --minify |
| WP Super Cache, Redis | Cache stron i obiektów | Niepotrzebny – każda strona już jest plikiem |
| Wyszukiwanie (WordPress) | Wyszukiwanie pełnotekstowe | Pagefind (następna sekcja) |
SEO bez wtyczki
Yoast robił trzy rzeczy: pisał meta tagi, budował sitemap i marudził. Dwie pierwsze to teraz jeden partial, head.html. Dla każdej strony zapisuje tytuł (albo krótszy seoTitle z front matter), description, link canonical, jeden link hreflang na tłumaczenie, tagi Open Graph i Twitter z wygenerowanym obrazem podglądu, daty artykułu oraz blok JSON-LD z tymi samymi danymi strukturalnymi, które produkował Yoast (Article, WebPage, BreadcrumbList, Person). To jeden plik i jest taki sam dla każdej strony – żadnego ekranu ustawień dla każdego wpisu.
Marudzenie przeniosło się do builda: tools/check_posts.py zatrzymuje build, jeśli wpisowi brakuje tytułu, description, obrazu, tekstu obrazu, klucza tłumaczenia albo daty, albo jeśli plik obrazu nie istnieje, i ostrzega, gdy description robi się za długi albo brakuje tłumaczenia.
Rozszerzenia w Hugo
Hugo nie ma sklepu z wtyczkami, ale ma punkty rozszerzeń:
- Motywy i Hugo Modules – kompletne wyglądy albo ich części, dociągane jak zależność. Ten blog montuje własne foldery przez
module.mounts(folder uploadów jest montowany dwa razy: raz do przetwarzania obrazów, raz jako/wp-content/uploads/, żeby stare adresy obrazów dalej działały). - Shortcodes – małe szablony, które wywołujesz z Markdowna, np. dla wideo albo ramki z komunikatem.
- Render hooks – twój własny szablon dla każdego linku, obrazu czy nagłówka, który generuje Markdown.
- Formaty wyjściowe – ta sama treść jako HTML, RSS, JSON albo cokolwiek innego.
- Narzędzia po buildzie – build to tylko folder, więc może na nim pracować dowolny program. Tutaj
imgattrs.pydodajesrcseti lazy loading do obrazów w starych wpisach, a Pagefind buduje indeks wyszukiwania.
Wniosek: większość wtyczek rozwiązywała problemy, których strona statyczna nie ma. Reszta stała się szablonem albo skryptem, który mogę przeczytać w całości – co oznacza też, że nikt inny nie aktualizuje ich za mnie.
🔍 Jak działa wyszukiwanie bez serwera
Pole wyszukiwania wydaje się potrzebować serwera: ktoś przecież musi wyszukać słowa. Pagefind przenosi także tę pracę do builda.
- Podczas builda Pagefind czyta każdą gotową stronę HTML. Indeksuje tylko część oznaczoną
data-pagefind-body(artykuł), więc menu i sidebary nie zaśmiecają wyników, i pomija wszystko, co oznaczonodata-pagefind-ignore. Język rozpoznaje po atrybucielangi buduje jeden indeks na język. - Indeks jest podzielony na wiele małych plików w
/pagefind/– łącznie 18 MB dla ośmiu języków. Nikt nie pobiera całości. - W przeglądarce nic się nie ładuje, dopóki ktoś faktycznie nie zacznie szukać. Wtedy kilka linii JavaScriptu importuje Pagefind, który pobiera tylko fragmenty indeksu dla wpisanych słów i fragmenty pasujących stron, a potem pokazuje tytuł i wycinek.
import('/pagefind/pagefind.js')
  .then(function (m) { return m.search(term); })
  .then(function (r) { return Promise.all(r.results.slice(0, 8).map(function (x) { return x.data(); })); })
Efekt uboczny, który lubię: szukana fraza nigdy nie trafia do serwera jako query string, więc nie ląduje w access logu. Formularz jest celowo ukryty dla przeglądarek bez JavaScriptu – zwykłe wysłanie formularza wstawiłoby frazę do URL-a.
Wniosek: „statyczny” nie znaczy „bez interakcji”. Znaczy, że interakcja odbywa się w przeglądarce czytelnika, na danych przygotowanych z wyprzedzeniem.
✍️ Mój workflow dla nowego wpisu
- Napisać plik Markdown w
site/content/en/posts/<slug>.mdz front matter jak wyżej. Tłumaczenia dostają tę samą nazwę pliku, ten samtranslationKeyi tagi z sufiksem języka (hugo-de,hugo-fr, …). - Dodać obraz do
site/uploads/YYYY/MM/– WebP, maksymalnie 1536 px szerokości, poniżej 280 KB. W tekście obrazy są podawane jako/wp-content/uploads/YYYY/MM/name.webp, czyli adres, którego używał WordPress. - Build:
tools/build.sh
Uruchamia check_posts.py, potem hugo --gc --minify, potem imgattrs.py, potem Pagefind. Samo Hugo potrzebuje około dziesięciu sekund na całą stronę.
- Opublikować:
tools/deploy.sh <host> 10022
rsync wysyła build do folderu incoming/; serwer kopiuje go potem do nowego folderu release’u i jednym krokiem przestawia na niego symlink. Pięć ostatnich release’ów zostaje, więc tools/deploy.sh <host> 10022 rollback cofa wszystko w sekundę. Klucz deployu nie może nic więcej – serwer akceptuje dla niego dokładnie te polecenia i żadnych innych.
- Commit i push repozytorium z treścią.
Dwa repozytoria: otwarty kod, prywatna treść
Serwer i narzędzia buildowe są w publicznym repozytorium, www_hugo, obok kodu Ansible dla całej reszty. Treść – wpisy, obrazy, szablony, szkice – jest w prywatnym. Powód jest taki, że repozytorium pamięta wszystko: obraz, który zdejmuję ze strony, zostałby na zawsze w historii publicznego repo, a szkice nie są przeznaczone dla czytelników. Serwer dostaje tylko gotowe pliki przez krok deployu i nigdy nie widzi szkicu; publiczne repo w ogóle nie widzi treści.
Wniosek: publikacja to dwa niezależne kroki. Serwer pokazuje to, co zostało ostatnio zdeployowane, Git przechowuje to, co zostało ostatnio zacommitowane – robię jedno i drugie, w tej kolejności.
⬆️ Aktualizacja Hugo
Hugo w ogóle nie jest zainstalowane na serwerze. Żyje jako jedna binarka w .tools/ na maszynie, która buduje stronę, razem z Pagefindem. Wersje są przypięte w versions.yml publicznego repo:
hugo_version:                "0.169.0"   # github.com/gohugoio/hugo/releases
pagefind_version:            "1.6.0"     # github.com/Pagefind/pagefind/releases
Aktualizacja idzie według tego samego schematu co wszystko inne tutaj:
- Przeczytać release notes – Hugo co jakiś czas oznacza funkcje szablonów jako przestarzałe i ostrzega o nich w wyjściu builda długo przed ich usunięciem.
- Pobrać release extended dla Linuksa, porównać jego SHA-256 z plikiem sum kontrolnych release’u, podmienić
.tools/hugo. - Zbudować do osobnego folderu i porównać z poprzednim buildem (
diff -r). Powinny pojawić się tylko oczekiwane różnice. - Zmienić pin w
versions.yml, deploy, commit.
Ponieważ serwer tylko serwuje pliki, aktualizacja Hugo nigdy nie zepsuje działającej strony. Najgorszy przypadek to build, który się wywala albo wygląda inaczej – a to dzieje się na mojej maszynie, nie na oczach czytelników.
Wniosek: generator to narzędzie buildowe, jak kompilator. Przypnij wersję, aktualizuj świadomie i porównuj wynik.
🤖 Co Claude robi wokół Hugo
Większość pracy nad tym blogiem robię razem z Claude (AI od Anthropic) w terminalu. W podziale na tematy:
- Migracja: eksport z WordPressa, konwersja każdego wpisu do Markdowna z front matter, zachowane stare adresy i ścieżki obrazów, przekierowania dla zmienionych slugów.
- Szablony i wygląd: odtworzenie starego motywu w szablonach Hugo, slider, sidebar, ciemne zakamarki w rodzaju stron archiwum według daty.
- SEO: partial
head.html, sitemap zhreflang, dane strukturalne, obrazy podglądu poniżej limitu WhatsAppa. - Pisanie i tłumaczenie: szkice moimi słowami, tłumaczenia na wszystkie osiem języków według stałych reguł (bloki kodu identyczne co do bajtu, linki przepisane dla każdego języka) i checker, który porównuje każde tłumaczenie z angielskim oryginałem.
- Kontrole: kontrola w buildzie, sprawdzanie linków na wszystkich wygenerowanych stronach, kontrola na żywo działającej strony.
- Serwer i deploy: rola Ansible dla nginx, atomowy deploy, SELinux, monitoring.
- Troubleshooting: ustalenie, dlaczego wpis się nie pojawił (patrz następna sekcja) albo dlaczego breadcrumb wskazywał na nieistniejącą stronę.
Co zostaje przy mnie: decyzja, co jest pisane i publikowane, czytanie każdego szkicu, uruchamianie playbooków oraz każdy push i deploy – Claude pyta przed każdym z nich.
Wniosek: strona statyczna to pliki tekstowe i małe skrypty – dokładnie ten materiał, z którym asystent AI dobrze sobie radzi. Decyzje dalej należą do mnie.
🐛 Pułapki, które wyszły dopiero w eksploatacji
- Wpis z przyszłości nie jest budowany. Ustawiłem datę wpisu na 15:50, a build zrobiłem o 15:44 – Hugo po cichu go pominął. Żadnego błędu, wpisu po prostu nie było.
datemusi być w przeszłości, albo build potrzebuje--buildFuture. - Brakująca strona dnia. Breadcrumb nowego wpisu linkował do archiwum jego dnia (
/2026/11/13/), które nie istniało, bo strony dat są plikami treści, a nie stronami generowanymi. Sprawdzanie linków to wyłapało; teraz nowa data potrzebuje własnego_index.md. A podczas pisania właśnie tego wpisu oba błędy zdarzyły się znowu: wpis miał datę 08:30, a build był o 08:22, a jego nowa strona dnia miała 12:00 – strona z datą w południe jest w przyszłości przez cały poranek. - Przekonwertowany HTML jest kruchy. Wpisy zaimportowane z WordPressa to mieszanka Markdowna i surowego HTML-a. W kilku z nich słowa były sklejone albo przetrwała zabłąkana
**. Znalazła je dopiero kontrola wyrenderowanych stron we wszystkich językach. - Ustawienia typografii mają znaczenie. Typographer Hugo domyślnie zamienia
--na myślnik. WordPress tego nie robił, więc polecenia takie jak--checkw starych wpisach zmieniłyby się w–check. Ustawienie dotyka teraz tylko cudzysłowów i apostrofów. - Nie wszystko powinno trafić do wyszukiwania i feedów. Impressum i polityka prywatności zawierają adres pocztowy. Mają
noindex, są wyłączone z feedów RSS i z indeksu Pagefind – wtyczka potrzebowałaby do każdej z tych rzeczy osobnego ustawienia, tutaj to jeden warunek w szablonach. - Niektóre adresy pochodzą z front matter. Kilka starych wpisów ma klucz
url:z pełną ścieżką. W tłumaczeniach potrzebuje on prefiksu języka, inaczej wszystkie języki zgłaszają ten sam adres.
Wniosek: Hugo robi dokładnie to, co mu każesz, i rzadko narzeka. Kontrole, które wtyczki WordPressa robiły po cichu, trzeba spisać – a potem działają przy każdym buildzie.
📊 Zmierzone
| Wpisy | 146, w 8 językach |
| Wygenerowane strony HTML | około 23 000 (wpisy, tagi, kategorie, archiwa) |
| Build Hugo | około 10 s (cała strona) |
| Folder wyjściowy | 498 MB, prawie same obrazy |
| Indeks wyszukiwania | 18 MB dla 8 języków, ładowany małymi kawałkami |
| Oprogramowanie na serwerze dla bloga | nginx |
🎯 Wnioski
- Zdecyduj, gdzie odbywa się praca: przy wizycie (WordPress) czy przy publikacji (Hugo).
- Zanim zastąpisz wtyczkę, sprawdź, co naprawdę robiła – większość to jeden szablon, część to kontrola, którą musisz napisać sam.
- Wyszukiwanie, feedy i sitemapy działają bez serwera, gdy build przygotuje dane.
- Przypinaj wersję generatora jak każdego innego narzędzia buildowego i porównuj wynik przed deployem.
- Brakujący wpis bez żadnego komunikatu o błędzie to zwykle data w przyszłości.
- Trzymaj treść i kod osobno, gdy kod jest publiczny.