
Osiem godzin na kopię zapasową: jak dysk SMR, rdiff-backup i Hugo nawzajem się spowalniały
Mój komputer do kopii zapasowych pracował ostatnio ponad osiem godzin, choć prawie żadne dane się nie zmieniły. Trop prowadził do dysku twardego z dachówkami, narzędzia, które zapisuje każdy plik na dysk osobno, i bloga, który przy każdym buildzie zapisuje od nowa 70 000 plików.
🌐 Także w: English · Deutsch · Français · Español · Italiano · Português · Nederlands
W skrócie: Mój komputer do kopii zapasowych potrzebował ostatnio ośmiu godzin i 18 minut na jedno przebiegnięcie, przy danych, które prawie się nie zmieniły. Nie było jednej przyczyny, tylko trzy, które się wzmacniały: dysk twardy SMR, który załamuje się przy wielu małych zapisach; rdiff-backup, który wymusza zapis każdego pliku na dysk osobno; i mój blog w Hugo, który przy każdym buildzie zapisuje od nowa wszystkie swoje około 70 000 plików. Teraz zapisuję bloga jako jedno archiwum tar.gz (38 sekund zamiast nawet czterech godzin), rdiff-backup działa z --no-fsync, a to, co można odtworzyć, zostaje poza kopią.
Spis treści
🐢 Objaw: osiem godzin na prawie nic
Mój komputer do kopii zapasowych to stara maszyna, którą włączam, gdy trzeba zrobić kopię: pobiera wszystko, a potem sam się wyłącza. Kopiuje cztery rzeczy po kolei: Nextcloud, bloga, udziały z NAS i mój katalog domowy na komputerze roboczym. Narzędzie do wszystkiego: rdiff-backup. Utrzymuje aktualne lustro i przy każdym zmienionym pliku kładzie obok plik „increment” ze starym stanem; dzięki temu można odzyskać każdą wcześniejszą wersję.
Długo działało to szybko. Potem statystyka wyglądała tak:
| Przebieg | Nextcloud | Blog | NAS | Home | Razem |
|---|---|---|---|---|---|
| 12.11 | 15 min | 0 min | 1 min | 39 min | 56 min |
| 17.11 | 55 min | 169 min | 6 min | 167 min | 6 h 37 min |
| 19.11 | 4 min | 110 min | 186 min | 198 min | 8 h 18 min |
Te same dane, ten sam sprzęt: raz niecała godzina, raz ponad osiem. Żaden przebieg nie potrzebował wyraźnie więcej miejsca. Nie chodziło więc o ilość, tylko o coś innego.
🏠 Wniosek 1: dysk twardy ma dach z gontów
Pierwsze spojrzenie na sprzęt: dysk na kopie to Seagate Barracuda 8 TB. Ten model korzysta z SMR (Shingled Magnetic Recording): ścieżki zachodzą na siebie jak gonty na dachu. Mieści się dzięki temu więcej danych, ale jest haczyk: kto zmienia jedną ścieżkę, nadpisuje też sąsiednią, która leży na niej do połowy; dysk musi więc czytać i zapisywać od nowa całe obszary (pasma).
Żeby nie było tego widać na co dzień, dysk ma mały, zwykle zapisywany obszar bufora. Nowe dane trafiają najpierw tam, a dysk przenosi je do pasm z gontami w spokojnych chwilach. Duże pliki w jednym kawałku to żaden problem. Wiele małych zapisów natomiast szybko zapełnia bufor i wtedy wydajność zapisu spada z ponad 100 MB/s do ułamka, bo dysk jednocześnie przyjmuje i przekłada dane.
Na dysku z filmami czy zdjęciami nigdy tego nie zauważysz. Przy kopii złożonej z setek tysięcy małych plików zauważysz to bardzo wyraźnie.
💾 Wniosek 2: rdiff-backup zapisuje każdy plik osobno
Drugie spojrzenie: jak zapisuje rdiff-backup. Dla każdego pliku, który tworzy lub zastępuje, wywołuje fsync, co zmusza system operacyjny do natychmiastowego fizycznego zapisu pliku na dysk zamiast zbierania go w pamięci. Intencja jest dobra: jeśli komputer padnie w trakcie przebiegu, każdy już skopiowany plik naprawdę jest na dysku.
Na dysku SMR to jednak najgorszy przypadek: każdy plik to jeden mały, synchroniczny zapis. W przebiegach zmierzyłem około 10–15 plików na sekundę. Przy kilkuset zmienionych plikach to bez znaczenia. Przy 200 000 to cztery godziny.
🔁 Wniosek 3: Hugo przy każdym buildzie zapisuje wszystko od nowa
A skąd 200 000 zmienionych plików, skoro zmieniam tylko jeden wpis? Z przejścia na Hugo. Od tego czasu mój blog to zbiór statycznych plików: około 150 wpisów w 8 językach, do tego strony tagów, kategorie, stronicowanie, kanały RSS, indeks wyszukiwania i obrazy w kilku rozmiarach, razem około 70 000 plików.
Hugo przy każdym wdrożeniu buduje całą stronę od nowa i kładzie ją w całości na nowo, również strony, które w ogóle się nie zmieniły. Dla rdiff-backup po każdym wdrożeniu prawie każdy plik jest zmieniony: nowa kopia w lustrze plus plik increment ze starym stanem. Zależnie od liczby wdrożeń od ostatniego przebiegu było to od 59 000 do 214 000 nowych plików na przebieg. Przy 10–15 plikach na sekundę: od 110 do 234 minut tylko na bloga.
Pod WordPressem to nie był problem: wszystko było w bazie danych, a kopia była jednym zrzutem.
🧩 Ten sam wzór w dwóch innych miejscach
Gdy zasada stała się jasna, wyszła też gdzie indziej:
- NAS (186 minut 19.11): dzień wcześniej porządkowałem swoje foldery i przeniosłem wiele z nich. Dla rdiff-backup przeniesiony plik to plik usunięty plus nowy: dwa zapisy na plik. Jednorazowy efekt; 20.11 znów było to 54 sekundy.
- Katalog domowy (do 198 minut): z około 420 000 plików mniej więcej 360 000 to rzeczy, które można w każdej chwili odtworzyć: obrazy kontenerów, cache, środowiska Pythona,
node_modules, zbudowana strona, pliki robocze z ripowania płyt CD. Zmieniają się ciągle, a w razie awarii są bezwartościowe.
🛠️ Co zmieniłem
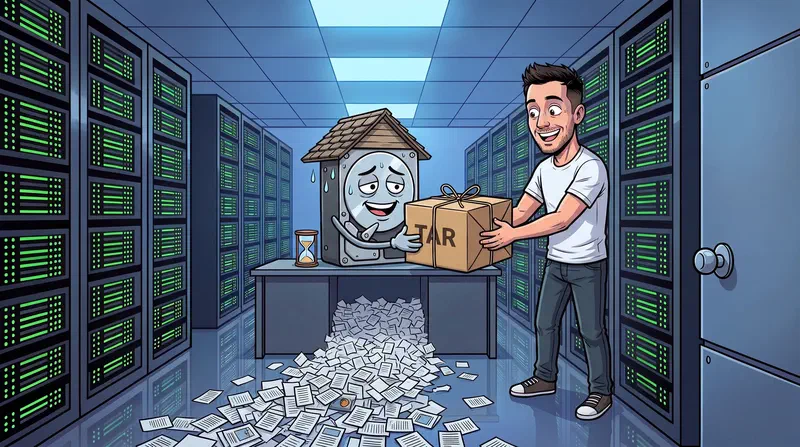
1. Blog jest zapisywany jako jedno archiwum. Zamiast odwzorowywać 70 000 pojedynczych plików za pomocą rdiff-backup, maszyna źródłowa pakuje stan przez tar, kompresuje go gzip -1 i wysyła do komputera z kopiami jako jeden strumień danych. Trafia tam dokładnie jeden plik. To idealny przypadek dla każdego dysku, a dla dysku SMR szczególnie.
ssh zrodlo "tar -C /storage --numeric-owner -cf - blog | gzip -1" > blog_2026-11-20_0814.tar.gz.part
tar -tzf blog_2026-11-20_0814.tar.gz.part | wc -l   # najpierw sprawdzić, potem zmienić nazwę
Wcześniej skrypt sprawdza, czy ostatnia kopia na źródle się udała, a potem, czy archiwum da się odczytać i czy zawiera stronę główną. Dopiero wtedy dostaje ostateczną nazwę. gzip -1 wystarcza: obrazy są już skompresowane, wyższy poziom kosztuje tylko czas.
Przechowywanie: wszystkie archiwa z ostatnich 30 dni plus pierwsze archiwum każdego miesiąca przez rok. To mniej dokładne niż historia wersji rdiff-backup, ale w zupełności wystarcza dla bloga, którego kod źródłowy i tak jest w Gicie. Stara historia rdiff zostaje dla okresu wcześniejszego.
2. rdiff-backup bez fsync dla każdego pliku. Dla Nextcloud, NAS i katalogu domowego rdiff-backup działa teraz z --no-fsync. Na samym końcu całego przebiegu jest jeden sync, który zapisuje wszystko na dysk. Ryzyko jest niewielkie: jeśli komputer padnie w trakcie, ten jeden przebieg jest niepełny; to samo dzieje się jednak z fsync, a rdiff-backup sam sprząta przerwany przebieg przy następnym starcie (regress).
3. To, co można odtworzyć, zostaje poza kopią. Katalog domowy ma teraz listę wykluczeń: magazyn kontenerów, .cache, .venvs, node_modules, .npm, zbudowaną stronę i foldery robocze. Wszystko to da się przywrócić jednym poleceniem.
📊 Wynik
Pierwszy przebieg ze wszystkimi zmianami, 20.11:
| Krok | przedtem (19.11) | potem (20.11) |
|---|---|---|
| Nextcloud (810 000 plików) | 4 min 26 s | 2 min 29 s |
| Blog | 110 min | 38 s (jedno archiwum, 888 MB, 113 002 wpisy) |
| NAS | 186 min | 54 s |
| Home | 198 min | 101 min 22 s |
| Razem | 8 h 18 min | 1 h 45 min |
W katalogu domowym pierwszy przebieg to przypadek szczególny: rdiff-backup jednorazowo zapisuje nowo wykluczone pliki jako „usunięte”, czyli ostatni raz setki tysięcy plików increment. Od następnego przebiegu znikają całkowicie.
💡 Czy dysk SSD też by to rozwiązał?
Sam zadałem sobie to pytanie. Dysk SSD (albo dysk twardy z klasycznym CMR) byłby przy wielu małych plikach wyraźnie szybszy, bez dwóch zdań. Ale tylko złagodziłby objaw: 200 000 plików increment na przebieg dla strony, którą w każdej chwili można zbudować z Gita, to marnotrawstwo również na SSD. Najpierw zmniejszyć liczbę plików, potem myśleć o sprzęcie. Przejście na dysk CMR albo na Borg, który pakuje małe pliki w duże bloki, zostaje jako opcja na później.
🤝 Jak przebiegła analiza
Szukanie przyczyny robiłem z Claude Code: powiedziałem tylko „kopia trwa osiem godzin, zobacz, czy możesz coś zoptymalizować” i dopisałem kilka pomysłów (spakowane archiwum, więcej buforowania w RAM, zastąpienie rdiff-backup, sprawdzenie dysku). Claude przeanalizował czasy z logów z ostatnich tygodni, rozpoznał model dysku jako SMR, policzył pliki increment na przebieg i powiązał to z buildem Hugo. Napisał skrypty, a gdy powiedziałem „robimy to od nowa”, przerwał trwającą kopię i uruchomił ją ponownie w nowej wersji.
🎯 Podsumowanie: nie ilość, tylko liczba
- Czas kopii zależy od liczby plików, nie od gigabajtów. 888 MB w jednym kawałku: 38 sekund. Te same dane jako 200 000 pojedynczych plików: cztery godziny.
- Dyski SMR to zły wybór dla kopii z wieloma małymi plikami. Przed zakupem zajrzyj do karty katalogowej: „SMR” często jest tylko drobnym drukiem.
- Strony statyczne kopiuje się jako archiwum, nie plik po pliku. Kod źródłowy i tak jest w Gicie.
- To, co można odtworzyć, nie należy do kopii. Cache i obrazy kontenerów kosztują czas i nie pomagają w razie awarii.
- Najpierw mierzyć, potem kupować. Nowy dysk tylko zmniejszyłby problem.
📚 Powiązane wpisy: