
De “depois eu faço” a “peraí, já está pronto?!” — Dando vida ao FLUX + ComfyUI no meu velho PC torre
🌐 Também em: English · Deutsch · Français · Español · Italiano · Nederlands · Polski
Como anunciei no meu último post, um dos meus objetivos era finalmente mergulhar no mundo das ferramentas de IA locais. Sabe, aquilo de que a galera descolada do Reddit vive se gabando: rodar seus próprios modelos de geração de imagem, no seu próprio hardware, sem algum provedor de nuvem te estrangulando de mansinho porque você pediu “um gato com chapéu de mago” uma vez a mais. Então tirei meu velho PC torre da semiaposentadoria, joguei uma instalação novinha do Debian nele e — armado com um guia passo a passo que o ChatGPT gentilmente escreveu para mim — comecei a instalar o ComfyUI e o FLUX.1-schnell. Minha principal motivação? Eu gero muitas imagens para este blog, e o ChatGPT/DALL-E & cia. adoram me jogar na cara um “você atingiu seu limite” ou “isso viola nossa política de conteúdo” depois de uns três prompts. Legal. Muito legal. Hora de hospedar o meu. 💪
😴 Aí... eu me distraí
História clássica: instalei o básico alguns dias atrás, bati em algum obstáculo, perdi a motivação e larguei no meio da configuração — venv meio ativado, aba do navegador aberta, histórico do terminal cheio de comandos pela metade. Sabe, arqueologia digital esperando para acontecer. Hoje pensei: “vamos simplesmente entregar essa bagunça ao Claude e ver o que acontece.” Então dei a ele acesso SSH à máquina e basicamente disse “termine o que eu comecei.” O que veio depois foi, sinceramente, uma das tardes mais surreais que já tive com um software.
🕵️ Passo 1: o Claude banca o detetive
Em vez de apagar tudo e começar do zero (minha abordagem de sempre, sejamos honestos), ele primeiro leu meu histórico do shell. Como um investigador de verdade. Ele descobriu que:
- o ComfyUI já estava clonado e configurado em um venv em
~/ai/ComfyUI - os pesos do FLUX.1-schnell (um unet parrudo de 23GB, mais os text encoders CLIP/T5 e o VAE) já estavam baixados
- a GPU era uma RTX 3050 com 8GB de VRAM — Debian 13, 32GB de RAM, 16 núcleos
Depois ele subiu o ComfyUI, confirmou que realmente inicializou (HTTP 200, nenhum stack trace explodindo) e devolveu um resumo de status bem arrumado. Sem drama, sem “deixa eu reinstalar tudo do zero” — só uma avaliação tranquila. Um nível suspeito de competência. 🤨
⚙️ Passo 2: “Transforma isso num serviço de verdade” — sim, senhor
Pedi que o ComfyUI rodasse como um serviço em background decente (porque eu não vou deixar uma sessão SSH aberta 24/7 feito um selvagem). O Claude escreveu uma unit do systemd, habilitou, e em uns dois minutos estava rodando de forma persistente. À prova de reboot. Reinício automático em caso de crash. O pacote completo.
🇩🇪 Passo 3: “Mas ele entende prompts em alemão?”
Esse foi o momento em que meu queixo caiu um pouco. Eu queria saber se podia simplesmente digitar prompts em alemão (porque, obviamente, é minha língua materna e eu sou preguiçoso). Então o Claude montou na hora um pequeno workflow de API text-to-image do FLUX e alimentou com:
“Ein gemütliches Café in Paris bei Sonnenuntergang, digitale Kunstmalerei, warmes Licht, Menschen sitzen draußen”
...esperou ~60 segundos, baixou o PNG resultante via SCP e me mostrou. Uma cena realmente adorável de um cafezinho em Paris ao pôr do sol. Em alemão. De primeira. Eu não esperava que isso simplesmente funcionasse. ☕
🧩 Passo 4: “Essa UI tem 4000 botões e eu só quero uma caixa de texto”
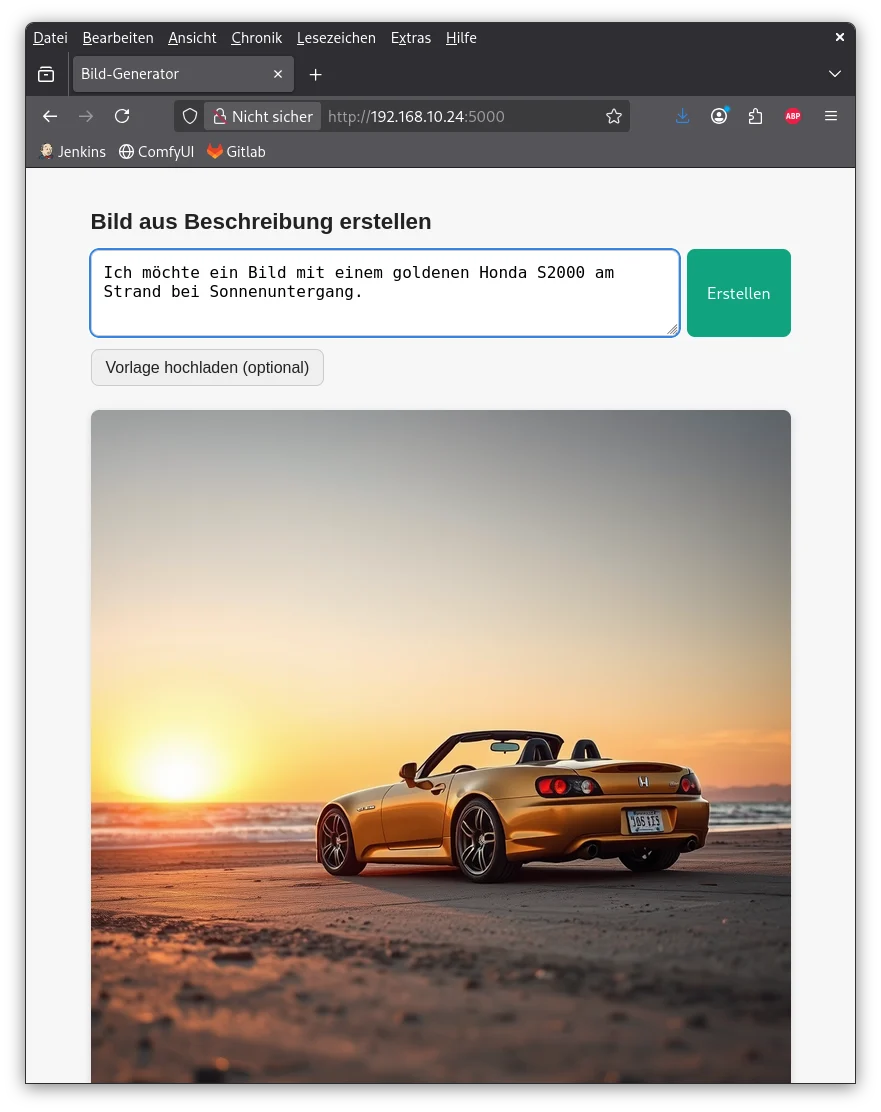
Aí abri a interface web de verdade do ComfyUI e... pois é. Grafos de nós por todo lado. Sliders, dropdowns, fios ligando caixas como uma patchbay de sintetizador projetada por alguém que ama muito, muito nós. Basicamente eu disse: “Só quero algo tipo ChatGPT — uma caixa, digito texto, recebo imagem.” Então o Claude construiu para mim um mini web app personalizado do zero:
- Um app Flask com exatamente um campo de texto e um botão
- Nos bastidores, ele monta o JSON completo do workflow do FLUX, envia para a API do ComfyUI, consulta até terminar e serve a imagem resultante
- Embrulhado também em seu próprio serviço
systemd, rodando na sua própria porta
Testei com: “Ein freundlicher roter Drache sitzt auf einem Berg, Cartoon-Stil, bunte Farben” → saiu um dragão de desenho animado 🐉 realmente fofo em cima de uma montanha. Em mais ou menos um minuto, do início ao fim. Eu construí exatamente zero disso sozinho.
🖼️ Passo 5: “Tá, mas posso subir uma imagem e mandar alterar?”
A essa altura eu estava embalado, então abusei da sorte: “Posso subir uma imagem existente como modelo e fazer a IA modificá-la?” (img2img, para os nerds da plateia.) O Claude:
- Adicionou o Pillow a um venv separado para pré-processamento das imagens (redimensionando para múltiplos de 16, porque pelo visto os VAEs são exigentes com dimensões)
- Estendeu o workflow com os nós
LoadImage+VAEEncode - Adicionou à UI um slider de “intensidade da transformação” (denoise)
- E então testou sozinho: subiu de volta a imagem do dragão e pediu “o dragão agora cospe fogo azul, é noite com um céu estrelado”
Primeira tentativa com denoise 0.6 → quase nada mudou (basicamente o mesmo dragão, luz um pouco mais sombria). O Claude percebeu, subiu para 0.9 → cena noturna completamente diferente e dramática, com fogo 🔥, mas a pose do dragão mudou por inteiro. Então ele ficou com 0.75 como padrão sensato e me explicou o trade-off. Ele estava depurando a qualidade do próprio resultado criativo. Por mim. Sem precisar pedir duas vezes.
📊 Passo 6: minha vez de fazer as perguntas bobas
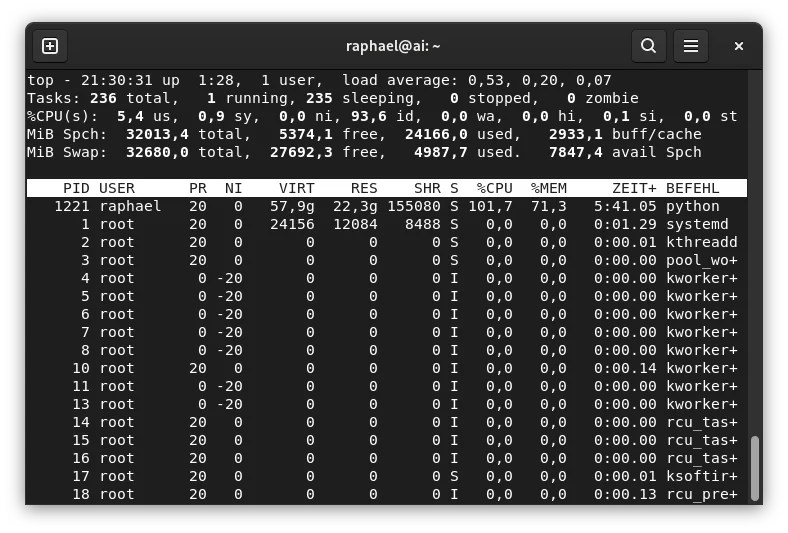
Claro que eu tinha que cutucar a máquina eu mesmo, e rodei o top enquanto uma geração estava em andamento:
MiB Spch:  32013,4 total,    632,3 free,  22986,9 used,   8827,1 buff/cache
MiB Swap:  32680,0 total,  27500,7 free,   5179,2 used.   9026,5 avail Spch

  PID USER  PR  NI   VIRT    RES   SHR S  %CPU  %MEM   ZEIT+  BEFEHL
 1221 me    20   0  56,5g  21,2g 112128 S 55,1  67,7  3:34.24 python
21GB de RAM para um único processo Python?! 😱 Perguntei “isso é normal? A GPU está fazendo alguma coisa? Minhas ventoinhas não deviam estar gritando agora?”
O Claude explicou com calma: o modelo FLUX tem ~23GB, minha GPU só tem 8GB de VRAM, então o ComfyUI faz “async weight offloading” — mantém a maior parte do modelo em RAM do sistema fixada (pinned) e envia pedaços para a GPU sob demanda. Isso explica de uma vez o uso de RAM e a carga da CPU.
Depois, para responder direito a pergunta sobre a GPU, ele iniciou outra geração e foi amostrando o nvidia-smi em loop, em paralelo:
Time        GPU-Load   VRAM        Temp    Fan
Start       34%        6.3 GB      42°C    0%
Sampling    100%       6.9 / 8 GB  53→62°C 0%
After       0-6%       3.2 GB      60→47°C 65%
Resultado: sim, a GPU fica absolutamente no talo a 100% durante o sampling, quase estourando os 8GB de VRAM — mas a ventoinha acelera depois que a carga termina, com atraso térmico, e é por isso que ela não fica barulhenta durante uma geração de ~60 segundos. Mistério resolvido, com provas. ✅
🤔 E então... onde isso me deixa
Sinceramente? Estou aqui meio chocado e fascinado em partes iguais. O que começou como “por favor termine de instalar essa coisa que eu abandonei” virou uma sessão de engenharia ao vivo e iterativa — novos requisitos surgindo no meio da conversa, sendo pegos na hora, testados, ajustados e explicados de volta para mim em linguagem simples. Sem reexplicar o contexto cinco vezes. Sem “não posso fazer isso”. Só... progresso, em tempo real, no meu próprio hardware.
Vou ser direto: quem descarta a IA como “só um autocomplete metido a besta”, “bobagem perigosa” ou um “gerador de besteira que soa confiante enquanto erra” — acho que você simplesmente não está olhando para como essas coisas estão sendo usadas e orquestradas hoje. Eu mesmo já estive muito mais nesse time. Mudei de ideia. Ver a IA investigar uma configuração pela metade, tomar decisões de infraestrutura sensatas, escrever código que funciona de verdade, fazer o deploy, testar com modelos reais e depois depurar a qualidade do próprio resultado — isso não é “fantasia”. Aconteceu na minha LAN, hoje à noite.
E sim, é exatamente isso que também me preocupa um pouco. Se uma IA conversacional consegue configurar serviços com competência, escrever pequenas aplicações, configurar o systemd, depurar o comportamento de memória da GPU e explicar tudo de um jeito que um humano entende na hora — o que isso significa para empregos de TI e trabalho de sysadmin nos próximos 20 anos? Não estou em pânico, mas também não finjo mais que a pergunta é boba. 🤷
Enfim. Agora tenho um gerador de imagens privado, local e ilimitado rodando num PC que antes juntava poeira debaixo da minha mesa. Espere muito mais imagens geradas por IA (e mais esquisitas) neste blog daqui pra frente.
No próximo post quero ir além: estender esse setup com tradução de prompts, geração de código e mais — hoje foi tudo sobre criação de imagens, mas isso claramente é só o começo.
📚 Mais nesta série: rodando minha própria IA