
De bare metal para K3s: diário de batalha de uma migração do Nextcloud
🌐 Também em: English · Deutsch · Français · Español · Italiano · Nederlands · Polski
Hoje mudei um Nextcloud de produção de uma aconchegante instalação nativa em bare metal para uma reluzente stack K3s/containers. No papel: puxar um backup, restaurar, trocar o DNS, pronto. Na prática: uma série de pequenas minas terrestres, cada uma invisível até você pisar nela. Aqui está o diário de batalha. 🪖
Índice
Passo 1: carregar os dados 🚚
O trabalho pesado foi um rsync de ~360 GB de dados de usuários mais um dump SQL de ~330 MB da máquina de backup para o novo nó. Como eu já tinha feito uma pré-sincronização mais cedo no mesmo dia, a execução final só transferiu a diferença — tudo se resumiu a uma cópia incremental rápida. Lição velha como o tempo: semeie antes, e o sync do cutover fica minúsculo.
Passo 2: o desafio das versões major 🎮
O backup era Nextcloud 32.x. A stack de destino roda 34.x. O Nextcloud tem uma regra rígida: não dá para pular uma versão major. Então é uma caminhada, um passo de cada vez:
32.0.14 → 33.0.9 → 34.0.4 (occ upgrade at every step)
A pegadinha dos containers: o código mora num volume persistente, e o Nextcloud se recusa a rodar código mais antigo contra uma versão de dados mais nova (“downgrade not supported”). Restaurar um banco v32 num pod que ainda tinha código v34 = recusa instantânea. A solução é deliciosamente gambiarra: fixar a imagem na versão correspondente, dar um empurrãozinho no version.php do volume de código para que o entrypoint reinstale o código certo, e deixar cada occ upgrade terminar (a readiness probe bloqueia até a migração do banco acabar — paciência necessária).
As minas invisíveis 💣
1. O socket do antivírus da perdição
Depois do restore, o app Arquivos jogou um seco “Internal Server Error” logo após o login — e o log ficou vazio, porque a falha aconteceu abaixo do próprio logger do Nextcloud. Causa: a config restaurada reativou o files_antivirus no modo socket, apontando para um socket do daemon ClamAV que existe na máquina nativa antiga, mas não no container. Solução: desativar o app (esta stack faz varreduras em lote toda noite). Diagnosticado só por perceber, não por alguma linha de log. Traiçoeiro.
2. A prisão do Let’s Encrypt 🔒
O DNS ainda não apontava para a máquina nova, então o cert-manager passou dias falhando ao emitir certificados. Quando finalmente troquei o DNS, os certificados continuaram sem sair. Por quê? Depois de falhas suficientes, o cert-manager estaciona o Certificate num back-off exponencial guardado no status do objeto — próxima tentativa agendada para ~24 horas depois. Reiniciar o controller? Ignorado. Apagar o secret? Ignorado. O que realmente funciona: apagar o objeto Certificate e deixar o ingress-shim recriá-lo do zero, sem histórico de falhas → emissão instantânea.
Armadilha bônus: a verificação HTTP-01 do Let’s Encrypt prefere IPv6. Se você só move o registro A e esquece o AAAA, a validação continua batendo no host antigo e falhando, enquanto tudo “parece” trocado. Mova os dois. Sempre os dois.
O evento principal: a checkbox que mentia ☑️
Essa foi a que mais me fez coçar a cabeça. O Collabora (Nextcloud Office) se recusava a abrir documentos: “Nextcloud Office could not be loaded.” Enquanto isso, o teste de conectividade do Office no painel de admin estava tranquilizadoramente verde: “Collabora Online server is reachable.” No lado do servidor estava tudo certo — discovery 200, capabilities 200, certificados válidos, URL WOPI correta, cabeçalhos de WebSocket presentes, idêntico a um host de referência que sabidamente funciona.
A diferença acabou sendo uma única configuração herdada do servidor antigo: “Disable certificate verification (insecure)” estava marcada (disable_certificate_verification=yes no richdocuments). Na máquina antiga fazia sentido — certificados autoassinados. Mas agora, com certificados Let’s Encrypt válidos, esse modo “inseguro” quebra a sessão de documento WOPI no richdocuments 11.x — deixando o teste de conectividade do admin perfeitamente verde, porque esse teste usa um caminho de código diferente do handshake real do documento.
Por que acho que foi o culpado? Porque a solução foi exatamente essa: desmarcar a caixa (apagar a chave), tentar de novo, e os documentos abriram na hora. Minha teoria: o caminho inseguro/sem verificação e a troca de token WOPI discordam quando TLS de verdade entra em jogo, e a falha só aparece na sessão do editor — a clássica situação “o health check está verde mas a funcionalidade está morta” que mantém os sysadmins humildes. Mais duas chaves que sobraram da produção (public_wopi_url, doc_format) foram embora junto, igualando a config mínima do host de referência.
A pista falsa: “por que tantos apps estão desativados?” 🎣
Depois do upgrade, uma pilha de apps aparecia como desativada (dashboard, comments, external storage, …) e eu me preparei para uma maratona de reconciliação. Então comparei o conjunto atual de apps com o estado do servidor antigo (extraído do dump do banco de antes do upgrade). Reviravolta: eles também estavam desativados na máquina antiga. A nova instância já batia com a produção. A única vítima real foi o metadata, que simplesmente não tem versão compatível com o Nextcloud 34. Às vezes o diff assustador é só… a verdade.
Nativo vs. containers: a parte honesta ⚖️
A nova instância parece um pouquinho mais lenta que a nativa antiga. RAM e CPU estão entediadas (folga de sobra), e os tempos de resposta no servidor ficam em 50–210 ms — perfeitamente saudáveis. A diferença é arquitetural: containers adicionam saltos (ingress proxy, rede overlay, PHP-FPM↔nginx pela rede de pods, banco atravessando a fronteira pod/host). Por requisição são milissegundos; somando as muitas requisições que uma página do Nextcloud dispara, vira “um pouco menos ágil”. É o imposto que você paga por reprodutibilidade, isolamento e upgrades sem dor — e para uma organização pequena é uma troca que vale a pena.
A grande limpeza do banco de dados 🗃️
Restaurar um banco de um servidor antigo arrasta junto toda a sua história. O índice do file cache carregava os caminhos de arquivo do servidor antigo sob IDs de storage obsoletos — mais um pacote OnlyOffice removido há muito tempo, cujas 276 mil linhas de índice sobreviveram ao app. Resultado: uma tabela oc_filecache com 1.053.373 linhas, das quais ~93% eram peso morto, e um banco de 1 GB.
A limpeza, feita com cuidado, com backup e valores de controle (arquivos reais de usuários e número de usuários não podem mudar): remover as 7 tabelas órfãs do OnlyOffice, apagar os dois storages velhos (o caminho nativo antigo e um mapeamento de container anterior) depois de verificar que continham zero arquivos reais — só app-data regenerável — e então OPTIMIZE para devolver as páginas liberadas ao sistema de arquivos. Resultado:
oc_filecache rows:  1,053,373  →  72,580
database size:          1 GB   →  282 MB   (-72%)
real user files:       56,183  →  56,183   (unchanged ✔)
users:                    151  →  151      (unchanged ✔)
E no disco: 27 GB de miniaturas de preview órfãs, cujo índice tinha acabado de ser apagado. Previews são um cache puro e regenerável — apagar a árvore órfã recupera o espaço, e o Nextcloud refaz as miniaturas sob demanda. (A lição de um ensaio anterior: nunca reindexe previews órfãos — isso só joga ~500 mil linhas mortas de volta na tabela que você acabou de limpar. Apague-os.)
Gremlin bônus: os gráficos de rede vazios 📉
O node_exporter reportava alegremente CPU, RAM e disco para o Grafana — mas todo painel de Network Traffic ficava teimosamente em branco. A métrica node_network_receive_bytes_total simplesmente não existia. A pista estava em node_scrape_collector_success{collector="netdev"} 0 e na linha de log:
netdev: "couldn't get netstats: socket: address family not supported by protocol"
O node_exporter moderno lê as estatísticas das placas de rede por um socket netlink — e o hardening systemd do serviço tinha RestrictAddressFamilies=AF_INET AF_INET6, que silenciosamente proíbe AF_NETLINK. O collector falha em silêncio, a métrica nunca aparece, o gráfico fica vazio. Adicione AF_NETLINK à allow-list, reload, restart — e as curvas de tráfego ganham vida. (Déjà vu bônus: exatamente a mesma omissão de AF_NETLINK já tinha mordido o hardening do MariaDB antes neste projeto. O sandboxing dá segurança e tira o netlink.)
Vendo a máquina pensar 📊
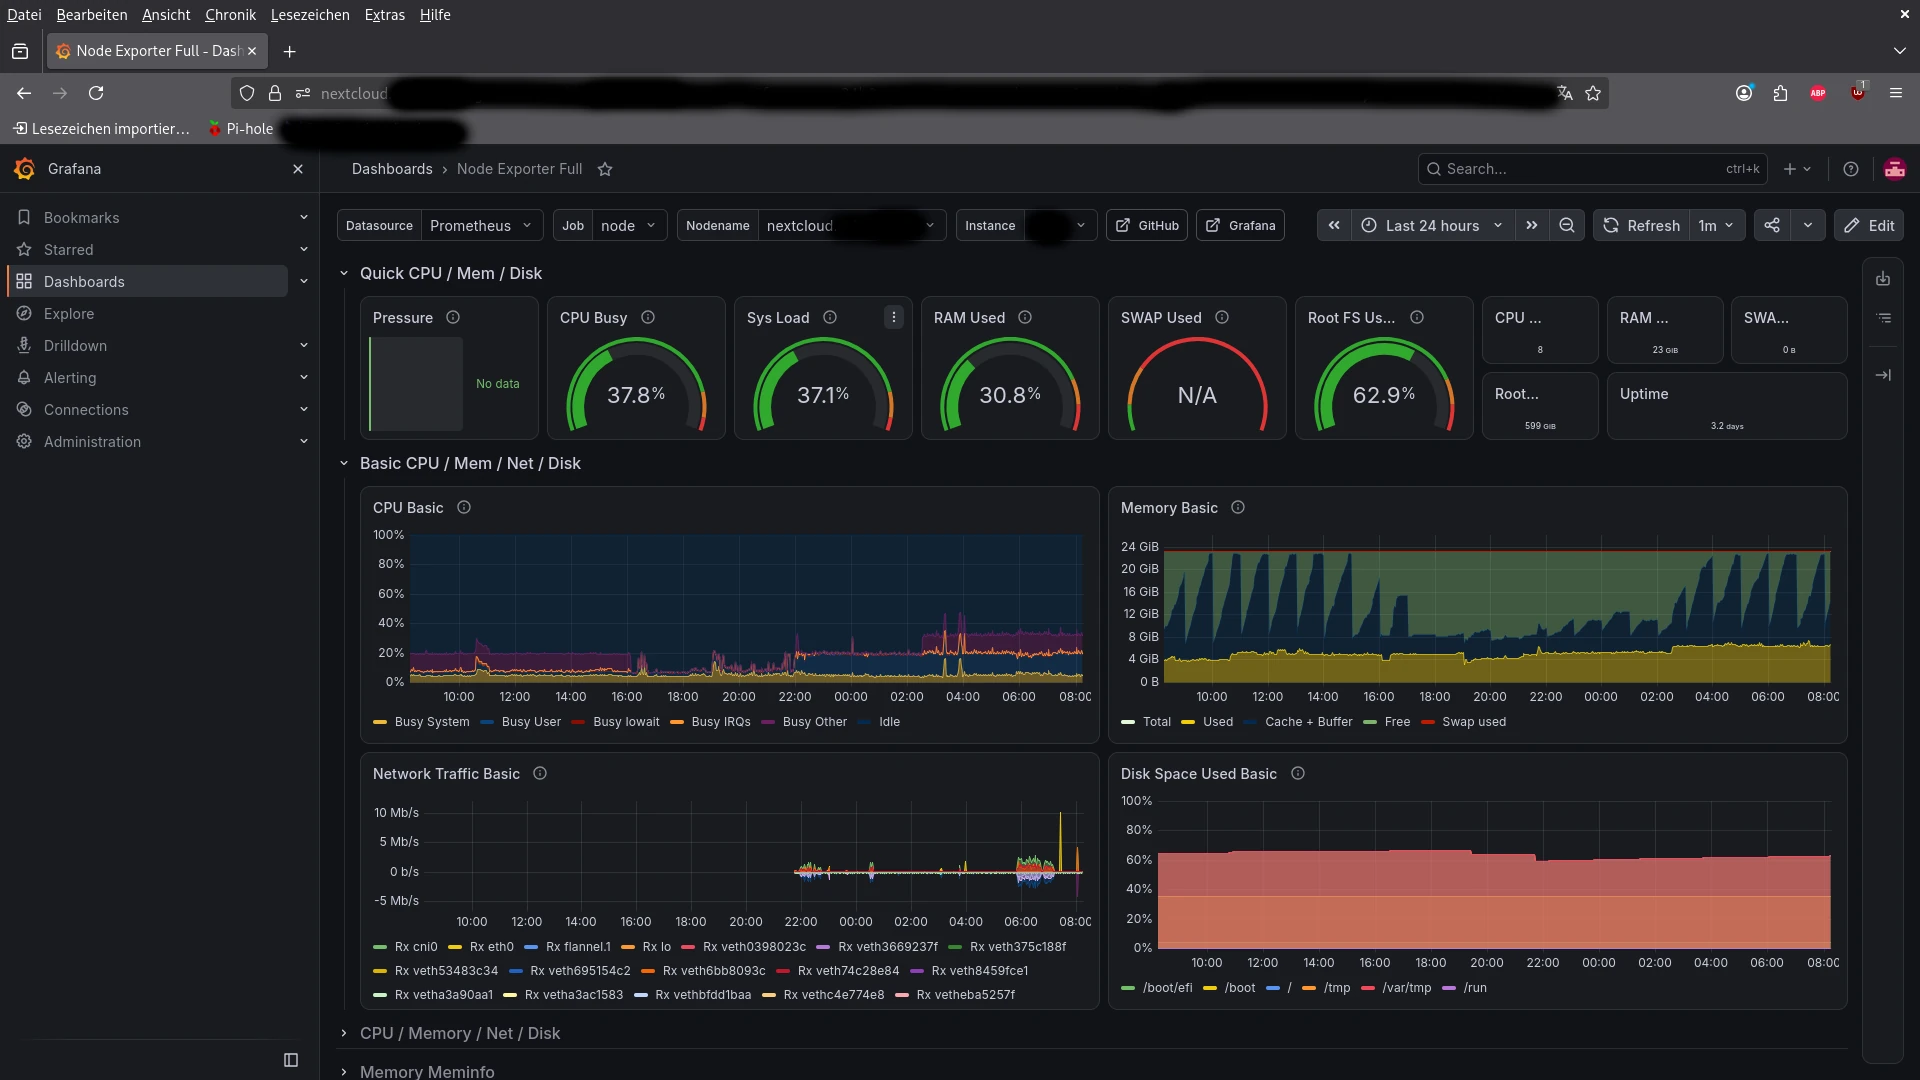
Duas medidas de arrumação relacionadas fecharam o pacote. Primeiro apaguei os 27 GB de miniaturas de preview órfãs (o índice delas já tinha sumido na limpeza do banco acima) — previews são cache puro, então nenhum dano. Depois, em vez de deixar cada testador inicial pagar o imposto do “gerando esta miniatura enquanto você espera”, disparei uma regeneração completa com occ preview:generate-all. Esse job ficou moendo a noite inteira, mastigando ~35.000 imagens, PDFs e vídeos — o dashboard acima é ele pego no flagra, e o scanner abaixo é essa mesma execução reconstruindo previews arquivo por arquivo.
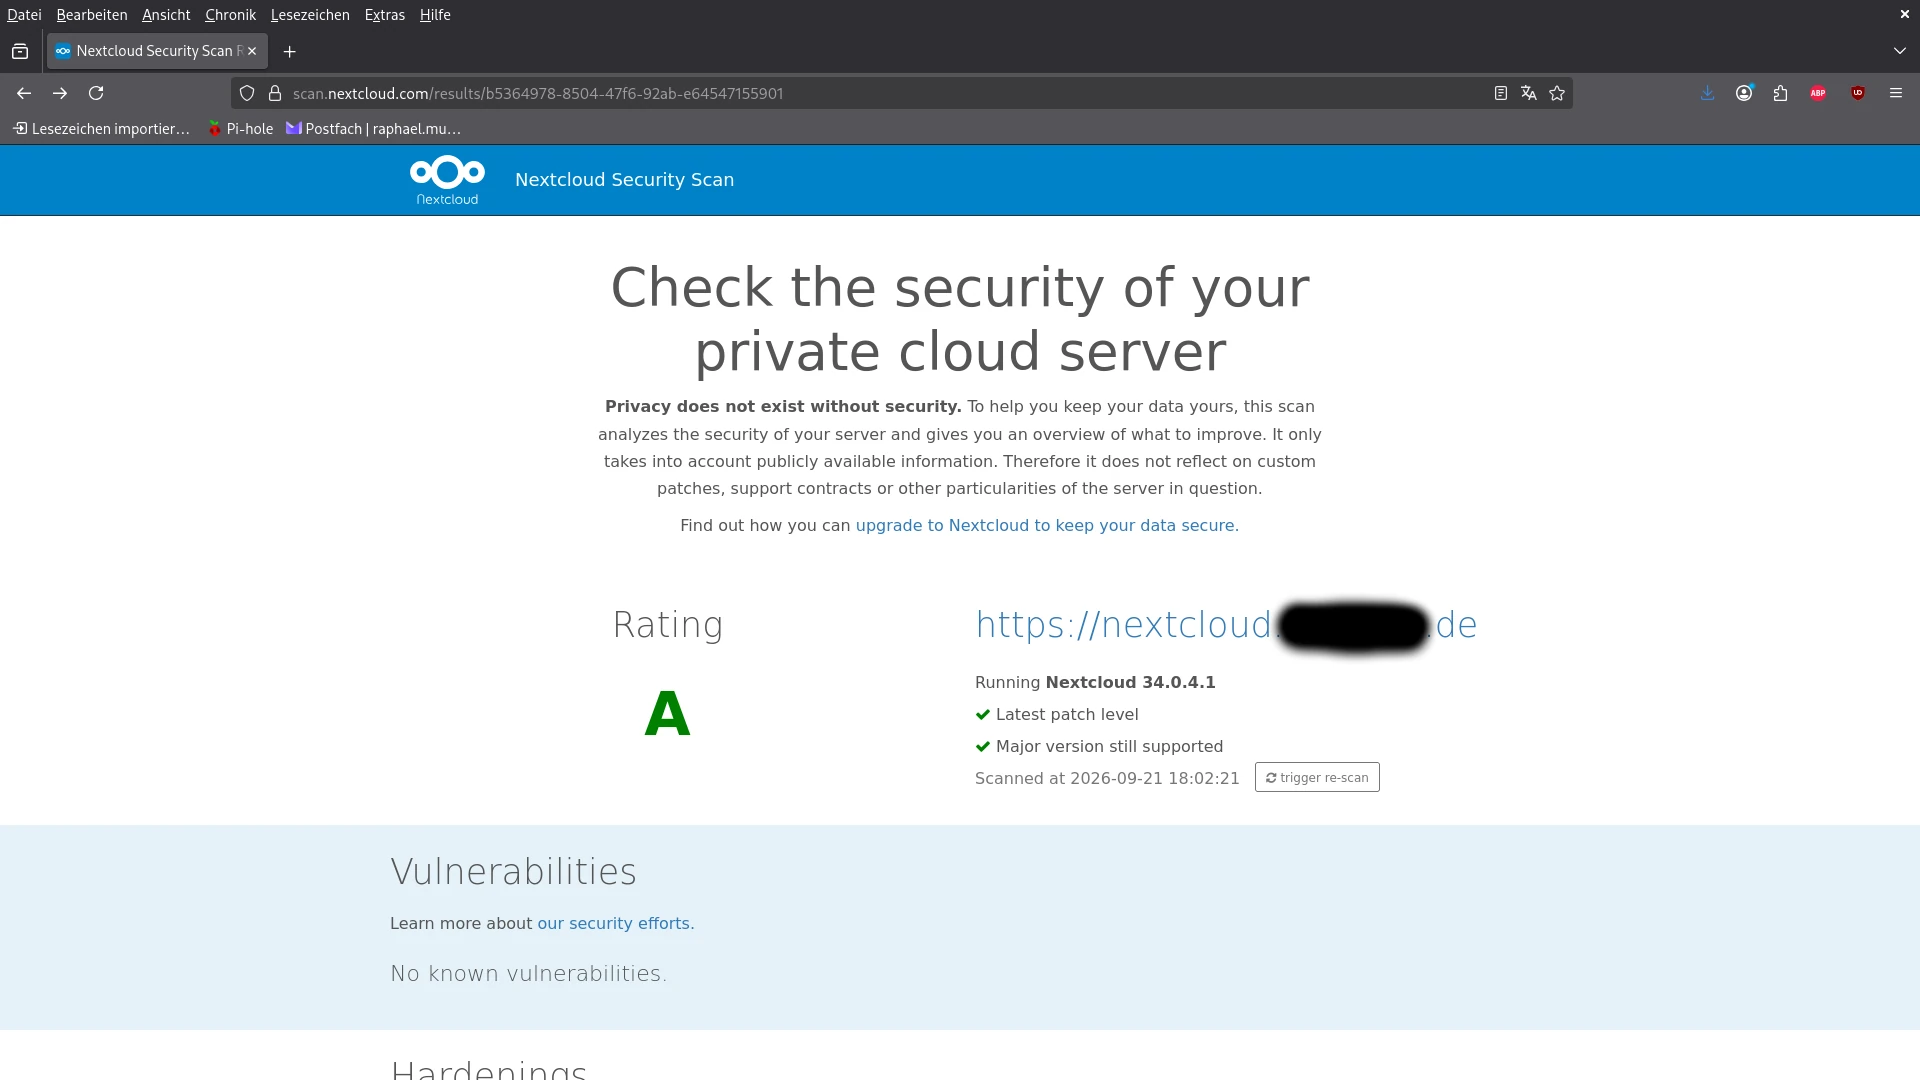
O que leva a uma pequena confissão: eu nunca tive um dashboard assim antes. Ver CPU, load, memória e — agora que o gremlin do netlink foi resolvido — throughput de rede em tempo real é estranhamente satisfatório. Estou genuinamente curioso para ver como vai ficar no uso do dia a dia: vou ver picos bonitos e limpos quando alguém fizer upload em massa de um ensaio fotográfico inteiro, ou uma equipe baixar uma galeria completa? Ainda não sei — e isso é metade da graça. Me pergunte de novo daqui a uma semana, depois que eu tiver encarado esses gráficos tempo suficiente para ter opiniões sobre percentis que eu nem sabia que tinha. 😄
Posfácio: probes que realmente reiniciam um pod travado 🩺
Um dia depois, voltei e consertei algo que vinha me incomodando. Os pods tinham readiness probes — o Kubernetes sabia quando não mandar tráfego — mas a checagem de liveness era o banguela kill -0 1, que só percebe quando o PID 1 já morreu (e nesse ponto o container já se foi de qualquer jeito). Um processo que ainda está rodando mas travado — FPM preso, sem aceitar mais conexões no socket — ficaria lá parado, quebrado, até um humano perceber. Num pod com uma única réplica, esse é justamente o caso que você quer resolvido automaticamente.
A solução é uma configuração decente de três probes em cada container: uma startupProbe que segura liveness e readiness até o app realmente estar escutando (até ~10 minutos de tolerância, para que um occ upgrade lento ou uma rajada de previews no boot nunca dispare um loop de restart), uma readinessProbe que controla o tráfego, e uma livenessProbe apertada — um connect tcpSocket de verdade, não uma checagem de PID — que reinicia o container só quando ele genuinamente para de responder. O portão de startup é a peça que segura tudo: sem ele, uma liveness probe rígida o bastante para pegar um travamento também executaria um container que está apenas bootando devagar. O blog roda a mesma stack, então recebeu o mesmo tratamento, por paridade.
Posfácio: tuning sob medida para o hardware 🎛️
Quando a poeira baixou, começou a parte divertida: olhar os novos dashboards do Grafana e fazer tuning com base no que eles realmente mostravam, e não no que eu tinha chutado. A máquina acabou tendo muito mais folga do que eu imaginava — 8 cores, 23 GB de RAM, ~16 GB livres em repouso — então parei de ser pão-duro. O Collabora passou de 4 para 6 processos filhos pré-forkados, e seus limites de 3 para 6 GB e de 2 para 4 cores, o que suaviza o soluço ocasional de cold start na primeira vez que alguém abre um documento depois de um período ocioso. Outros polimentos vieram junto: sistemas de arquivos raiz somente leitura nos sidecars, um nível de log mais sensato (só fatal esconde os warnings que você realmente quer ver), e ensinar o node_exporter a parar de reportar três dúzias de interfaces virtuais de containers, para que o gráfico de rede mostre a única placa que importa. Tudo isso mora no mesmo repositório Ansible — reproduzível, versionado e chato no melhor sentido possível.
Vestindo o chapéu preto 🕵️
Antes de dar por encerrado, fiz o que todo admin paranoico deveria fazer: ataquei minha própria instância de fora. Nada de port scans — fora as portas web e uma porta SSH só com chave, o firewall descarta tudo em silêncio, então há pouco para achar — só as requisições que um oportunista de verdade dispara contra um Nextcloud recém-instalado, caçando um ponto fraco. Versão curta: não havia nenhum.
Todo caminho sensível voltou com um seco 403 — config/, data/, .htaccess, .git/, 3rdparty/, tudo. WebDAV e remote.php exigem autenticação (401) antes de dizer qualquer coisa. O cabeçalho Server é um lacônico nginx sem versão, sem X-Powered-By, sem impressão digital de PHP para comparar com uma lista de CVEs. TLS é 1.3 com um certificado Let’s Encrypt válido; 1.0 e 1.1 são recusados de cara. O conjunto completo de cabeçalhos de segurança está no lugar — HSTS com preload, uma CSP baseada em nonce, nosniff, políticas de frame e referrer, uma permissions policy trancada, e cookies __Host-. A própria verificação de integridade de código do Nextcloud reporta zero arquivos modificados.
A parte que mais me importa: o throttling contra brute force está ligado, e — como a cadeia de reverse proxy repassa corretamente o IP real do cliente — ele freia o atacante, não o meu próprio ingress. Essa é a falha que silenciosamente castra o rate limiting em muitos setups com proxy, então vale verificar em vez de presumir. Nada disso é exótico; é basicamente os defaults chatos e corretos mais alguns toques deliberados. E esse é o ponto — a coisa mais desanimadora que um atacante pode encontrar é um muro sem emendas. 🧱
Dia três: amarrando as pontas soltas 🧹
A maratona de previews lá de cima finalmente terminou ao amanhecer do dia três, depois de bem mais de um dia mastigando a biblioteca inteira. Sem nada mais escrevendo no índice de arquivos, a arrumação adiada pôde rodar — e uma verificação de ponta a ponta decente depois revelou dois gremlins que estavam escondidos à vista de todos.
As tabelas “vazias” que não eram
Minhas próprias anotações diziam que as tabelas restantes de apps há muito removidos (Talk, Polls, Collectives, Maps) estavam vazias e prontas para serem removidas. Antes de remover qualquer coisa, contei as linhas mesmo assim. Não estavam vazias: algumas dezenas de páginas de wiki, algumas enquetes com votos, várias dezenas de salas de chat. Ninguém consegue vê-las agora, porque os apps não estão instalados — mas reinstale um app e ele pega suas tabelas antigas de volta. Então elas ficam. O que saiu: os últimos restos em disco do OnlyOffice (arquivados primeiro, depois apagados), mais um OPTIMIZE completo que espremeu a fragmentação de 59 MB para 2 MB em 17 segundos. Lição: confie na contagem de linhas, não no seu próprio resumo de ontem.
Push, não poll: notify_push 📡
Os clientes de sincronização do Nextcloud normalmente perguntam ao servidor a cada ~30 segundos: “alguma novidade?” O app notify_push (Client Push) inverte isso — um pequeno daemon em Rust mantém um WebSocket aberto, e o servidor anuncia mudanças no momento em que acontecem. (Não tem nada a ver com notificações no seu celular; essas passam pelo push proxy do Nextcloud e funcionaram o tempo todo.) Numa máquina nativa são três peças: o app, um serviço systemd e um location /push/ no servidor web. No K3s são as mesmas três peças com outra roupa: o app, seu próprio Deployment e uma rota de Ingress.
Eu tinha montado o lado Ansible no dia anterior, desligado. Revisar antes de ligar a chave revelou quatro bugs que teriam produzido o pior resultado possível — uma execução de playbook verde e uma funcionalidade morta, porque cada passo estava configurado para tolerar falhas. O occ rodava como root (o Nextcloud recusa). O binário era escolhido com um glob — e, em ordem alfabética, aarch64 vem antes de x86_64. O container rodava como root com todas as capabilities removidas, o que soa seguro até você perceber que root sem CAP_DAC_OVERRIDE não consegue ler um arquivo 0640 pertencente a www-data — como o config.php. E o ingress repassava /push/… sem alteração, enquanto o daemon espera /ws na raiz.
Mesmo com os quatro corrigidos, o primeiro self-test voltou com um 404 — renderizado pelo Nextcloud. A rota existia; o nginx só nunca a escolhia. As rotas do Nextcloud são uma regex pega-tudo, location ~ "^/", e no nginx uma regex ganha de um prefixo simples. Então a rota de push também teve que virar regex — e mesmo assim continuou perdendo, porque o ingress controller emite as locations regex em ordem alfabética do nome do Ingress, e o nginx pega o primeiro match. notify-push-routes vem depois de nextcloud-routes; renomeada para nextcloud-push-routes (“p” antes de “r”), ela ganha. Não é o conserto de que mais me orgulho, mas é um documentado. Os seis self-tests ficaram verdes, e a primeira sessão do navegador fez upgrade para WebSocket (HTTP 101) e recebeu seus primeiros eventos de arquivo. Veredito honesto: para um punhado de clientes desktop é um nice-to-have — mudanças chegam em segundos em vez de até meio minuto — não algo revolucionário.
Gremlin #1: o hardening que derrubou o banco de dados
Durante uma execução de playbook, o Nextcloud respondeu 500 por alguns instantes. O MariaDB tinha sido parado — de forma limpa, sem crash. O journal contou a história: dois segundos antes, a role de hardening do SO tinha removido o pacote rsync como “não usado neste host”. Isso era verdade no host do blog, onde tinha sido verificado. No host do Nextcloud, o pacote MariaDB-server exige rsync — suas ferramentas de cluster Galera trazem um script de state transfer baseado em rsync, mesmo num único nó que nunca vai entrar num cluster. Então o dnf obedientemente removeu o MariaDB junto, o que para o serviço; uma role posterior reinstalou os dois, e outra iniciou o banco de novo. Efeito líquido: dois a três minutos de downtime em cada execução de playbook, invisível a menos que você estivesse olhando no momento certo. A solução é uma única proteção: só remover o rsync se rpm -e --test rsync disser que nada depende dele. “Verificado no host A” não é “verdade no host B”.
Gremlin #2: os alertas que nunca podiam disparar
As regras de alerta do Grafana — disco, memória, CPU, nó fora do ar — pareciam perfeitas na interface. No log, cada uma delas falhava em toda avaliação com condition must not be empty: o código de provisionamento nunca disse ao Grafana qual query decide o alerta. E como as regras tratavam erros de avaliação como “OK”, nada nunca ficou vermelho. Um campo faltando, "condition": "B", e agora elas avaliam direito. Um alerta que não pode disparar parece exatamente um sistema saudável — o tipo mais perigoso de verde que existe. (Alertas básicos por e-mail via Monit estavam ativos o tempo todo, então a máquina não estava voando totalmente às cegas.)
Gremlin #3: o ban por port scan que não existia
Uma versão anterior deste mesmo post afirmava que um port scan “te rende um timeout instantâneo do fail2ban”. Não rendia. O fail2ban só reage a linhas de log, e o firewall registra pacotes descartados numa taxa propositalmente minúscula, então um scan simplesmente sumia na política default-drop. Inofensivo, mas ninguém era banido também. O firewall até tinha um par de sets chamado “port-scanner blocklist”, e nada relacionado a scans jamais os preencheu. A solução agora mora no kernel: a última regra antes do drop final conta tentativas de conexão por origem, e ela só vê pacotes destinados a portas fechadas, então o tráfego normal nunca conta. Uma origem que continua batendo é descartada em todas as portas por um tempo. Sem logs, sem daemon, sem parsing.
Fazer o rollout disso revelou mais uma armadilha. O serviço nftables padrão recarrega com flush ruleset, e no host do Nextcloud o kube-proxy, o flannel e o Calico também guardam suas regras no nftables. Então cada mudança no firewall também tinha apagado a rede do próprio Kubernetes, por até um minuto e meio, até ela ressincronizar. Agora o ruleset substitui só a sua própria tabela, num passo atômico.
Dias quatro a seis: lendo os logs como um detetive 🔎
Quando a poeira baixou, o trabalho mudou de “fazer funcionar” para “continuar observando”. Por alguns dias a rotina foi simples: ler o nextcloud.log, os logs dos containers e o log do ingress, e para cada linha que parecesse estranha perguntar por quê até ter uma resposta. Uma pré-condição tornou isso possível: o nível de log tinha sido elevado de 4 (só fatal) para 2 (warnings). No nível 4, nada do que vem a seguir teria aparecido. Um log silencioso nem sempre é um servidor saudável. Às vezes é só um servidor no mudo.
Gremlin #4: a jail que vigiava um arquivo morto
O fail2ban estava rodando, as jails do nginx estavam “ativas”, e a lista de bans estava vazia. Por dias. Semana tranquila ou jail quebrada? O ingress controller escreve seu access log num arquivo cujo nome termina num contador (…/0.log, 1.log, …), e cada restart do container começa um novo. O fail2ban expande o glob do logpath só quando a jail inicia. Depois de um reboot, o fail2ban sobe antes do container do ingress, se prende ao arquivo antigo, e então acompanha fielmente um log em que ninguém escreve mais, nos dois hosts. A solução é um pequeno timer systemd que percebe quando o conjunto de arquivos de log do ingress muda (e uma vez depois de cada boot) e recarrega só as jails do nginx. Uma ferramenta de segurança que reporta “tudo tranquilo” porque está olhando o arquivo errado é pior do que nenhuma, porque você acha que está protegido.
Gremlin #5: o pingue-pongue de ownership
A cada execução de playbook, o status.php do Nextcloud dava erro por um instante e o diretório de dados falhava na sua própria checagem de permissão de escrita, e depois se curava sozinho mais adiante na mesma execução. O culpado eram duas roles que discordavam. A role de SELinux criava os diretórios hostPath como root:root, e a role de deploy os definia como 33:33 (www-data). Cada execução invertia o dono de um lado para o outro, e até a próxima role consertar, o Nextcloud encarava um diretório de dados no qual não tinha permissão de escrever. Agora as duas roles definem o mesmo dono e modo, e o pingue-pongue acabou. Duas roles fazendo cada uma algo “correto” ainda podem somar um bug.
Gremlin #6: previews do Office e o muro de 1 MB
Arquivos pequenos de Word e Excel ganhavam miniaturas bonitas na lista de arquivos, os maiores não. Nenhum erro na interface, só o ícone genérico. O log do ingress tinha a resposta: 413 Request Entity Too Large em toda chamada convert-to para o Collabora. O Nextcloud renderiza previews do Office fazendo upload do documento para o Collabora, e o limite padrão de corpo de requisição do nginx é 1 MB. A rota do Nextcloud tinha um limite generoso, mas a rota do Collabora nunca recebeu um. Uma annotation (client-max-body-size: 2g) resolveu, e os previews afetados podem simplesmente ser regenerados. Os poucos erros de convert-to restantes são documentos que o Collabora genuinamente não consegue abrir, o que é um problema do arquivo e não da configuração.
Gremlin #7: a foto de 108 megapixels
Algumas fotos continuavam sem miniatura, e o app recebia um 404 para os previews delas. Todas vinham de um mesmo celular, com 108 megapixels e 12.032 pixels de largura. Decodificar uma imagem desse tamanho exige cerca de 430 MB de RAM, e o preview_max_memory do Nextcloud tem padrão de 256 MB. Acima disso, o Nextcloud nem tenta. Ele pula o preview em silêncio. Aumentei para 512 (o limite do próprio PHP está bem acima disso), e as fotos finalmente ganharam suas miniaturas.
Aproveitando, as fotos HEIC do iPhone também ganharam previews. É uma linha em enabledPreviewProviders, com um porém: definir essa chave substitui a lista padrão embutida em vez de estendê-la, então os padrões (PNG, JPEG, GIF, texto, OpenDocument…) precisam ser repetidos, ou você acaba com previews de HEIC e nenhum de JPEG. O que ficou sem preview agora é questão de dados, não de configuração: algumas dezenas de restos de 400 bytes de um upload falho de anos atrás, alguns arquivos vazios e um punhado de PNGs maiores que 50 MB.
Gremlin #8: a config que nunca chegava
Verificar o conserto anterior depois de uma execução de playbook revelou algo pior. Os novos valores estavam no ConfigMap do Kubernetes, mas o custom.config.php dentro do pod em execução tinha um dia de idade. O arquivo é montado com subPath, e um mount subPath é copiado uma vez no início do container e nunca é atualizado. O Kubernetes atualiza volumes normais de ConfigMap ao vivo, mas não os de subPath. Então cada mudança de config no repositório só passava a valer no próximo restart acidental do pod. (O conserto dos previews funcionou nesse meio-tempo só porque também tinha sido aplicado via occ.)
A solução padrão é uma annotation checksum/config no template do pod: um SHA-256 dos templates de config renderizados. Mude a config e o hash muda, o que faz o Kubernetes recriar o pod. Deixe a config em paz e nada acontece. O blog recebeu o mesmo tratamento para suas configs de nginx e PHP. Lição: “o playbook rodou verde” e “a configuração está ativa” são duas afirmações diferentes, então confira o arquivo dentro do container.
Como é um log saudável 🩺
Depois de tudo isso, a revisão diária ficou chata, e esse é o objetivo. Um dia típico agora tem um punhado de linhas no nextcloud.log: um preview que não pôde ser aberto, um notice do PHP. O resto é ruído que vale saber de cor, para não sair caçando fantasmas toda manhã:
- Collabora “Broken pipe” / “Connection reset”, cerca de 60 por hora, até às 3 da manhã: o outro lado fechou a conexão antes de o Collabora terminar de escrever. Inofensivo.
- nginx “access forbidden” em
/data/.ncdatae/.env: o primeiro é a própria checagem de segurança do Nextcloud verificando que o diretório de dados não é acessível pela web, o segundo é um bot. Ambos bloqueados de propósito. - “config differs from the latest version of this image” a cada início de pod: a role gerencia esses arquivos ela mesma (Redis com senha, por exemplo), então eles devem mesmo ser diferentes.
- notify_push “Self test failed” logo depois de um reboot: a checagem TLS falha uma vez com um erro de certificado (muito provavelmente o ingress ainda servindo seu certificado padrão por alguns segundos antes de carregar o real). Um minuto depois o self-test está 6/6 verde.
O ponto dessa lista não são as entradas em si. Quando você sabe como é o inofensivo, a única linha que não é inofensiva salta aos olhos na hora. Esse é todo o truque do monitoramento de logs. Não é mágica, é conhecer a linha de base.
Veredito ✅
Está no ar. Certificados válidos, edição no Office funcionando, dados intactos, usuários sem perceber nada. A migração em si foram os 20% fáceis; os outros 80% foram uma caça ao tesouro por configurações e comportamentos que só se comportam mal exatamente nas novas condições. Como sempre: o servidor nunca foi o problema — as suposições foram. 😄
O dia três acrescentou uma nota de rodapé a isso. Os bugs mais cabeludos não foram os que travaram — foram os que ficaram verdes: uma checkbox, um playbook tolerante a falhas, uma regra de alerta que não podia disparar. Se esta migração me ensinou um hábito, é conferir a coisa em si, não a coisa que reporta sobre ela. 🔍
Mais uma coisa: este não foi meu único rodeio com Nextcloud. Também mantenho uma segunda instância de produção como voluntário — menor, com menos dados e menos usuários cadastrados — e tudo o que aprendi aqui acabou sendo genuinamente útil. Então ela é a próxima: vou migrá-la para a mesma stack K3s nas próximas duas semanas, torcendo para pisar em bem menos dessas minas na segunda vez. 🤞
A stack Ansible completa por trás de tudo isso — as roles de WordPress e Nextcloud, o ingress, o cert-manager, o monitoramento e cada truque de hardening mencionado acima — está no GitHub, sem secrets e sem detalhes específicos dos hosts: github.com/aptupgrademe/www_k3s. Esta migração é o marco v3.0.0, então você pode navegar pelo estado exato descrito neste post, e não pelo que quer que o HEAD seja hoje.
📚 Mais nesta série: Nextcloud de bare metal para K3s