
O iLO sabe a temperatura, mas não a de ontem: um histórico de calor para o rack do meu homelab
🌐 Também em: English · Deutsch · Français · Español · Italiano · Nederlands · Polski
Tudo começou com uma pergunta simples numa tarde preguiçosa: afinal, quão quentes estão meus três servidores? O iLO respondeu na hora: ar de entrada entre 22 e 25 °C, ventoinhas em marcha lenta a 6 %, tudo verde. Ótimo. Aí veio a pergunta seguinte: e durante a onda de calor em julho? Silêncio. O iLO 5 mostra temperaturas e ventoinhas só ao vivo. Sem histórico, sem gráfico, sem “terça passada”. Então eu construí um, e está no GitHub: aptupgrademe/ilo-thermal.
O mesmo fluxo de sempre: eu faço as perguntas e tomo as decisões, meu co-admin de IA (Claude) lê os iLOs via Redfish, escreve o código e confere duas vezes cada número em que vai confiar. Essa última parte acabou importando mais do que eu esperava.
Índice
🌡️ Primeira olhada: qual sensor realmente significa alguma coisa?
Um iLO 5 num DL20 Gen10 Plus expõe uma dúzia de sensores de temperatura. Nem todos são úteis, e dois deles mentem.
| Sensor | HP1 | HP2 | HP3 | Veredito |
|---|---|---|---|---|
| 01-Inlet Ambient | 24 °C | 25 °C | 22 °C | O que importa: o ar sugado pela frente |
| BMC (chip do iLO) | 69 °C | 71 °C | 77 °C | Parece assustador, não é: autoaquecimento do chip, limite de 110 °C |
| CPU 1 | 40 °C | 40 °C | 40 °C | 🤨 idêntico nos três, com 0 % e 11 % de carga |
| AHCI HD Max | 40 °C | 40 °C | 40 °C | 🤨 mesma história |
Três servidores, cargas diferentes, exatamente 40 °C em todo lugar? Isso cheirava a placeholder, então conferimos os discos pelo Windows via SMART: 31 a 35 °C. O iLO simplesmente não consegue ler discos que não são da HPE e preenche com uma constante. Lição número um: verifique um sensor antes de construir alertas em cima dele.
🗺️ O mapa dos sensores: a frente é y = 1, o fundo é o maior y
A próxima pergunta era a interessante: eu sequer perceberia um acúmulo de calor atrás do rack? Esses modelos não têm sensor de exaustão. Mas o Redfish da HPE diz onde cada sensor fica: Oem.Hpe.LocationXmm e LocationYmm formam uma grade em que y = 1 é a entrada de ar na frente e o maior y é o fundo; x é a posição na largura. Apesar do “mm” no nome, são células da grade, não milímetros: os valores vão só de cerca de 1 a 14 num servidor de 43 cm de largura. A profundidade da grade depende do modelo: nos DL20 a última fileira é y = 13–14, no MicroServer, mais compacto, a grade termina em y = 13. No fundo há dois tipos de sensores:
- Sensores de chip (BMC, chip de rede LOM): dominados pelo próprio calor, inúteis para o fluxo de ar.
- Sensores de zona de ar (
BMC Zone,PCI 1 Zone): medem o ar ao redor, com pouco autoaquecimento. ABMC Zoneestava em 28 °C no HP2, só 3 °C acima da entrada. Esse é o meu substituto para a exaustão.
E aqui está o insight principal: a temperatura traseira sozinha não diz nada, porque ela acompanha o ambiente. Uma tarde quente eleva a frente e o fundo. O que revela um acúmulo é a diferença. Se o “fundo menos frente” cresce dos +3 °C de sempre enquanto a entrada e a carga continuam iguais, o ar quente não está conseguindo sair. O segundo indicador precoce: ventoinhas acelerando embora a entrada não esteja mais quente.
📍 Localização, localização, localização: quatro graus de cima a baixo
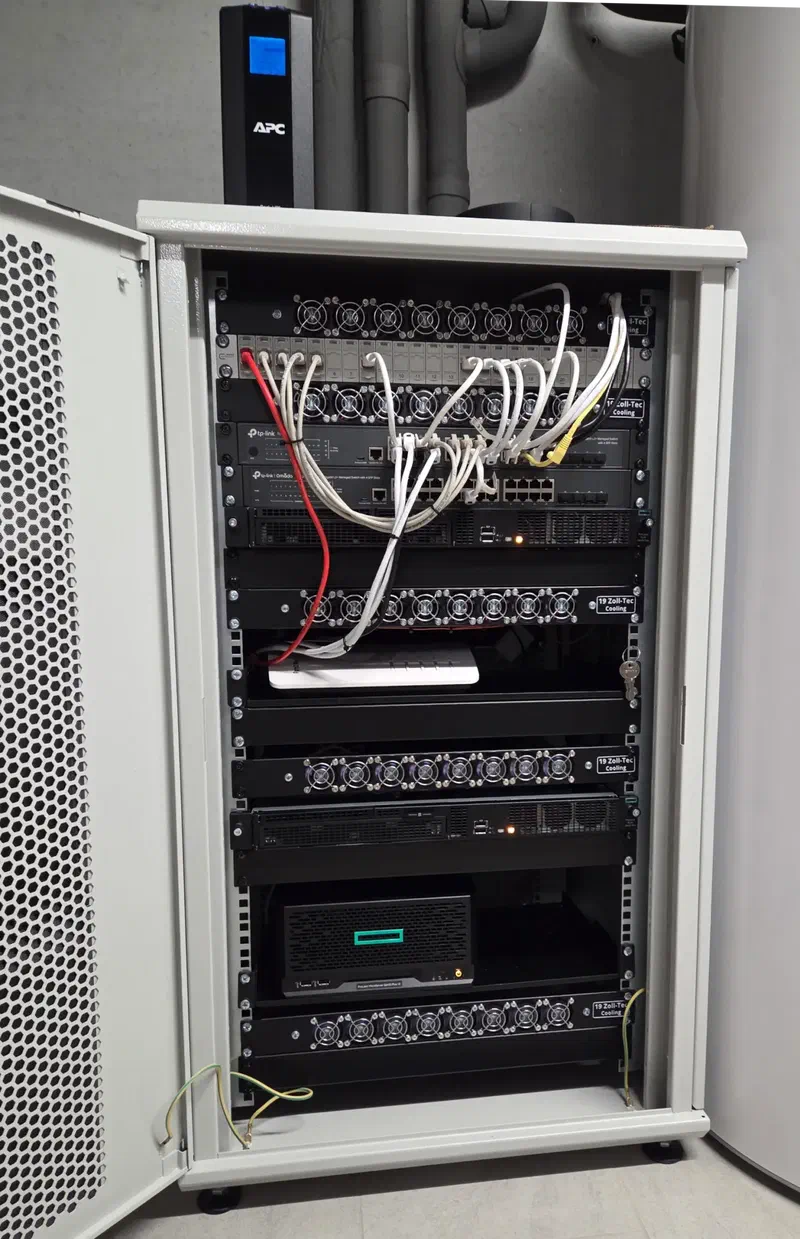
As primeiras horas de histórico já deixaram uma coisa óbvia: onde um servidor fica no rack importa mais do que qual servidor ele é. Mesma sala, mesmo rack, mesma carga ociosa, e ainda assim o ar de entrada difere em vários graus, de forma consistente, em cada leitura:
| Servidor | Posição | Entrada (média) | Faixa | Zona traseira (média) |
|---|---|---|---|---|
| HP2 (DL20 Gen10 Plus) | topo do rack | 25.9 °C | 25–26 °C | 28.9 °C |
| HP1 (DL20 Gen10 Plus) | meio | 23.9 °C | 23–24 °C | 26.9 °C |
| HP3 (MicroServer Gen10 Plus v2) | perto da base | 21.9 °C | 21–22 °C | 25.9 °C |
33 leituras nas primeiras cinco horas de uma noite tranquila; todas as ventoinhas no mínimo de 6–8 %.
De baixo para cima, a entrada sobe em degraus limpos de dois graus: 21.9 → 23.9 → 25.9 °C. São quatro graus entre o servidor perto da base e o do topo, sem nada além da altura entre eles. A física é simples: ar quente sobe. A exaustão de tudo o que está embaixo se acumula no topo do rack e o servidor de cima respira parte dela de volta, principalmente se o topo do rack é fechado ou o espaço acima é apertado. Repare que a diferença entre fundo e frente é a mesma, +3–4 °C, nas três máquinas. Os servidores em si se comportam igual; o que muda é o ar que recebem.
Por que isso importa:
- O servidor do topo atinge todos os limites primeiro. Numa tarde de verão de 30 °C, o HP3 ainda estaria confortável enquanto o HP2 já estaria batendo no limite de aviso. Planeje para o lugar mais quente, não para a média.
- Compare cada servidor consigo mesmo. Um “normal” fixo para o rack inteiro marcaria o HP2 como permanentemente suspeito. Por isso as regras de alerta usam a mediana de 7 dias de cada servidor.
- O posicionamento é um ajuste gratuito. Coloque a máquina que roda mais quente ou que mais importa embaixo, feche as unidades de rack vazias com painéis cegos para a exaustão não voltar escondida para a frente, e deixe o topo do rack com espaço para respirar.
Confissão: eu subestimei isso. Quando os servidores foram para o rack, a estratégia de posicionamento foi, digamos, “onde tinha um espaço livre”. A física do fluxo de ar não teve direito a voto. Se o rack um dia for redesenhado, os servidores vão o mais para baixo possível, empilhados juntos na base, onde o ar é mais frio.
O espaço do topo, aliás, já tem o inquilino certo: o switch. Segundo o datasheet, ele é especificado para operação estável em temperaturas ambiente bem mais altas que os servidores, então convive com o ar quente lá em cima muito melhor do que um ProLiant. A regra prática que levo daqui: o lugar mais quente fica com o dispositivo que melhor tolera calor, não com quem chegou por último.
Inofensivo em setembro. Mas agora sei exatamente qual servidor vigiar em agosto, e tenho os números para provar se um rack reorganizado realmente ajuda.
🧰 O script: chato de propósito
ilo_thermal.py é um único arquivo Python, só com a biblioteca padrão. Sem pip, sem requests, sem matplotlib, nada para quebrar no próximo upgrade da distro. A cada 10 minutos o cron o executa:
- Coletar: um
GETRedfish somente leitura por iLO para os dados térmicos. O script conecta por IP, mas verifica o certificado TLS contra a minha própria root CA e o nome no certificado, porque o jump host não usa o DNS do AD. Sim, a PKI do homelab de um post anterior se paga de novo. - Armazenar: tudo vai para o SQLite. Mais ou menos 100–150 MB para três servidores e 400 dias, um ano inteiro para comparação.
- Avaliar: as regras de alerta abaixo.
- Relatar: um único arquivo HTML autocontido com os gráficos.
🚨 Quando ele grita?
| Regra | Gatilho |
|---|---|
| Limite de entrada | ≥ 30 °C aviso, ≥ 35 °C crítico (a HPE especifica essas máquinas para 35 °C ambiente) |
| Salto de temperatura | +4 °C em uma hora: ar-condicionado morto, porta fechada, um aquecedor que alguém “só deixou ali” |
| Acúmulo de calor no fundo | diferença fundo-menos-frente ≥ sua mediana de 7 dias + 5 °C e ≥ 8 °C |
| Ventoinhas sem motivo | ventoinhas 20 pontos acima do normal enquanto a entrada não está mais quente: fluxo de ar bloqueado ou poeira |
| Sensor com problema | qualquer sensor ou ventoinha que não reporte OK |
| iLO inacessível | três consultas falhas seguidas |
“Normal” é sempre a mediana do próprio servidor nos últimos sete dias, então o lugar mais quente do HP2 no topo não conta como anomalia. É o normal do HP2. Essas regras de linha de base só se armam depois de um dia de histórico; uma instalação nova não vai te acordar por causa de ruído. Os alertas têm estado: um e-mail quando começa, um lembrete a cada 12 horas e um e-mail de “resolvido” no fim. Nada de bombardear a caixa de entrada.
😴 O coletor dorme, o iLO não
Aqui está o porém: meu jump host não fica ligado 24/7. A coleta só funciona enquanto ele roda, e como o iLO não guarda histórico de temperatura, as horas em que ele ficou desligado simplesmente se perdem. O relatório mostra essas horas honestamente como lacunas, em vez de desenhar uma linha reta enganosa pela noite.
Mas o iLO guarda uma coisa: o Integrated Management Log. Todo evento de hardware (superaquecimento, falha de ventoinha, queda de energia, erros de memória ou PCIe) fica registrado lá com timestamp, tenha alguém olhando ou não. Então o script lembra o maior EventNumber que já viu por iLO, e uma linha @reboot no cron o executa dois minutos após o boot. Qualquer coisa mais nova é reportada com seu timestamp original.
Para testar, voltamos o cursor do HP2. O script prontamente desenterrou um Uncorrectable PCI Express Error de 23 de julho que ninguém jamais tinha notado:
IML HP2 CRIT: iLO log 2026-07-23 20:29:31 UTC [PCI Bus]: Uncorrectable PCI Express Error Detected.
              (Segment 0x0, Bus 0x1, Device 0x0, Function 0x2)
Um caso isolado, nunca repetido, mas exatamente o tipo de coisa que você quer saber. Dois detalhes mantêm isso são: a primeira execução só define o cursor, então você não recebe a história de vida inteira dos seus servidores no primeiro e-mail. E a classe Network do IML é ignorada por padrão, porque a HPE registra cada link caído como “Critical”, e isso acontece a cada reboot de patch. (Durante a escavação, o IML também revelou que os três servidores perderam o link de rede exatamente no mesmo segundo em 26 de setembro, por 90 segundos. Isso não são três servidores falhando, é um switch reiniciando.)
📈 O relatório
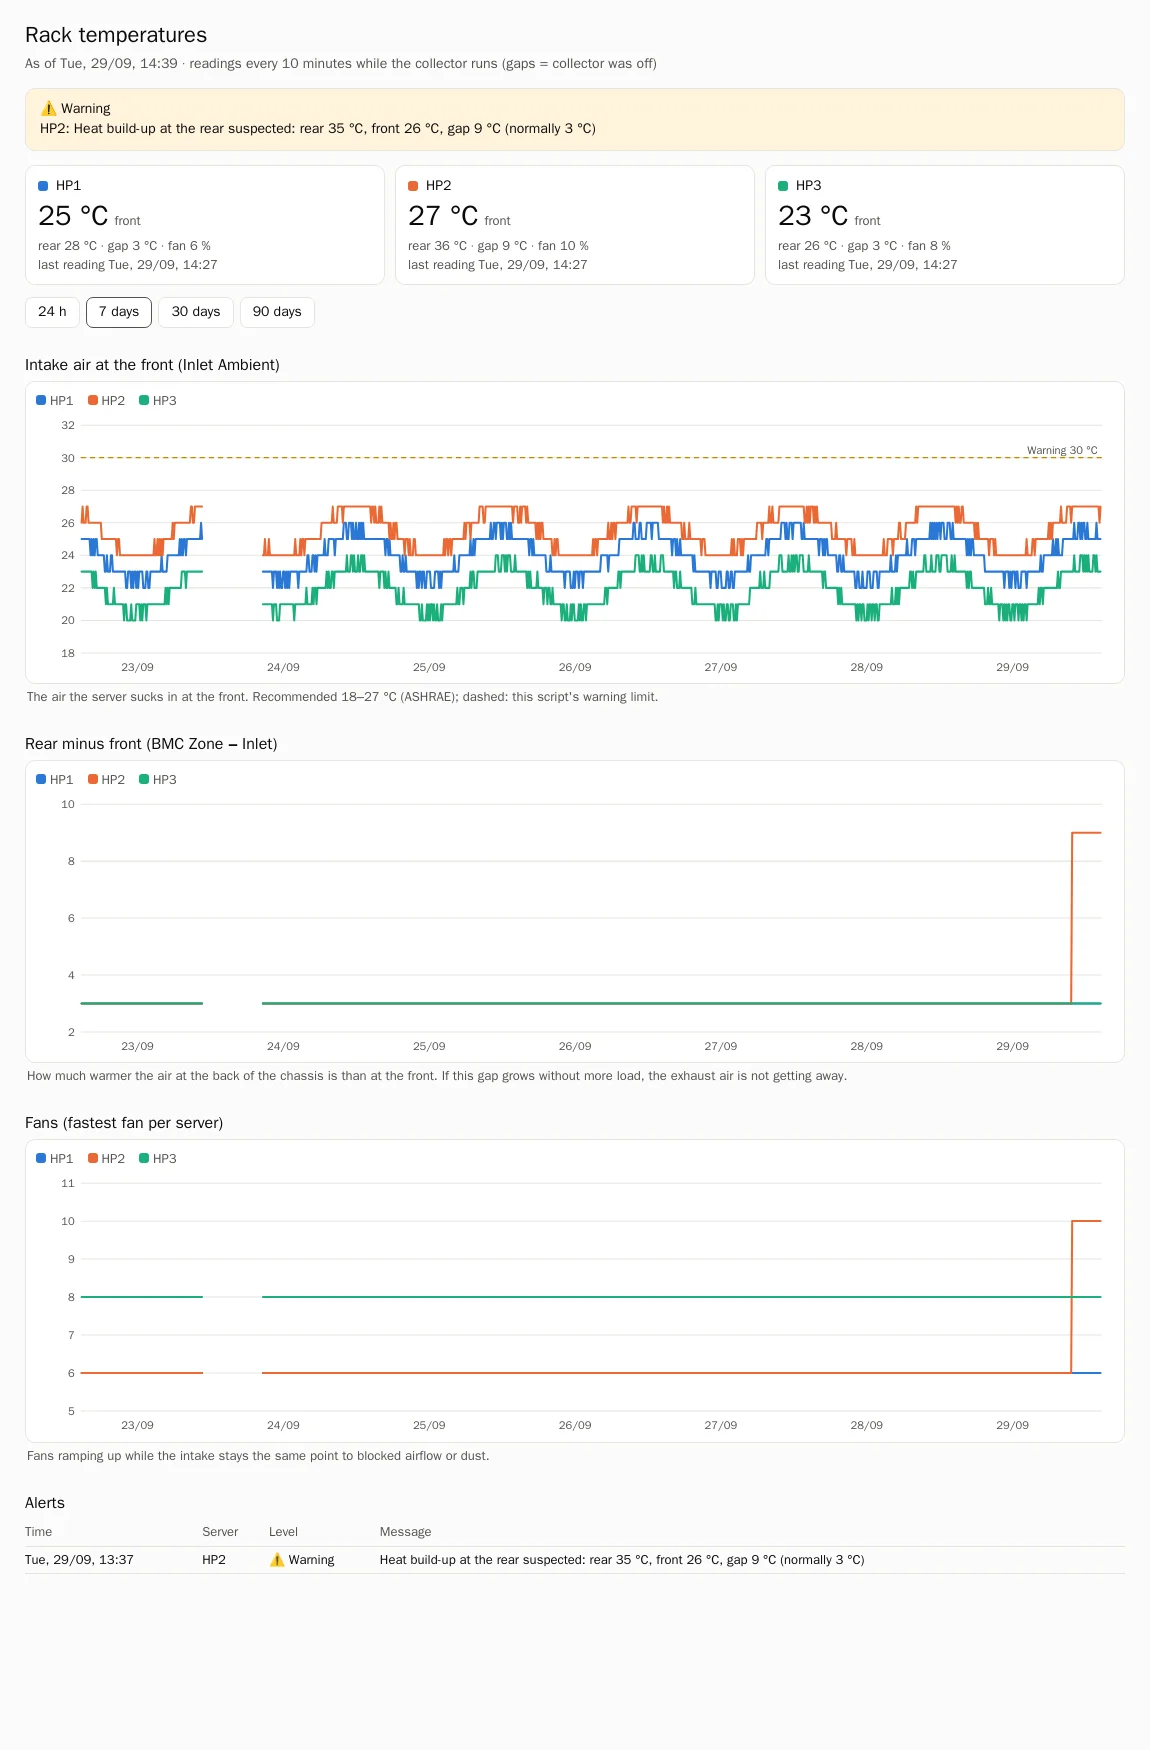
- Três gráficos: ar de entrada (com a linha de aviso), diferença fundo-menos-frente, ventoinhas. Uma medida por gráfico, nada de crimes com eixo duplo.
- Intervalos de 24 h / 7 / 30 / 90 dias, tooltips ao passar o mouse com todos os servidores naquele momento, lacunas onde o coletor estava desligado.
- Blocos de status, um banner de alerta e o histórico de alertas, incluindo as recuperações do IML.
- Modo claro e escuro, um arquivo HTML, sem dependências externas. Abra localmente ou jogue num compartilhamento.
📦 Pegue o seu
Está tudo no repositório: github.com/aptupgrademe/ilo-thermal. Documentação completa em inglês, alemão, francês e espanhol: instalação, uma conta somente leitura no iLO (o privilégio Login é tudo de que precisa), cada chave de configuração, cada regra de alerta, troubleshooting e como adaptar os dois padrões de nome de sensor a outros modelos ProLiant. O relatório e os alertas falam inglês ou alemão.
git clone https://github.com/aptupgrademe/ilo-thermal.git ~/ilo-thermal
cd ~/ilo-thermal
cp ilo_thermal.conf.example ilo_thermal.conf && chmod 600 ilo_thermal.conf
# edit: iLO account, CA file, hosts, optional SMTP
./ilo_thermal.py collect && ./ilo_thermal.py report

# crontab
*/10 * * * * $HOME/ilo-thermal/run.sh
@reboot      sleep 120; $HOME/ilo-thermal/run.sh
⚠️ Aviso legal
Este é um projeto de hobby, publicado como está sob a licença MIT. Não assumo nenhuma responsabilidade pelo funcionamento correto, por alertas perdidos ou falsos, nem por qualquer dano a hardware, dados ou qualquer outra coisa resultante do seu uso. Ele não substitui a proteção térmica dos seus próprios servidores nem um sistema de monitoramento profissional. Sempre confira os valores no iLO antes de agir com base neles. Testado no iLO 5 com DL20 Gen10 Plus e MicroServer Gen10 Plus v2; qualquer outra coisa é por sua conta.
🎯 Conclusão
O iLO é um retrato fantástico e uma memória terrível. Meia tarde transformou o retrato num histórico e, no caminho, me ensinou que dois dos meus sensores reportam ficção, que o topo do rack é sempre o lugar quente (quatro graus mais quente, no meu caso) e que o verdadeiro indicador de exaustão é uma diferença, não uma temperatura. Agora é outono e está tudo chato e verde. No próximo verão terei um ano de dados para comparar. Esse é o ponto. 🌡️📉