
Um vídeo de Natal para a equipe – metade cloud, metade homelab
Um vídeo de Natal para a nossa equipe de monitoramento, feito com IA: as cenas com pessoas vieram da cloud; som, música, edição e acabamento rodaram no meu próprio hardware. O que funcionou melhor onde – e o que ainda deu errado.
🌐 Também em: English · Deutsch · Français · Español · Italiano · Nederlands · Polski
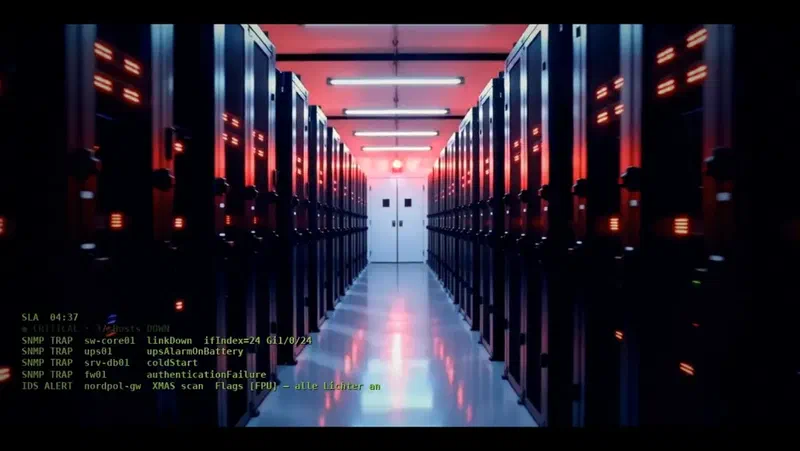
Para o calendário do Advento interno da nossa equipe de monitoramento, eu queria um vídeo curto: no data center os LEDs passam de verde para vermelho, alarme, batimento cardíaco, rebobinar – e no fim a culpa é do Papai Noel, claro, que tropeçou num “cabo de Wi-Fi”. O resultado são pouco menos de 100 segundos de filme, que lapidei ao longo de mais de 70 versões com o Claude Code como assistente de direção.
Mais interessante do que o filme em si é a pergunta quais partes vieram da cloud e quais rodaram no meu próprio hardware. Resumindo: as imagens que importam vieram da cloud – todo o resto rodou localmente.
Índice
☁️ Da cloud: as cenas com pessoas
Para as cenas de vídeo em si usei o ArtCraft, uma assinatura que dá acesso a vários modelos comerciais:
- Seedance 2.0 (vídeo): data center, central de monitoramento, close nos LEDs, Papai Noel com a rena irritada. Um clipe de 4 segundos em 720p custa cerca de 100 créditos.
- Nano Banana Pro (edição de imagem): a foto do grupo – colegas como silhuetas, gorros de Papai Noel, neve. 15 créditos por imagem.
Não controlei o ArtCraft pela interface, mas por um servidor MCP: o Claude Code escreve o prompt, envia imagens de referência e busca o resultado. Com uma regra fixa: antes de cada job o Claude informa o custo e espera o meu “Start” – um job enviado não pode ser cancelado.
A lição: para pessoas realistas em movimento, a cloud está claramente à frente hoje. Mas cada clipe custa dinheiro de verdade, e os créditos acabam mais rápido do que você imagina – no fim o saldo zerou antes de a última ideia ficar pronta.
🖥️ Local: tudo em volta das imagens
Uma máquina com placa de vídeo RTX (8 GB de memória de vídeo) fez o resto:
- ComfyUI como estrutura para os modelos locais
- MMAudio: efeitos sonoros que combinam com a imagem – renas bufando, cabos farfalhando, o tropeço
- ACE-Step: rascunhos musicais em estilos diferentes; o vídeo final usa uma faixa épica livre de royalties de uma biblioteca de músicas
- Chatterbox (text-to-speech): o narrador
- Whisper: conferência de que “Icinga” e “Zabbix” são pronunciados com clareza
- RIFE: quadros intermediários por IA para a câmera lenta
- ffmpeg e Python: cortes, transições, texto, iris wipe, créditos em máquina de escrever, o final no terminal com
systemctl status weihnachtene masterização de loudness
Localmente, tentativas custam só energia e tempo. É ali que acontece a maioria das iterações: uma voz soava metálica, outra tinha sotaque inglês, a música era pop demais – doze variantes de uma mesma frase não são problema localmente.
A lição: a cloud entrega o material bruto caro, o homelab transforma isso em filme. Assim os custos ficam baixos e o controle fica com você.
🎞️ Onde o local não basta – e onde ele é melhor
No começo tentei gerar as cenas de vídeo localmente também, com Wan 2.1/2.2. Com 8 GB de memória de vídeo os resultados foram toscos: rostos primitivos, caminhada pouco natural, clipes curtos demais.
Na prática ficou assim – o mesmo alarme no data center, gerado inteiramente no PC de casa (uma placa de vídeo RTX 3050 com 8 GB): primeiro um rascunho grosseiro com Wan 2.1 (1.3B), depois refinado com Wan 2.2 A14B. Compare com o teaser acima, onde as cenas com pessoas vêm da cloud.
No sentido contrário, a IA “mais esperta” às vezes foi a pior escolha:
- Upscaling para 1080p: o Real-ESRGAN deixou as bordas mais nítidas, mas as superfícies com cara de cera. Um upscaling clássico com leve nitidez ficou mais natural.
- Quadros intermediários: a estimativa de movimento do ffmpeg gerou artefatos de bloco em mãos rápidas e nos padrões de LED dos racks. O RIFE ficou bem mais limpo – só quando o LED passa de verde para vermelho é que o RIFE também inventou um quadro errado. Nesse ponto agora vai o original.
A lição: “mais IA” não é automaticamente melhor. Toda ferramenta inventa em algum lugar detalhes que não existem – e você precisa encontrá-los.
👀 Conferir o que não dá para ver
O Claude não consegue nem reproduzir nem ouvir vídeo. Então as verificações foram pelo caminho mais longo: quadros individuais e contact sheets, loudness por cena (antes, as cenas chegavam a ter 15 dB de diferença), reconhecimento de fala para a pronúncia e vocais escondidos, comparação de imagens para emendas exatas.
Mesmo assim encontrei erros que nenhuma medição mostrou: um “Aaa” feminino que na verdade era um artefato no fim da gravação da voz, um fundo cinza e ruidoso depois de um filtro de imagem, um texto sobreposto voando pela sala durante um crossfade. E uma vez uma extensão de 2,5 segundos simplesmente não fez nada – sem mensagem de erro.
A lição: medir não substitui assistir. Ferramentas encontram níveis e formatos, pessoas encontram o que parece “estranho”.
🔧 Atualização de novembro de 2026: o que entrou desde então
Depois do vídeo de Natal fiz alguns clipes curtos particulares: um salto de paraquedas sobre uma cidade, uma manobra com dois carros, uma dança em Marte, um breakdance numa praça. No caminho, o kit de ferramentas cresceu:
- Quadros inicial e final para o Seedance: no começo o servidor MCP só conseguia passar imagens de referência. Eu o estendi para que um clipe possa começar com uma imagem dada e terminar em outra. Assim uma cena começa exatamente onde a anterior parou, e se o quadro inicial e o final forem a mesma imagem, a pessoa volta à pose inicial depois de um movimento maluco. Nem sempre funciona: uma vez o modelo ignorou completamente o quadro inicial.
- Várias fotos de referência para um rosto (Nano Banana Pro): com uma foto só, o rosto deriva. Seis a oito fotos de ângulos diferentes deixam tudo bem mais parecido. O tamanho também importa: um rosto com só 60 pixels de largura na imagem é quase todo inventado.
- Face swap local (InsightFace com GFPGAN): onde o rosto da cloud ainda não batia, um face swap na minha própria máquina coloca o rosto real na imagem estática, com média de várias fotos de referência. Um modelo de reconhecimento facial mede o resultado: a similaridade subiu de cerca de 0,5 para 0,87. Os limites: ele troca o rosto, mas não o cabelo, assume a expressão da imagem de destino e, em movimento rápido, tremula. Por isso só uso onde o rosto está calmo.
- Fluxo óptico e remoção de fundo (OpenCV, rembg): o fluxo óptico mostrou em números que a câmera derivou para trás por três segundos num clipe, algo que eu tinha percebido mas não conseguia provar. O rembg recortou o carro, para que a fumaça artificial dos pneus pudesse ficar atrás dele em vez de por cima.
- Som em camadas: ruído de motor e de pneus como camadas separadas do MMAudio por cena, sob uma trilha contínua do ACE-Step que abaixa sob os efeitos. Uma surpresa: o limiter do ffmpeg aumenta o nível por padrão. Só com
level=disabledos picos ficaram abaixo de 0 dBFS; mixagens anteriores estavam cerca de 2 dB altas demais.
A lição: a cloud ainda entrega o movimento, mas a parte local cresceu de edição para reparo. Rostos, erros de câmera e som agora são corrigidos em casa, em vez de pagar por um clipe novo.
🧾 A conta
- Cloud: uma assinatura mensal mais créditos – quase tudo para um punhado de clipes de 4 segundos e algumas edições de imagem.
- Local: sem custos recorrentes, mas tempo de GPU – fazer o upscaling do filme inteiro leva cerca de 45 minutos.
- Tempo: o maior item. A maioria das versões foi para timing, som e detalhes, não para cenas novas.
A lição: o dinheiro está em poucos clipes da cloud, o tempo em muitas iterações locais.
🎯 As lições
- Cloud para pessoas, local para todo o resto – um homelab com 8 GB não consegue fazer pessoas realistas em movimento hoje.
- Confirme o custo antes de cada job na cloud – enviado é enviado.
- Salve cada versão com um nome novo – mais de uma vez uma versão mais antiga era a melhor.
- Use ferramentas de IA de forma seletiva – às vezes o método clássico é mais honesto do que o modelo.
- Assista e ouça você mesmo – medições mostram se algo está correto, não se funciona.
- Conserte localmente antes de gerar de novo – um face swap ou um corte não custam nada, um clipe novo de 10 segundos custa 250 créditos.