
Minha esposa venceu meu monitoramento: agora o Zabbix em contêineres vigia minha rede doméstica
Um access point de Wi-Fi parou de responder, e a única que percebeu foi minha esposa. Desde então o Zabbix 7.0 LTS roda rootless em contêineres Podman no meu servidor doméstico e manda um e-mail quando um dispositivo fica em silêncio. O setup, as armadilhas e onde encontrar o quê na interface.
🌐 Também em: English · Deutsch · Français · Español · Italiano · Nederlands · Polski
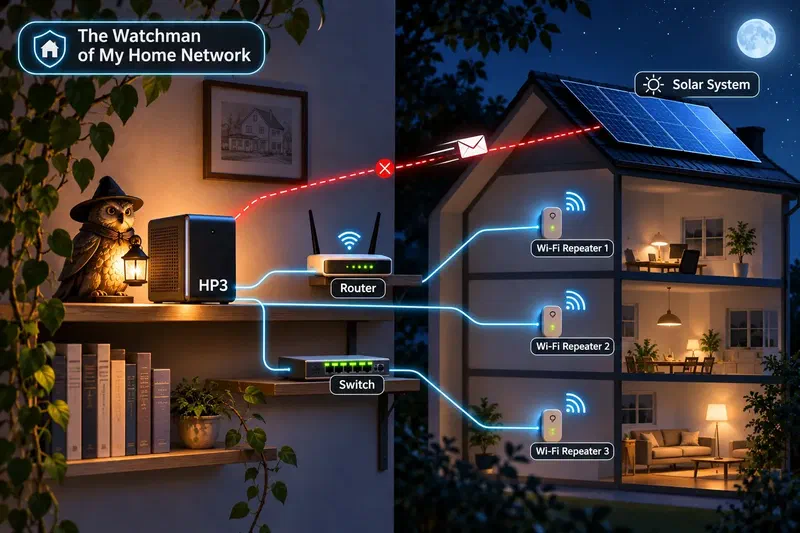
Resumindo: Pouco mais de duas semanas atrás, minha esposa chegou em casa e estava sem Wi-Fi. O access point do térreo não respondia nem a ping. Desliga, liga, e desde então está tudo bem. Ninguém tinha percebido além dela, e isso inclui meu monitoramento. Agora um Zabbix 7.0 LTS roda em quatro contêineres Podman rootless no meu servidor NAS e manda um e-mail assim que um componente da rede doméstica para de responder. Este post cobre o setup, o que precisei configurar a mais, onde as coisas travaram e onde encontrar o quê na interface web.
Índice
📶 Como tudo começou
Minha esposa chegou em casa, o celular dela não mostrava Wi-Fi e ela estava – compreensivelmente – nada contente. Confirmei na hora: o access point do térreo estava inacessível, nem pela interface web nem por ping. Tira da tomada, espera uns segundos, liga de novo. Já faz uns 14 dias que ele roda sem nenhum soluço. Por que caiu eu ainda não sei. É uma daquelas coisas que acontecem uma vez e se recusam a acontecer de novo.
O que me incomodou muito mais foi outra coisa: por que fiquei sabendo pela minha esposa e não pelo meu monitoramento? A resposta é simples. Prometheus e Grafana vigiam meus servidores, e um uptime check testa a cada cinco minutos, de fora, se o blog e o Nextcloud estão acessíveis. Ninguém estava de olho nas caixinhas da rede doméstica – roteador, repetidores, switch, base do telefone, inversor solar. Elas não têm agente; tudo o que dá para fazer é perguntar se respondem.
A lição: O monitoramento cobre exatamente aquilo para o que você o construiu. As lacunas costumam ser os dispositivos discretos que simplesmente funcionam – até não funcionarem mais.
🔭 O que é o Zabbix?
O Zabbix é um software de monitoramento open source: ele fica de olho continuamente em servidores, dispositivos de rede, aplicações e serviços. Alexei Vladishev o começou em 2001 como ferramenta interna, e a versão 1.0 saiu em 2004. Hoje ele é desenvolvido pela Zabbix SIA em Riga, na Letônia. O software é totalmente gratuito – não existe uma “enterprise edition” paga com recursos guardados; a empresa ganha dinheiro com suporte, treinamento e certificação. Até a versão 6.4 o Zabbix era licenciado sob a GPLv2, desde a 7.0 sob a AGPLv3. Uma versão LTS sai a cada ano e meio e recebe manutenção por cinco anos.
Pelo que o Zabbix é conhecido:
- Tudo em um. Coleta de dados, armazenamento, regras de alerta, notificações, dashboards, mapas e relatórios vêm num único produto com uma única interface web. Com Prometheus e Grafana são várias ferramentas que você mesmo junta.
- Com e sem agente. O agente do Zabbix (hoje em dia geralmente o Agent 2, escrito em Go e extensível com plugins) mede sistemas operacionais e aplicações por dentro. Para dispositivos em que não dá para instalar nada, existem checagens sem agente: ping, portas TCP, HTTP, SNMP, IPMI, SSH e mais.
- Redes e SNMP. O Zabbix é especialmente difundido quando se trata de switches, roteadores, firewalls, nobreaks e impressoras. Existem templates prontos para incontáveis dispositivos.
- Templates e descoberta automática. Um template agrupa checagens, alertas e gráficos. Com o low-level discovery o Zabbix descobre sozinho quais sistemas de arquivos, placas de rede ou discos um dispositivo tem e cria as checagens correspondentes.
- Ambientes grandes. Proxies distribuem o monitoramento por muitos locais; o Zabbix foi feito para dezenas de milhares de dispositivos.
- Uma API completa. Tudo o que a interface faz também funciona via JSON-RPC – montei toda a configuração deste post com um script contra a API.
Onde você encontra o Zabbix: em provedores de internet e operadoras de telecom, em data centers, bancos, órgãos públicos e universidades, em muitos departamentos de TI de empresas médias – onde quer que uma paisagem mista de servidores, equipamentos de rede e dispositivos especiais precise ser vigiada a partir de um só lugar.
O outro lado: O Zabbix é poderoso, e a interface deixa isso claro. A configuração fica no banco de dados e não em arquivos de texto, o que torna “configuration as code” mais difícil do que com o Prometheus. E o vocabulário – host, item, trigger, template, action – precisa ser assimilado uma vez antes de tudo fazer sentido.
Aliás: logo depois da instalação, o mapa do dashboard mostrava Riga – é lá que o Zabbix tem sede.
A lição: O Zabbix é o canivete suíço entre as ferramentas de monitoramento. Ele mostra sua força principalmente com muitos dispositivos diferentes que não têm agente próprio.
🎯 O objetivo e por que o Zabbix
O requisito era propositalmente pequeno: um e-mail quando um componente interno para de responder. Para dispositivos sem agente, isso significa um ping onde o dispositivo responde a ping, e um teste de conexão TCP numa porta como 80 ou 443 onde ele tem interface web.
Veio junto um segundo desejo: também quero saber quando a própria internet cair – e aí receber um único e-mail dizendo “internet inacessível” em vez de cinco alertas separados, um para cada servidor externo.
Um scriptzinho também daria conta. Mesmo assim escolhi o Zabbix, por dois motivos. Primeiro, o Zabbix traz exatamente essas checagens sem agente de fábrica, além de histórico, gráficos, dependências entre alertas e envio de e-mail. Segundo, por interesse profissional quero ganhar mais experiência prática com o Zabbix – montar eu mesmo, configurar eu mesmo, quebrar a cara eu mesmo, em vez de só ler a respeito. A rede doméstica é um campo de treino ideal: real o suficiente para fazer sentido, pequena o suficiente para que um erro não doa.
Escolhi o Zabbix 7.0 LTS (7.0.32). A versão 8.0.0 tinha acabado de sair, mas não preciso ser o primeiro da fila numa versão ponto-zero enquanto ainda estou aprendendo a ferramenta.
A lição: Quando você aprende uma ferramenta nova, um problema real e pequeno vale mais que uma demo. E uma versão LTS tira uma incógnita da equação.
🧱 O setup: quatro contêineres, sem root
O Zabbix roda no HP3, meu servidor NAS com Debian e ZFS. Ele fica ligado 24 horas de qualquer jeito e tem bastante folga (4 núcleos, 32 GB de RAM, mais de um terço livre). O setup consiste em quatro contêineres:
| Contêiner | Função | Limite de memória |
|---|---|---|
| PostgreSQL 17 | configuração, medições, histórico | 1 GB |
| zabbix-server | executa as checagens, avalia, envia e-mail | 768 MB |
| zabbix-web | interface web (nginx + PHP) na porta 8080 | 512 MB |
| zabbix-agent2 | mede o próprio HP3: CPU, RAM, discos, rede | 256 MB |
As decisões principais por trás disso:
- Podman rootless em vez de Docker como root. Tudo roda com meu usuário normal, então um erro num contêiner não cai no NAS como root.
- Quadlet em vez de Compose. Cada contêiner é um pequeno arquivo
.containerem~/.config/containers/systemd/. O Podman os transforma em serviços systemd comuns – com dependências, reinício em caso de falha e início no boot. Para que serviços de usuário iniciem sem ninguém fazer login, é preciso rodarloginctl enable-lingeruma vez. - Rede do host em vez de NAT. Com
Network=host, pings e testes TCP vão direto para a rede doméstica, sem a tradução de endereços do Podman no meio. O PostgreSQL, por sua vez, escuta explicitamente só em127.0.0.1. - Limites fixos de memória e CPU, para que o Zabbix nunca atrapalhe o NAS. Na prática, os quatro contêineres juntos usam cerca de 180 MB.
- Nenhuma senha em arquivos. A senha do banco é um Podman secret entregue aos contêineres como arquivo, e troquei a senha de admin da interface web pela API logo após o primeiro início.
Este é o arquivo do servidor:
[Unit]
Description=Zabbix server
Requires=zabbix-db.service
After=zabbix-db.service

[Container]
ContainerName=zabbix-server
Image=docker.io/zabbix/zabbix-server-pgsql:alpine-7.0.32
Network=host
Environment=DB_SERVER_HOST=127.0.0.1 POSTGRES_USER=zabbix POSTGRES_DB=zabbix
Environment=POSTGRES_PASSWORD_FILE=/run/secrets/zabbix-db-pw
Secret=zabbix-db-pw
AddCapability=NET_RAW
PodmanArgs=--memory=768m --cpus=1

[Service]
Restart=always

[Install]
WantedBy=default.target
A lição: O Quadlet transforma contêineres em simples serviços systemd. Você não precisa de orquestrador de contêineres, e systemctl --user status mostra tudo num só lugar.
💾 Onde fica o banco de dados?
Uma pergunta óbvia era se o banco pertence ao SSD do sistema ou ao pool ZFS, que na verdade é destinado aos compartilhamentos de arquivos. Escolhi o pool. O HP3 só tem SSDs, incluindo os três discos do RAIDZ1 – então velocidade não é argumento contra o pool. Em troca, lá o banco sobrevive à perda de um disco, o ZFS detecta blocos danificados por checksums, e o diretório fica no meu dataset home, que o PC de backup copia à noite de qualquer forma. O SSD do sistema tem mais de 400 GB livres, mas é um disco só e não está no backup.
As quantidades de dados são modestas: depois do primeiro dia, o banco tem menos de 100 MB. Um dataset ZFS dedicado com tamanho de bloco ajustado para o PostgreSQL seria mais limpo, mas exige root – não vale a pena nesse tamanho.
A lição: O disco mais rápido não é automaticamente o certo. Para um banco de dados, redundância e backup contam mais que os últimos poucos por cento de desempenho.
📡 O que é monitorado
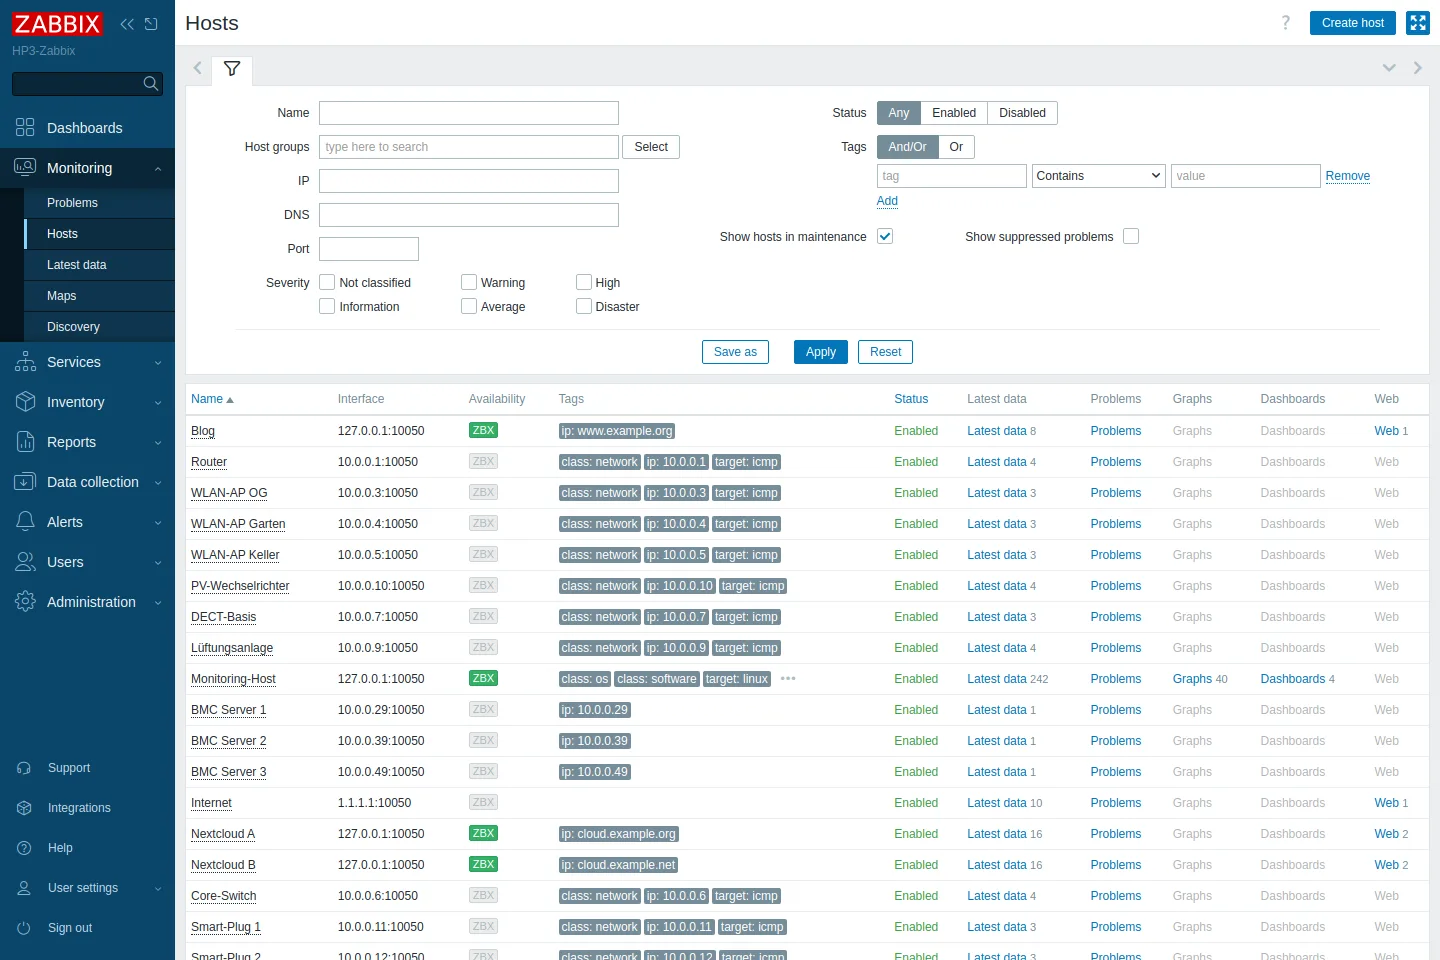
No Zabbix, a rede é dividida em dois grupos de hosts: LAN para os dispositivos da casa e External para meus servidores no data center.
Na LAN, o Zabbix verifica a cada minuto:
- Ping para o roteador, os três repetidores de Wi-Fi, o switch, a base do telefone, o sistema de ventilação, o inversor solar e duas tomadas inteligentes. O Zabbix traz o template ICMP Ping para isso. Ele marca um dispositivo como indisponível quando três pings seguidos ficam sem resposta – ou seja, depois de uns três minutos. Um único ping perdido não dispara alarme.
- Uma porta TCP adicional onde houver interface web: 443 no roteador e no switch, 80 no sistema de ventilação e no inversor. A chave é
net.tcp.service[tcp,<ip>,<port>], e esse alerta também só dispara depois de três tentativas falhas. - Só TCP 443 para os controladores de gerenciamento remoto (BMC) dos três servidores. Eles ficam na mesma rede, mas o que importa é se a interface deles responde.
Um detalhe que eu não teria sem o Zabbix: o alerta de porta depende do alerta de ping. Se um dispositivo cai por completo, recebo um e-mail (“unavailable by ICMP ping”), não dois. Só quando o dispositivo responde ao ping mas a interface web não é que o alerta de porta se manifesta.
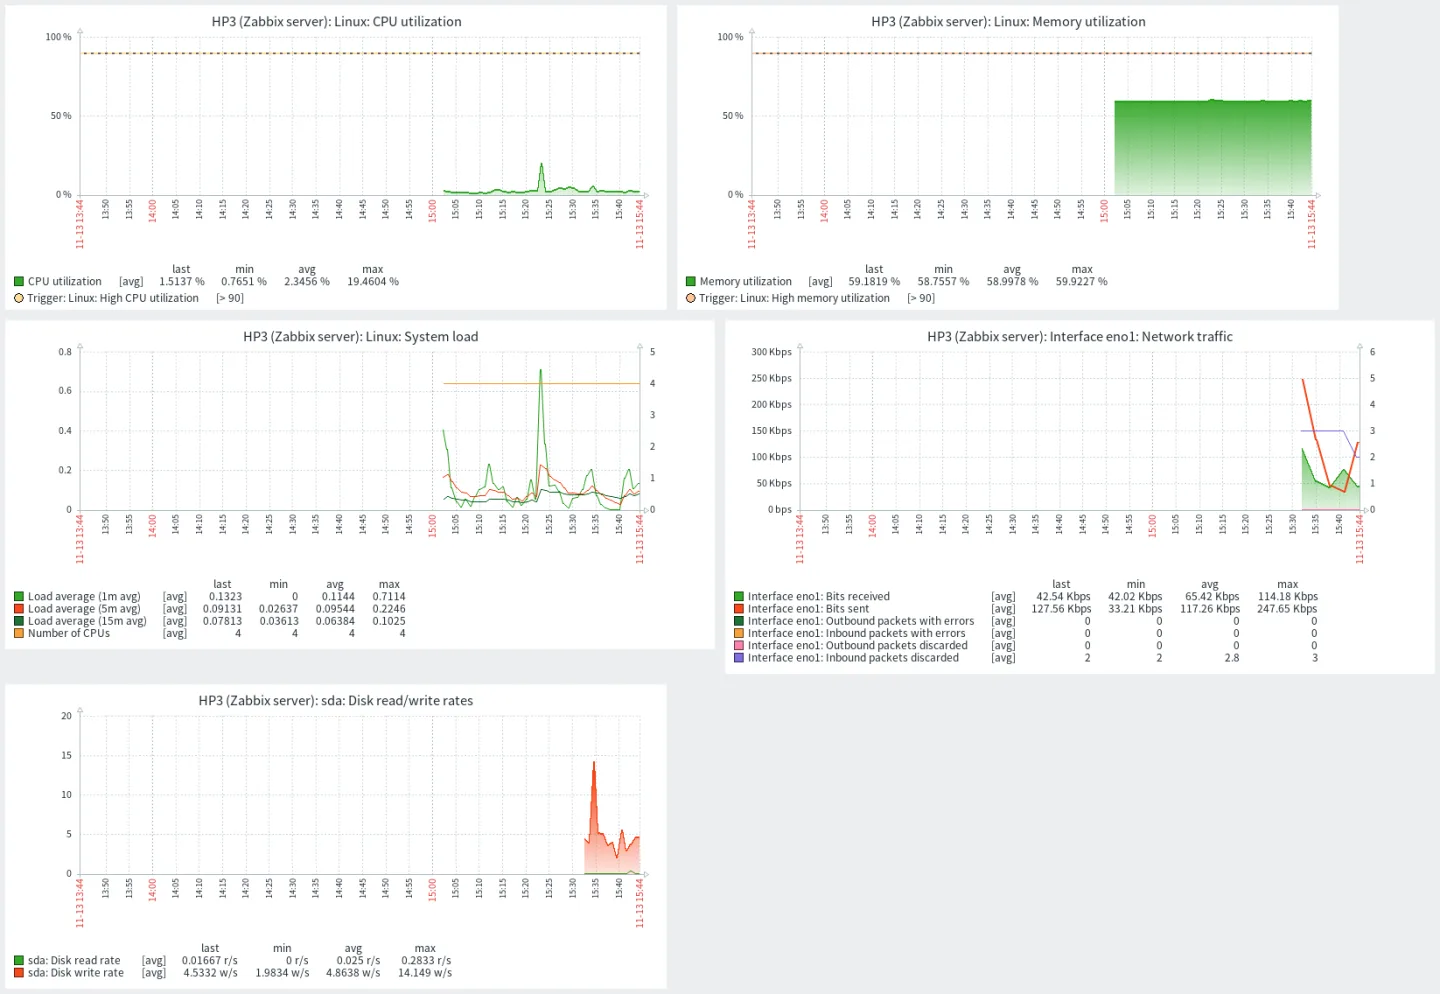
O próprio HP3 é medido pelo Agent 2: CPU, RAM, load, swap, processos, cada placa de rede, os datasets ZFS e o I/O dos quatro SSDs. O template Linux by Zabbix agent cobre tudo, e o Zabbix cria os gráficos sozinho.
Os servidores externos – o blog e duas instâncias do Nextcloud – são verificados por web scenarios: uma requisição a cada dois minutos, esperando HTTP 200 e um conteúdo específico. Para o blog é o fim da página inicial, para o Nextcloud o status.php precisa conter "maintenance":false, para o Collabora o WOPI discovery precisa responder. Além disso, o agente lê os certificados TLS a cada seis horas e avisa 14 dias antes de expirarem.
A própria internet é verificada por um host separado chamado “Internet”: a cada minuto ele faz ping em dois servidores DNS públicos independentes (1.1.1.1 e 9.9.9.9) e busca https://www.google.com/generate_204, um endereço feito exatamente para esse tipo de teste de conectividade, que só retorna “204 No Content”. O alerta “internet inacessível” só dispara quando ambos os servidores ficam calados três vezes seguidas – um soluço num único provedor não é queda de internet. Os alertas dos servidores externos dependem dele: se a internet cair, chega exatamente um e-mail.
O que eu deliberadamente não verifico nesses servidores é SSH ou portas abertas. Uma conexão crua na porta 22 sem login acaba no log do sshd, e o fail2ban pode transformar isso num ban do meu próprio IP de casa. Um teste rápido de várias portas acionaria o bloqueio de port scan do firewall. Já uma requisição HTTPS a cada dois minutos é um visitante perfeitamente normal.
A lição: Bons alertas são econômicos. Três tentativas falhas em vez de uma e dependências entre alertas garantem que um e-mail realmente signifique alguma coisa.
🐛 As armadilhas
Não existe setup sem surpresas. Estas foram as mais instrutivas:
- No começo o ping não funcionava de jeito nenhum. Toda checagem de ping terminava com
sh: /usr/sbin/fping: Operation not permitted. Na imagem do servidor, ofpingtem a file capabilitycap_net_raw=ep. Se essa capability falta no contêiner, o kernel se recusa até a iniciar o programa – não só o ping. A correção foi uma linha:AddCapability=NET_RAWno arquivo Quadlet do servidor. - Um ponto de exclamação no nome do host. O Zabbix rejeita “FRITZ!Box” como nome de host. O nome técnico só permite letras, dígitos, espaços, pontos, sublinhados e hífens. Por isso o Zabbix separa o nome técnico do visible name – o segundo é o que você vê em todo lugar.
- Um IP “livre” não estava livre. Para o teste de e-mail eu quis simular uma queda e apontei um dispositivo de teste para um endereço que não tinha respondido no meu ping scan. O Zabbix então reportou 66 % de perda de pacotes – tinha algo ali afinal, só respondia de forma instável. Para testes agora uso um endereço da faixa de documentação (192.0.2.1, RFC 5737), que garantidamente nunca responde.
- Uma instalação nova do Zabbix não envia e-mail. A action que reporta problemas aos administradores vem desativada de fábrica, e o usuário admin não tem endereço de e-mail. Sem esses dois passos tudo parece verde e mesmo assim nenhum alerta chega.
- O agente num contêiner não enxerga o host automaticamente. Estatísticas de CPU, RAM, rede e disco vêm do kernel do host de qualquer forma. Para os sistemas de arquivos, montei a raiz do host em modo somente leitura em
/hostfse usei uma macro para permitir só os sistemas de arquivos reais; senão aparecem os overlay mounts internos do Podman. O agente só encontrou os discos quando os arquivos de dispositivo/dev/sdaa/dev/sddficaram visíveis dentro do contêiner – mesmo assim, ele só lê/proc/diskstats. - Fuso horário e formato de hora. A interface estava em UTC e mostrava “03:26 PM”. Em Administration → General → GUI defini Europe/Berlin e o formato de 24 horas.
A lição: Nenhum dos problemas estava no Zabbix em si. Eles estavam nas costuras: contêiner e kernel, dados de teste e realidade, padrões e expectativas.
✉️ O teste: uma queda encenada
Uma configuração de e-mail só está provada quando um e-mail chega. O Zabbix usa a mesma conta SMTP que o HP3 já usa para seus e-mails de status (porta 587, STARTTLS). Para o teste, apontei um dispositivo para o endereço de documentação e esperei:
- Depois de uns três minutos chegou o e-mail “Problem: ICMP Ping: Unavailable by ICMP ping”.
- Depois que apontei o endereço de volta para um dispositivo real, veio “Resolved in 1m 0s”.
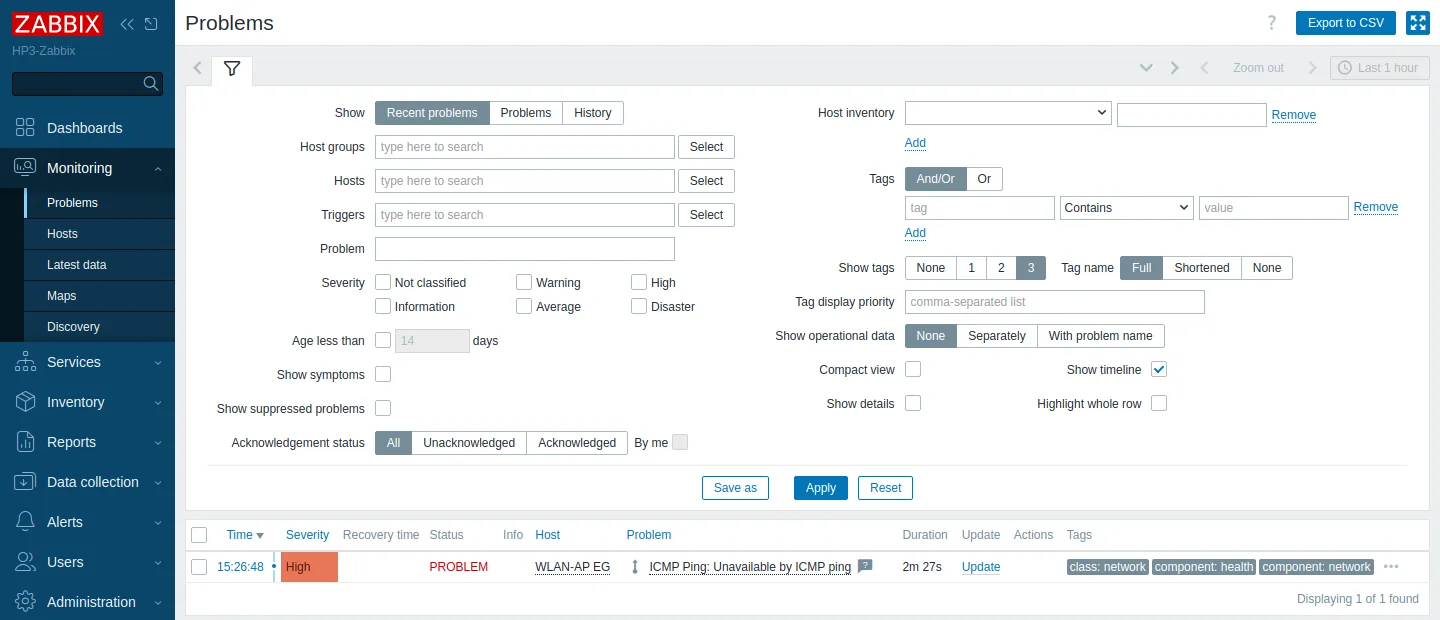
Apaguei o dispositivo de teste em seguida. Para as capturas de tela deste post encenei a queda mais uma vez, com as notificações desligadas – por isso o access point com falha se chama “WLAN-AP EG” (térreo) nas imagens.
A lição: Um alerta que nunca foi testado é uma suposição. Uma queda provocada de propósito custa cinco minutos e prova a cadeia inteira, do ping até a caixa de entrada.
🧭 Um tour pela interface
O Zabbix parece avassalador no começo: a navegação tem uma boa dúzia de entradas principais com muitas subpáginas. Para o dia a dia numa rede doméstica, porém, você só precisa de poucos lugares. Esta tabela é meu kit de primeiros socorros – abaixo dela, cada entrada explica o que você encontra lá.
| Eu quero … | Menu no Zabbix 7.0 |
|---|---|
| ver num relance se tudo está rodando | Dashboards → Global view |
| saber o que está quebrado agora e reconhecer um problema | Monitoring → Problems (botão Update) |
| ver quando algo falhou no passado | Monitoring → Problems, filtro History |
| verificar o estado de um dispositivo específico | Monitoring → Hosts, depois Latest data ou Graphs |
| ver os valores mais recentes de todos os dispositivos | Monitoring → Latest data |
| verificar se o blog e o Nextcloud respondem | Monitoring → Hosts, coluna Web |
| adicionar um dispositivo novo | Data collection → Hosts → Create host |
| adicionar uma checagem de porta a um dispositivo | Data collection → Hosts → dispositivo → Items e Triggers |
| registrar uma parada planejada (sem e-mails) | Data collection → Maintenance |
| ver pacotes de checagens prontos | Data collection → Templates |
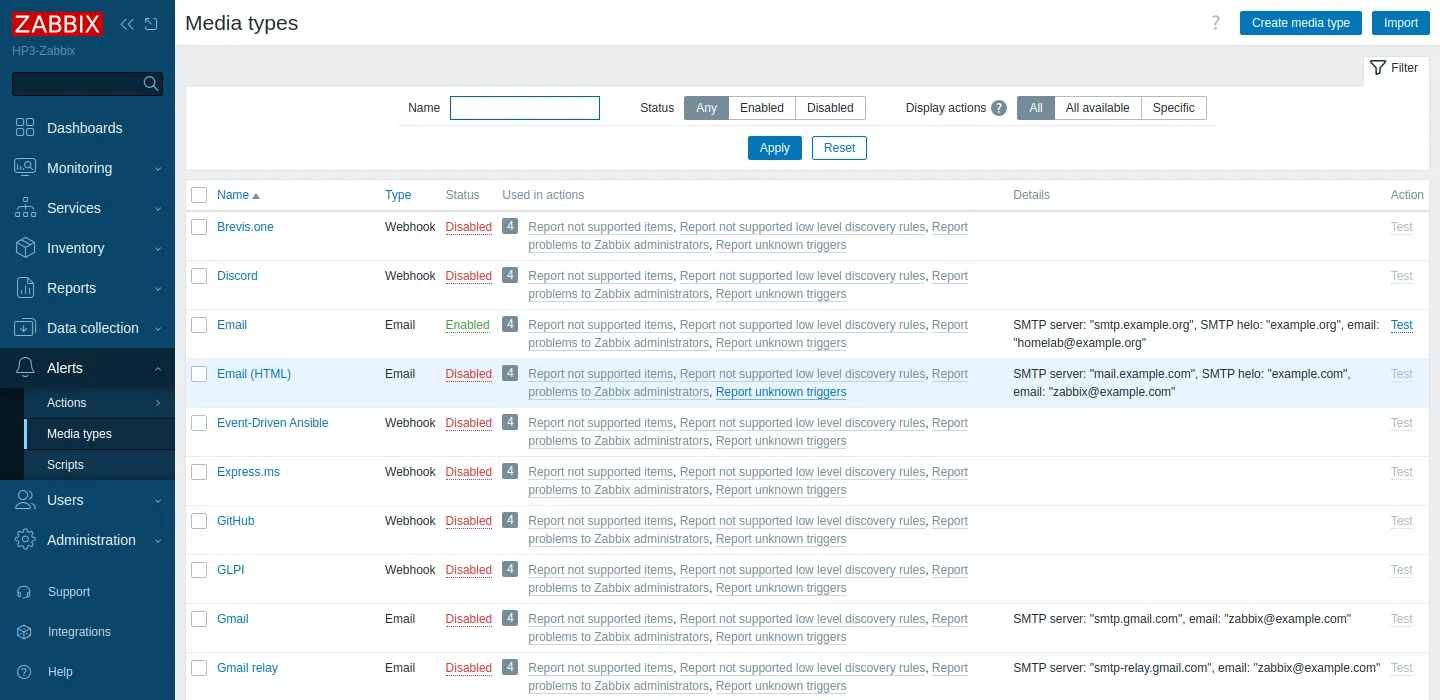
| configurar o servidor de e-mail e enviar um e-mail de teste | Alerts → Media types → Email (link Test) |
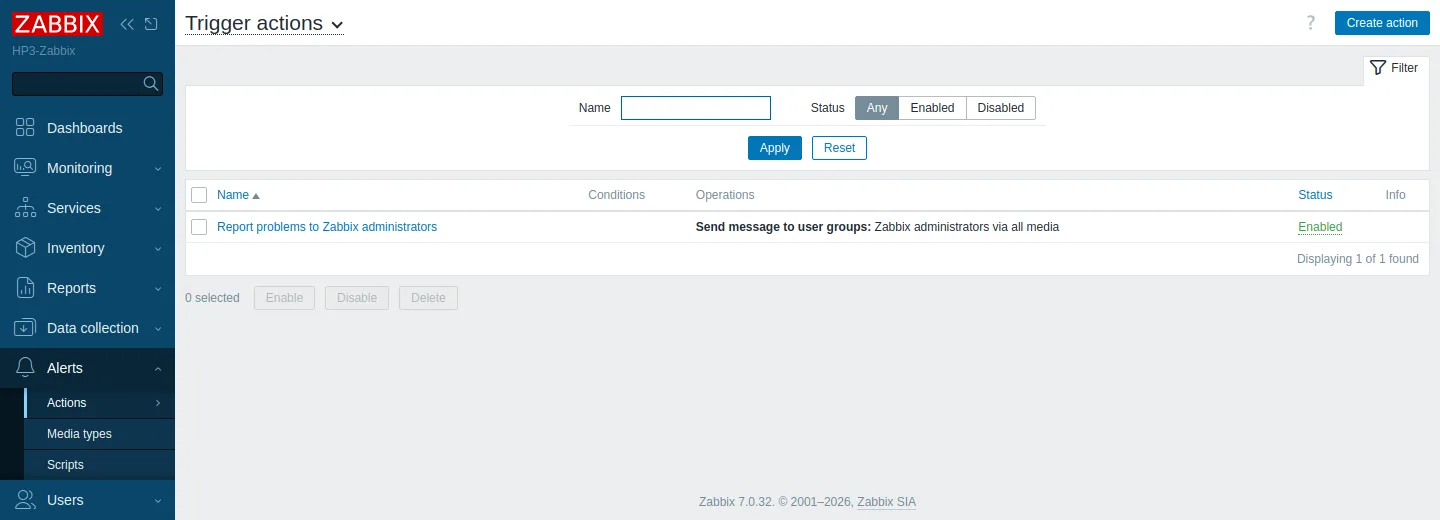
| decidir quem é notificado sobre um problema | Alerts → Actions → Trigger actions |
| cadastrar meu próprio endereço de e-mail | Users → Users → Admin → Media |
| ver quais e-mails foram enviados | Reports → Action log |
| mudar fuso horário e idioma | Administration → General → GUI |
| mudar minha própria senha | User settings → Profile |
Dashboards → Global view: a visão geral
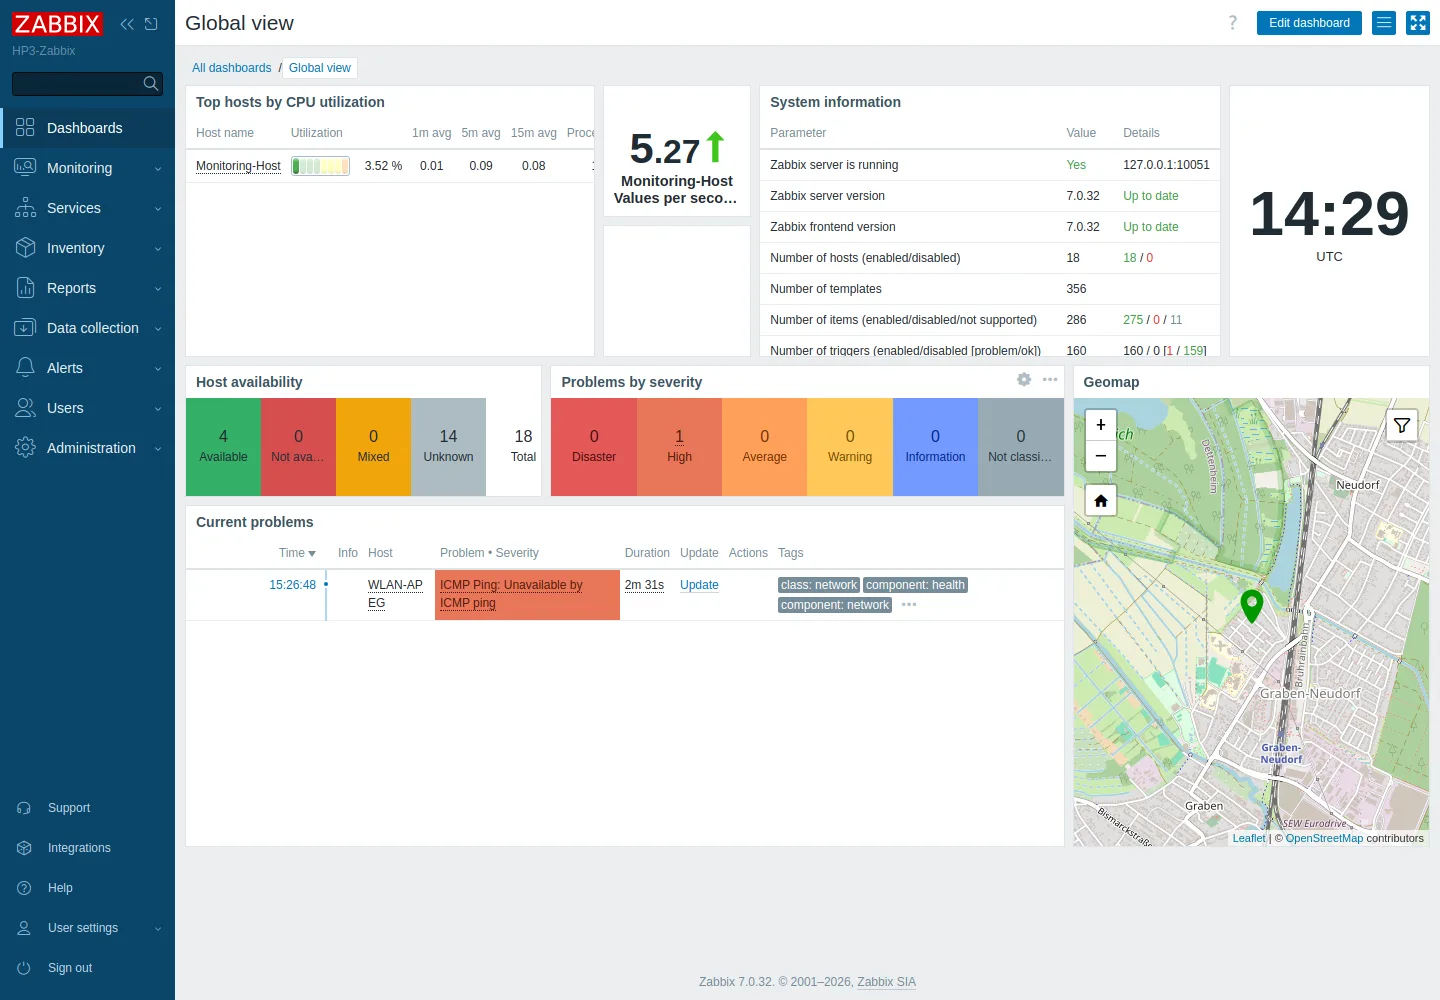
A página inicial mostra a disponibilidade de todos os hosts, problemas por severidade, os problemas atuais e um mapa. O bloco “Host availability” confunde no começo: dispositivos sem agente aparecem em cinza como “Unknown”. Não é erro – eles simplesmente não têm agente; o estado deles fica nas checagens de ping e porta. O mapa (Geomap) posiciona os dispositivos no local registrado no inventário; cadastrei a cidade em vez de um endereço exato.
Monitoring → Problems: o que está quebrado agora
Esta é a página mais importante. Cada problema aberto aparece aqui com início, duração e severidade. Com Update você reconhece um problema (“estou cuidando”) e deixa um comentário. O filtro History também mostra problemas resolvidos – útil para descobrir depois quando o access point sumiu pela última vez.
Monitoring → Hosts e Latest data: o estado de cada dispositivo
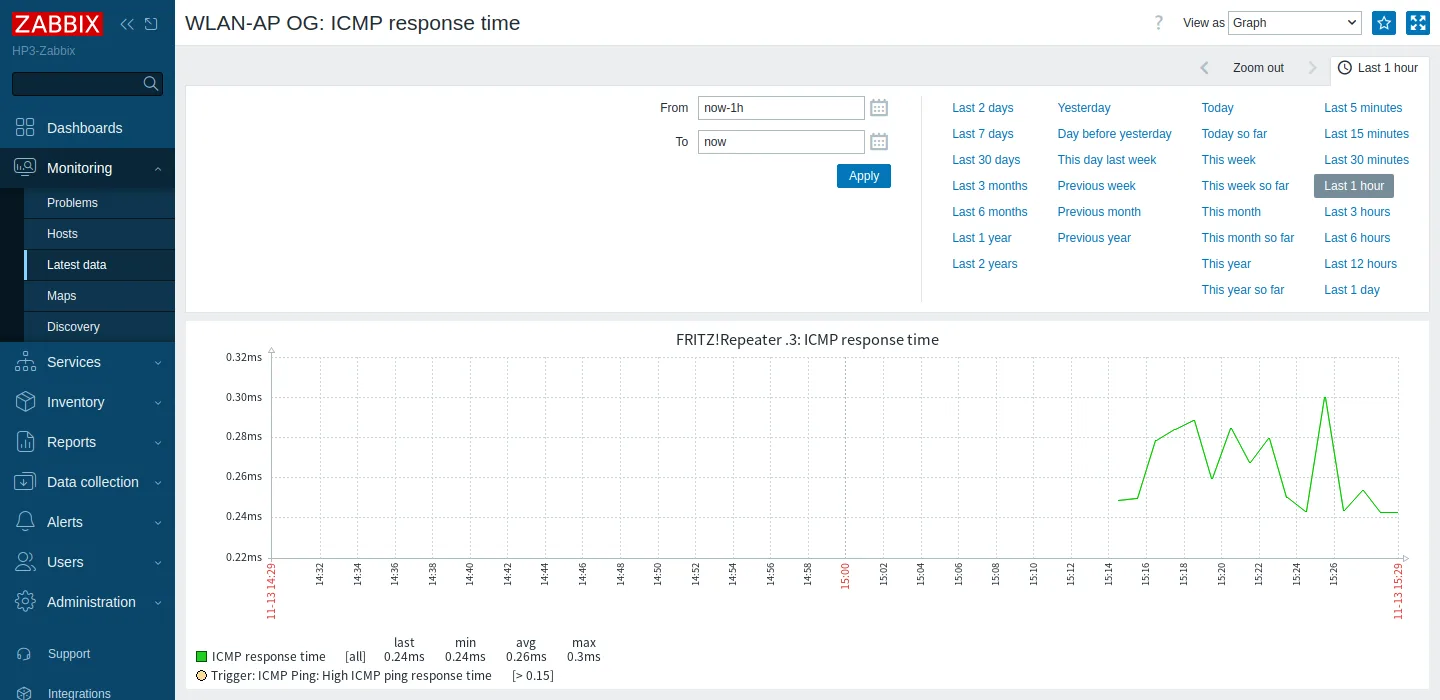
Monitoring → Hosts (imagem acima, em “O que é monitorado”) lista cada dispositivo com links para seus valores mais recentes, problemas, gráficos e web scenarios. Latest data mostra os valores crus: se o último ping voltou, quanto demorou, se uma porta estava aberta. Cada valor tem link para um gráfico.
Monitoring → Hosts → Web: os servidores externos
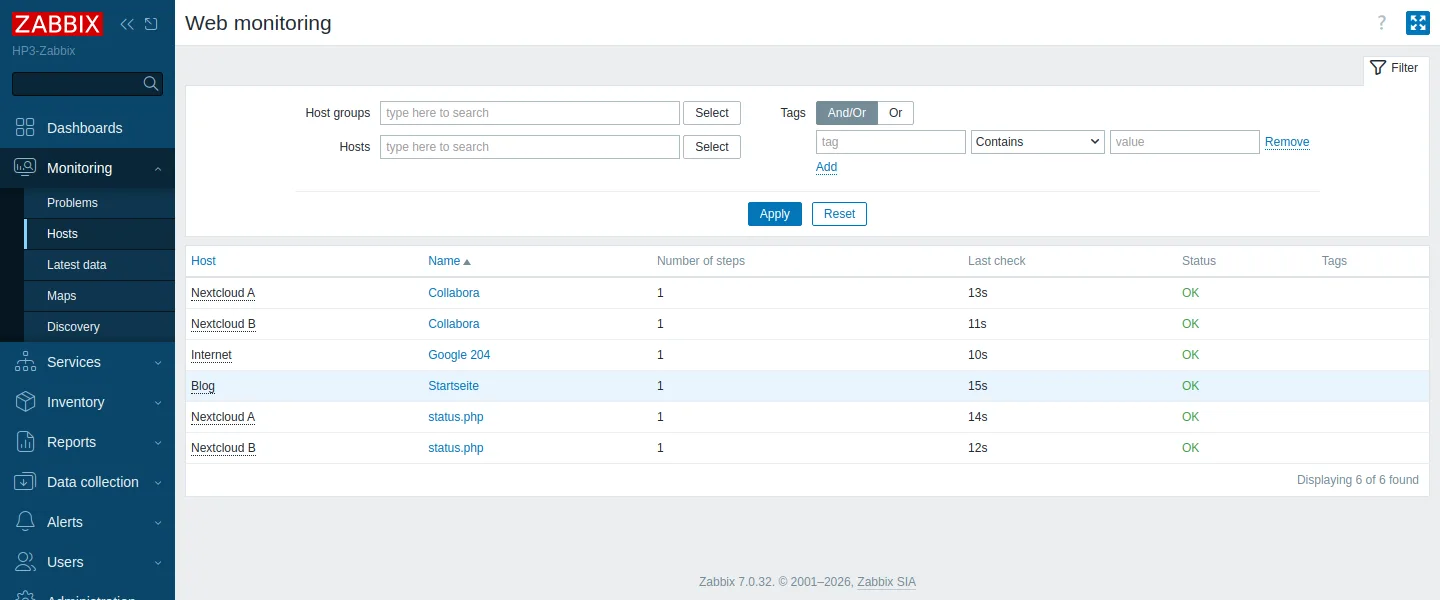
O Zabbix 7.0 não tem entrada de menu própria para isso: em Monitoring → Hosts, clique no link Web ao lado de um dispositivo. É ali que ficam os web scenarios do blog, do Nextcloud e do Collabora, com horário e resultado da última execução. Clicando num nome você vê o tempo de resposta e a velocidade de download ao longo do tempo. Se um scenario falha, ele diz qual etapa falhou e com qual erro.
Data collection → Hosts: adicionando um dispositivo novo
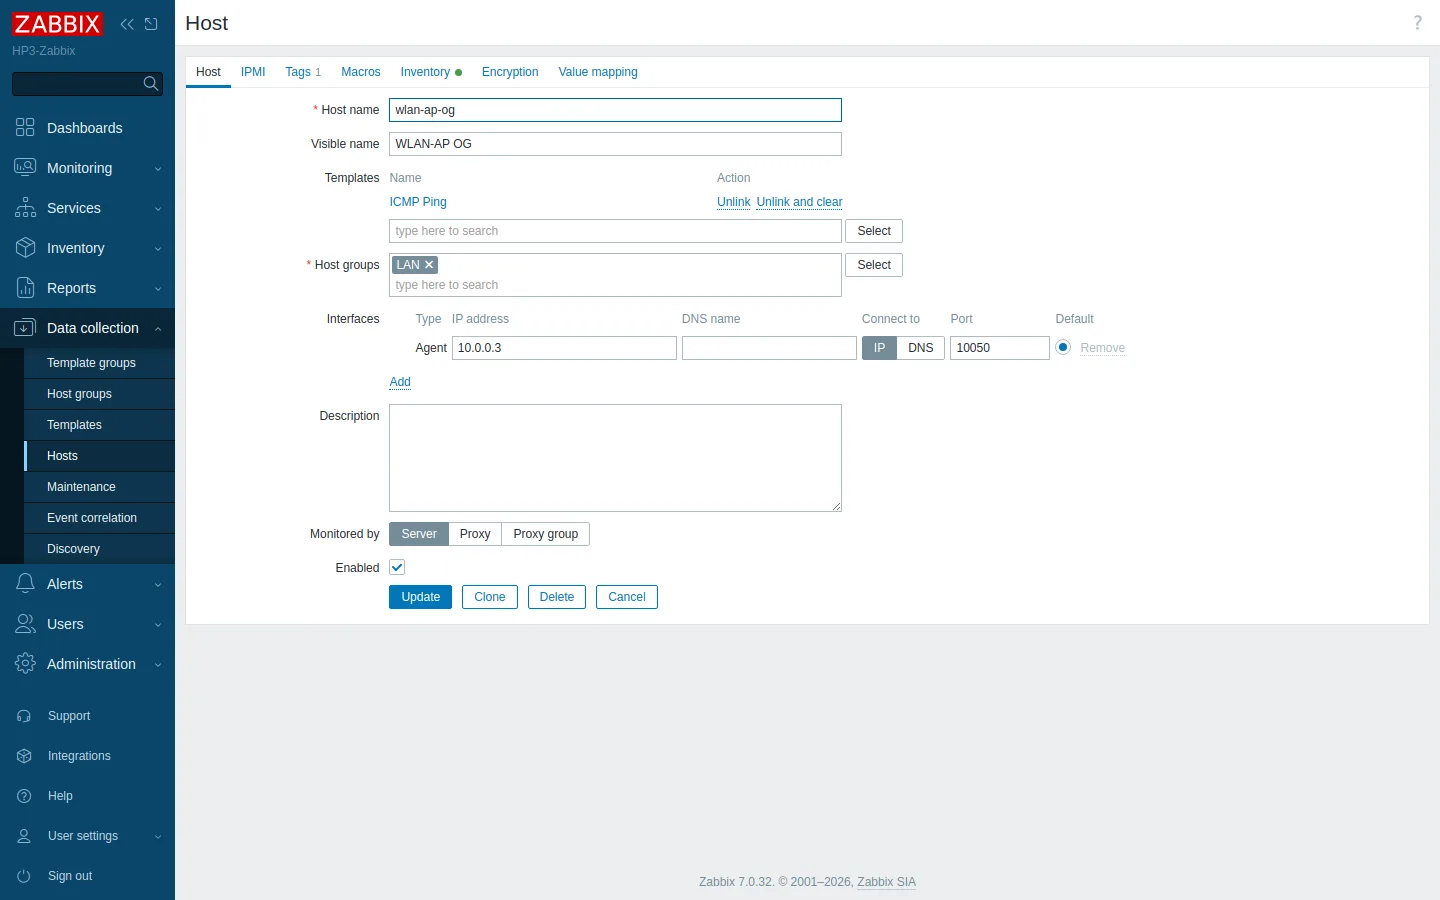
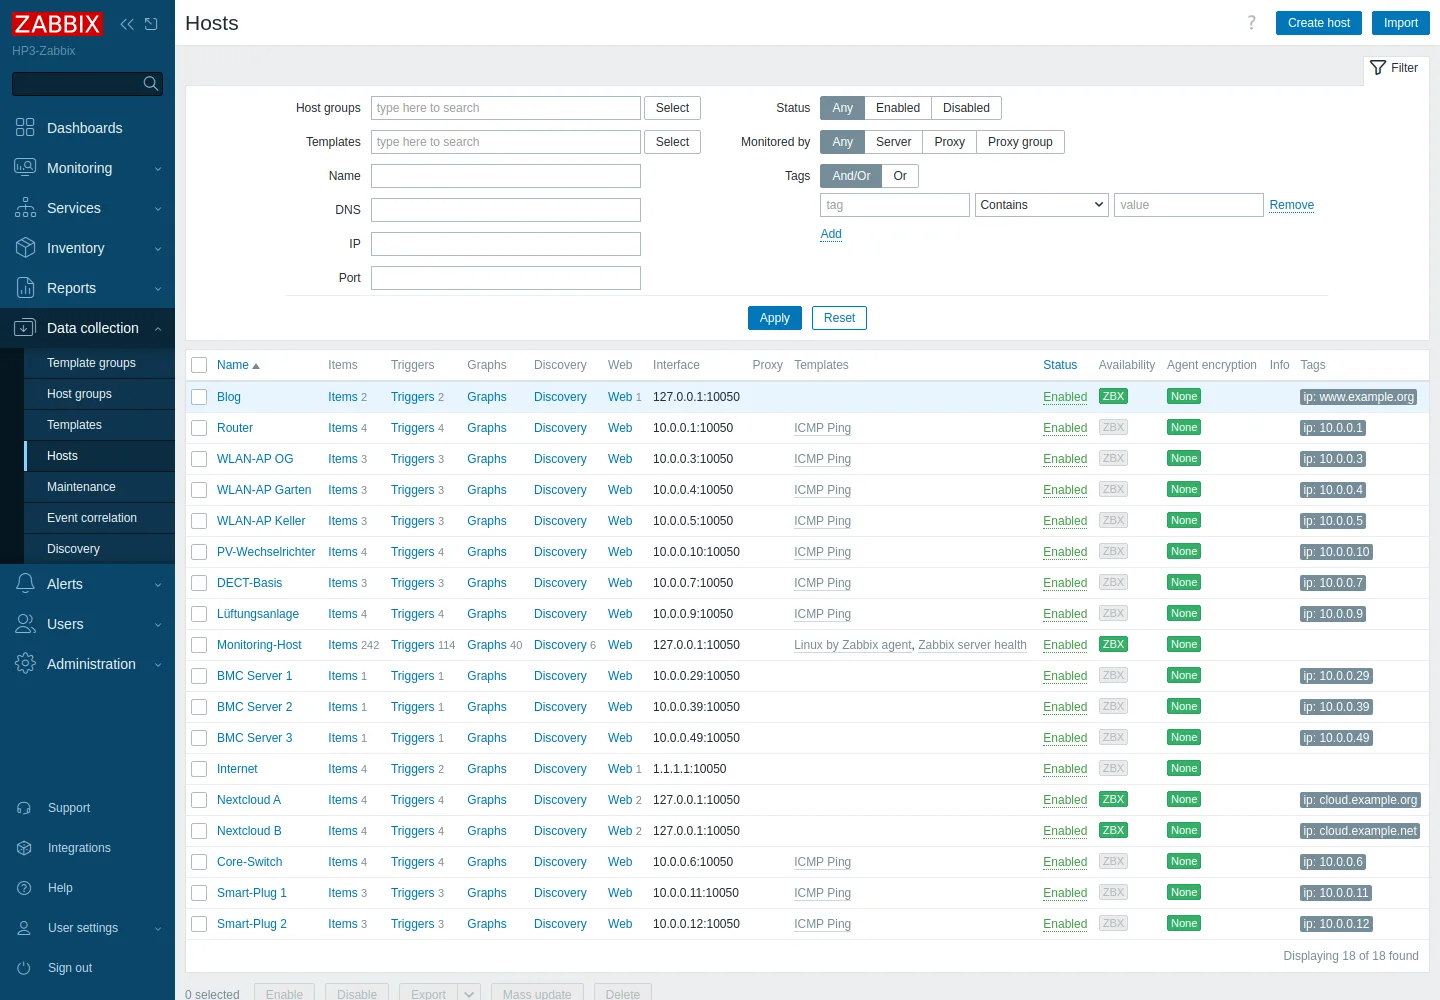
Dispositivos novos são adicionados em Data collection → Hosts → Create host. Para um dispositivo que só precisa de checagem de ping, cinco campos bastam:
- Host name – o nome técnico, só caracteres simples.
- Visible name – o nome exibido em todo lugar.
- Templates – escolha ICMP Ping.
- Host groups – por exemplo LAN.
- Interfaces – uma interface com o endereço IP do dispositivo. O tipo não importa para o ping; o Zabbix pega o endereço da interface.
Salvar, pronto – os primeiros valores chegam em menos de um minuto. Para verificar também uma porta, adicione nos Items do host um item do tipo Simple check com a chave net.tcp.service[tcp,,443], e em Triggers um alerta como max(/<host>/net.tcp.service[tcp,,443],#3)=0.
Logo ao lado fica Data collection → Maintenance. É ali que você registra horários em que dispositivos ficam desligados de propósito – por exemplo um PC de backup que só roda de vez em quando. Nenhum e-mail é enviado nesses períodos.
Alerts → Media types e Actions: fazendo o e-mail chegar
Dois lugares decidem se um e-mail é enviado:
- Alerts → Media types → Email: servidor SMTP, porta, criptografia, remetente e credenciais. O link Test envia daqui um e-mail de teste.
- Alerts → Actions → Trigger actions: a action existente Report problems to Zabbix administrators precisa estar Enabled. Ela define quem é notificado sobre um problema e sobre a recuperação.
Depois o destinatário: cadastre seu próprio endereço em Users → Users → Admin → Media.
O próprio HP3: gráficos como no Grafana
Para o HP3, o Zabbix montou os gráficos sozinho a partir do template Linux: CPU, memória, load, rede por placa, uso de cada dataset ZFS e I/O de disco. Você os encontra em Monitoring → Hosts → Graphs ou no dashboard do host que o Zabbix cria automaticamente.
A lição: De todas as entradas de menu, você precisa de quatro no dia a dia: Problems, Hosts, Latest data e Create host. O resto é configuração que se faz uma vez.
🔄 O que vem a seguir
Algumas checagens agora existem em dobro: meu uptime check existente continua testando o blog e o Nextcloud, e o Zabbix também. Isso é proposital. Os dois rodam em paralelo por algumas semanas, depois decido se o Zabbix substitui o uptime check. A favor do Zabbix estão histórico e tempos de resposta; a favor do uptime check, que ele é minúsculo e quase nada pode dar errado com ele.
Para mim era igualmente importante que tudo pudesse ser removido de novo. Como tudo roda rootless com meu usuário, remover significa parar quatro serviços, apagar quatro arquivos e um diretório. Anotei esses passos enquanto montava.
Até agora, o Zabbix pergunta à maioria dos dispositivos só uma coisa: “Você ainda está aí?” No próximo post ele deve olhar por dentro deles:
- FRITZ!Box e repetidores via TR-064. Eles não falam SNMP, mas essa interface informa o estado da linha de internet, a taxa de sincronização e o número de clientes WLAN. Esse é o ganho de verdade: um access point pode responder a ping e mesmo assim ter parado de transmitir WLAN. “Nenhum cliente por três horas” é o alerta que realmente ajuda.
- O switch via SNMP. Com a MIB padrão (IF-MIB), o Zabbix vê o estado, os erros e o tráfego de cada porta e avisa quando uma porta cai.
- O hardware dos servidores via iLO. Para ventoinhas, temperaturas, fontes e discos, o Zabbix traz um template pronto que consulta o Redfish (HTTP).
- O sistema solar. O inversor Fronius tem sua própria interface JSON, a Solar API. O Zabbix consegue consultá-la sem software extra e desenhar gráficos de geração a partir dela.
- Menos e-mails durante uma queda. Se o switch falhar hoje, cada dispositivo atrás dele manda seu próprio e-mail. Com dependências entre os alertas, o Zabbix sabe que tudo depende do switch e reporta só o switch.
- Um segundo canal de alerta, como uma notificação push no meu celular (ntfy), caso o próprio caminho do e-mail quebre. Além de retenção mais curta das medições e um backup noturno do banco.
E, sinceramente, espero que o primeiro e-mail de verdade do Zabbix demore bastante para chegar.
A lição: Rodar uma ferramenta nova ao lado da antiga custa pouco e mostra se ela é melhor no dia a dia. Anotar a remoção logo de cara tira o risco de experimentar.
🎯 As lições
- O monitoramento só vê aquilo para o que você o construiu. As lacunas silenciosas são os dispositivos sem agente.
- Um alerta só está provado quando uma queda provocada de propósito chega à caixa de entrada – recuperação incluída.
- Confira os padrões: o Zabbix não tem action de e-mail ativa de fábrica, e o fuso horário é UTC.
- Com contêineres, os problemas costumam estar na fronteira com o kernel: capabilities, arquivos de dispositivo, mounts.
- Para testes, use endereços que garantidamente não pertencem a ninguém – “não respondeu no scan” não significa “livre”.
🔧 Adendo: menos carga de escrita para os SSDs
Depois da publicação surgiu a pergunta se escritas pequenas e constantes prejudicam o RAIDZ feito de SSDs. Então medi o que o banco realmente escreve: cerca de 750 transações por minuto, das quais umas 110 forçaram uma escrita imediata em disco via fsync – quase duas por segundo. Cada fsync impede o ZFS de juntar escritas na RAM e gravá-las em lotes, e num RAIDZ cada bloco pequeno vai para os discos junto com sua paridade.
Comparado à vida útil dos SSDs isso é inofensivo: uns 200 a 300 MB por dia são desprezíveis para discos especificados para cerca de 1.300 TB de escrita cada. Como o servidor está num nobreak, mesmo assim passei o PostgreSQL para escrita em lotes – quatro opções no arquivo Quadlet do banco:
| Configuração | Efeito |
|---|---|
synchronous_commit=off | Um commit não espera mais pelo disco; o log de transações é gravado em segundo plano |
wal_writer_delay=2000ms | O processo em segundo plano grava só a cada 2 segundos em vez de a cada 200 ms |
checkpoint_timeout=15min | Checkpoints a cada 15 em vez de a cada 5 minutos, menos páginas de dados gravadas duas vezes |
wal_compression=lz4 | O log de transações é comprimido |
O resultado, por minuto sob carga comparável:
| antes | depois | |
|---|---|---|
escritas forçadas (fsync) | 111 | 30 |
| log de transações | ~80 KB | ~72 KB |
O preço: se a energia cair apesar do nobreak, as medições dos últimos segundos podem faltar. O banco continua consistente – com synchronous_commit=off o PostgreSQL só perde as transações mais recentes, nunca danifica as mais antigas. Para dados de monitoramento é uma boa troca.
A lição: Primeiro meça, depois otimize. A primeira configuração sozinha quase não adiantou nada; só a medição mostrou que o processo em segundo plano continuava gravando cada pequena mudança sozinho num ritmo de 200 ms.
As capturas de tela estão anonimizadas: nomes de dispositivos, endereços IP, domínios e endereços de e-mail foram substituídos por placeholders neutros antes de tirá-las, e a queda é encenada.