
Oito horas para um backup: como um disco SMR, o rdiff-backup e o Hugo se atrasavam uns aos outros
Meu PC de backup ultimamente rodava por mais de oito horas, embora quase nenhum dado tivesse mudado. A pista levou a um disco rígido com telhas, a uma ferramenta que grava cada arquivo no disco separadamente e a um blog que reescreve 70.000 arquivos a cada build.
🌐 Também em: English · Deutsch · Français · Español · Italiano · Nederlands · Polski
Em resumo: Meu PC de backup precisou ultimamente de oito horas e 18 minutos para uma execução, com dados que quase não tinham mudado. Não havia uma causa, mas três que se reforçavam: um disco rígido SMR, que desaba com muitas gravações pequenas; o rdiff-backup, que força cada arquivo no disco individualmente; e meu blog em Hugo, que a cada build reescreve todos os seus cerca de 70.000 arquivos. Agora faço o backup do blog como um único arquivo tar.gz (38 segundos em vez de até quatro horas), o rdiff-backup roda com --no-fsync, e o que pode ser regenerado fica de fora.
Índice
🐢 O sintoma: oito horas para quase nada
Meu PC de backup é uma máquina antiga que ligo quando é hora de fazer backup: ela busca tudo e depois se desliga sozinha. Faz backup de quatro coisas, uma após a outra: Nextcloud, o blog, os compartilhamentos do NAS e meu diretório pessoal no computador de trabalho. A ferramenta para tudo: rdiff-backup. Ele mantém um espelho atual e, para cada arquivo alterado, coloca ao lado um arquivo “increment” com o estado anterior; assim é possível recuperar qualquer versão antiga.
Por muito tempo foi rápido. Depois a estatística ficou assim:
| Execução | Nextcloud | Blog | NAS | Home | Total |
|---|---|---|---|---|---|
| 12/11 | 15 min | 0 min | 1 min | 39 min | 56 min |
| 17/11 | 55 min | 169 min | 6 min | 167 min | 6 h 37 min |
| 19/11 | 4 min | 110 min | 186 min | 198 min | 8 h 18 min |
Mesmos dados, mesmo hardware: às vezes pouco menos de uma hora, às vezes mais de oito. Nenhuma execução precisou de muito mais espaço. Não era o volume, era outra coisa.
🏠 Descoberta 1: o disco rígido tem telhado de telhas
Primeiro olhar para o hardware: o disco de backup é um Seagate Barracuda de 8 TB. Esse modelo usa SMR (Shingled Magnetic Recording): as trilhas se sobrepõem como telhas. Assim cabem mais dados no prato, mas há um porém: quem altera uma trilha também sobrescreve a vizinha que está meio por cima; o disco precisa então ler e regravar áreas inteiras (bandas).
Para que isso não apareça no dia a dia, o disco tem uma pequena área de buffer gravada da forma convencional. Os dados novos caem primeiro ali, e o disco os reorganiza nas bandas de telhas nos momentos de calma. Arquivos grandes de uma vez não são problema. Muitas gravações pequenas, por outro lado, enchem o buffer rapidamente, e então o desempenho de gravação cai de mais de 100 MB/s para uma fração, porque o disco recebe e reorganiza ao mesmo tempo.
Em um disco para filmes ou fotos você nunca percebe. Em um backup de centenas de milhares de arquivos pequenos, percebe muito bem.
💾 Descoberta 2: o rdiff-backup grava cada arquivo separadamente
Segundo olhar: como o rdiff-backup grava. Para cada arquivo que cria ou substitui, ele chama fsync, que obriga o sistema operacional a gravar o arquivo fisicamente no disco na hora, em vez de juntá-lo na memória. A intenção é boa: se a máquina travar no meio da execução, cada arquivo já salvo está de fato no disco.
Em um disco SMR, porém, é o pior caso: cada arquivo é uma pequena gravação síncrona. Nas execuções medi cerca de 10 a 15 arquivos por segundo. Com algumas centenas de arquivos alterados, tanto faz. Com 200.000, são quatro horas.
🔁 Descoberta 3: o Hugo reescreve tudo a cada build
E de onde vêm 200.000 arquivos alterados se mudo apenas um post? Da mudança para o Hugo. Desde então meu blog é uma coleção de arquivos estáticos: cerca de 150 posts em 8 idiomas, mais páginas de tags, categorias, paginação, feeds, o índice de busca e imagens em vários tamanhos, ao todo cerca de 70.000 arquivos.
O Hugo reconstrói o site inteiro a cada deploy e o coloca no lugar completamente de novo, inclusive as páginas que não mudaram nada. Para o rdiff-backup, depois de cada deploy quase todo arquivo mudou: nova cópia no espelho mais um arquivo increment com o estado anterior. Dependendo de quantos deploys houve desde a última execução, eram de 59.000 a 214.000 arquivos novos por execução. A 10–15 arquivos por segundo: de 110 a 234 minutos só para o blog.
No WordPress isso não era problema: tudo ficava em um banco de dados, e o backup era um único dump.
🧩 O mesmo padrão em mais dois lugares
Quando o princípio ficou claro, ele apareceu em outros lugares também:
- NAS (186 minutos em 19/11): no dia anterior eu tinha organizado minhas pastas e movido muitas delas. Para o rdiff-backup, um arquivo movido é um apagado mais um novo: duas gravações por arquivo. Um efeito pontual; em 20/11 voltou a 54 segundos.
- Diretório pessoal (até 198 minutos): de cerca de 420.000 arquivos, uns 360.000 são coisas que podem ser regeneradas a qualquer momento: imagens de contêineres, caches, ambientes Python,
node_modules, o site compilado, arquivos de trabalho da extração de CDs. Eles mudam o tempo todo e não valem nada numa emergência.
🛠️ O que mudei
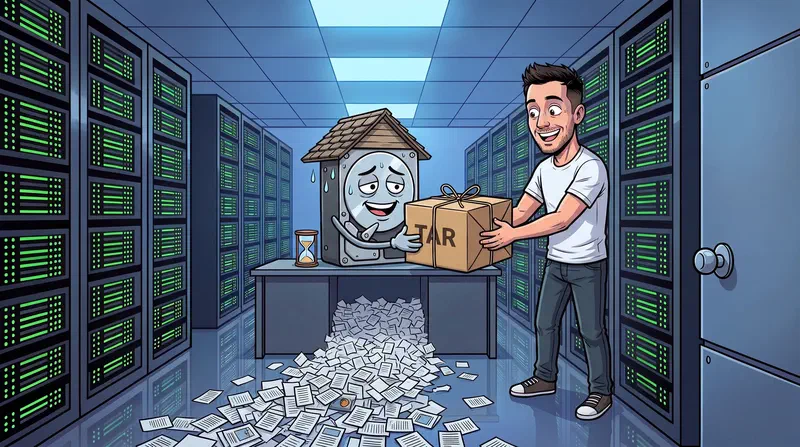
1. O blog é salvo como um único arquivo. Em vez de espelhar 70.000 arquivos individuais com o rdiff-backup, a máquina de origem empacota o estado com tar, comprime com gzip -1 e envia ao PC de backup como um único fluxo de dados. Lá chega exatamente um arquivo. É o caso ideal para qualquer disco rígido, e mais ainda para um disco SMR.
ssh origem "tar -C /storage --numeric-owner -cf - blog | gzip -1" > blog_2026-11-20_0814.tar.gz.part
tar -tzf blog_2026-11-20_0814.tar.gz.part | wc -l   # verificar primeiro, só depois renomear
Antes, o script verifica se o último backup na origem deu certo; depois, se o arquivo pode ser lido e contém a página inicial. Só então ele recebe o nome definitivo. gzip -1 basta: as imagens já estão comprimidas, um nível maior só custa tempo.
Retenção: todos os arquivos dos últimos 30 dias, mais o primeiro arquivo de cada mês durante um ano. É menos detalhado que o histórico de versões do rdiff-backup, mas mais do que suficiente para um blog cujo código-fonte já está no Git. O histórico antigo do rdiff fica para o período anterior.
2. rdiff-backup sem fsync para cada arquivo. Para Nextcloud, NAS e diretório pessoal, o rdiff-backup agora roda com --no-fsync. No final de toda a execução há um único sync que grava tudo no disco. O risco é administrável: se o PC de backup travar no meio, aquela execução fica incompleta; mas isso também acontece com fsync, e o rdiff-backup limpa sozinho uma execução interrompida na próxima inicialização (regress).
3. O que pode ser regenerado fica de fora. O diretório pessoal agora tem uma lista de exclusões: armazenamento de contêineres, .cache, .venvs, node_modules, .npm, o site compilado e pastas de trabalho. Tudo isso se restaura com um comando.
📊 O resultado
A primeira execução com todas as mudanças, em 20/11:
| Etapa | antes (19/11) | depois (20/11) |
|---|---|---|
| Nextcloud (810.000 arquivos) | 4 min 26 s | 2 min 29 s |
| Blog | 110 min | 38 s (um arquivo, 888 MB, 113.002 entradas) |
| NAS | 186 min | 54 s |
| Home | 198 min | 101 min 22 s |
| Total | 8 h 18 min | 1 h 45 min |
No diretório pessoal a primeira execução é um caso especial: o rdiff-backup registra uma vez como “apagados” os arquivos recém-excluídos, ou seja, centenas de milhares de arquivos increment pela última vez. A partir da execução seguinte, eles somem de vez.
💡 Um SSD teria resolvido isso também?
Eu também me fiz essa pergunta. Um SSD (ou um disco com CMR clássico) seria bem mais rápido com muitos arquivos pequenos, sem dúvida. Mas só teria aliviado o sintoma: 200.000 arquivos increment por execução para um site que pode ser reconstruído a partir do Git a qualquer momento são desperdício também num SSD. Primeiro reduzir o número de arquivos, depois pensar em hardware. Trocar por um disco CMR, ou pelo Borg, que agrupa arquivos pequenos em blocos grandes, fica como opção para depois.
🤝 Como foi a análise
Fiz a investigação com o Claude Code: só disse “o backup leva oito horas, veja se consegue otimizar algo” e acrescentei algumas ideias (um arquivo compactado, mais buffer em RAM, substituir o rdiff-backup, verificar o disco). O Claude analisou os tempos nos logs das últimas semanas, identificou o modelo do disco como SMR, contou os arquivos increment por execução e fez a ligação com o build do Hugo. Escreveu os scripts e, quando eu disse “vamos refazer”, interrompeu o backup em andamento e o reiniciou com a nova versão.
🎯 Conclusão: não o volume, a quantidade
- O tempo de backup depende do número de arquivos, não dos gigabytes. 888 MB de uma vez: 38 segundos. Os mesmos dados como 200.000 arquivos individuais: quatro horas.
- Discos SMR são uma má escolha para backups de muitos arquivos pequenos. Consulte a ficha técnica antes de comprar: “SMR” costuma aparecer só nas letras miúdas.
- Sites estáticos se salvam como arquivo compactado, não arquivo por arquivo. O código-fonte já está no Git.
- O que pode ser regenerado não pertence ao backup. Caches e imagens de contêineres custam tempo e não ajudam numa emergência.
- Primeiro medir, depois comprar. Um disco novo só teria deixado o problema menor.
📚 Posts relacionados: