🌐 También en: English · Deutsch · Français
Como anuncié en mi último artículo, uno de mis objetivos era meterme por fin en el mundo de las herramientas de IA locales. Ya sabes, eso de lo que los chicos guays de Reddit no paran de presumir: ejecutar tus propios modelos de generación de imágenes, en tu propio hardware, sin que ningún proveedor cloud te limite a escondidas porque has pedido «un gato con sombrero de mago» una vez de más. Así que saqué mi vieja torre de su semijubilación, le planté una instalación limpia de Debian y, armado con una guía paso a paso que ChatGPT había tenido la amabilidad de escribirme, empecé a instalar ComfyUI y FLUX.1-schnell. ¿Mi motivación principal? Genero un montón de imágenes para este blog, y a ChatGPT/DALL-E y compañía les encanta soltarme un «has alcanzado tu límite» o un «esto infringe nuestra política de contenido» después de unos tres prompts. Genial. Genial de verdad. Hora de montarme el mío. 💪😴 Y entonces… me distraje
La historia de siempre: hace unos días instalé lo básico, me topé con un obstáculo, perdí la motivación y lo dejé todo a medias: venv medio activado, pestaña del navegador abierta, historial del terminal lleno de comandos a medio terminar. Arqueología digital esperando a que alguien la desentierre. Hoy pensé: «vamos a pasarle este desastre a Claude a ver qué pasa». Así que le di acceso SSH a la máquina y básicamente le dije: «termina lo que yo empecé». Lo que vino después fue, sinceramente, una de las tardes más surrealistas que he pasado con un software.🕵️ Paso 1: Claude juega a los detectives
En lugar de arrasarlo todo y empezar de cero (mi método habitual, seamos sinceros), primero leyó mi historial de la shell. Como un auténtico investigador. Descubrió que:- ComfyUI ya estaba clonado y configurado en un venv en
~/ai/ComfyUI - Los pesos de FLUX.1-schnell (un UNet rechoncho de 23 GB, más los codificadores de texto CLIP/T5 y el VAE) ya estaban descargados
- La GPU era una RTX 3050 con 8 GB de VRAM: Debian 13, 32 GB de RAM, 16 núcleos
⚙️ Paso 2: «Conviértelo en un servicio de verdad»: a la orden
Pedí que ComfyUI funcionara como un servicio en segundo plano como es debido (porque no pienso dejar una sesión SSH abierta 24/7 como un salvaje). Claude escribió una unidad desystemd, la habilitó y en unos dos minutos ya estaba funcionando de forma permanente. A prueba de reinicios. Reinicio automático si se cae. Con todo incluido.🇩🇪 Paso 3: «Pero ¿entiende prompts en alemán?»
Este fue el momento en que se me cayó un poco la mandíbula. Quería saber si podía escribir los prompts directamente en alemán (porque, obviamente, es mi lengua materna y soy un vago). Así que Claude montó sobre la marcha un pequeño flujo de trabajo de texto a imagen para la API de FLUX y le pasó:«Ein gemütliches Café in Paris bei Sonnenuntergang, digitale Kunstmalerei, warmes Licht, Menschen sitzen draußen»… esperó unos 60 segundos, descargó el PNG resultante por SCP y me lo enseñó. Una escena de cafetería parisina al atardecer realmente preciosa. En alemán. A la primera. No esperaba que simplemente funcionara. ☕
🧩 Paso 4: «Esta interfaz tiene 4000 botones y yo solo quiero un cuadro de texto»
Luego abrí la interfaz web de ComfyUI propiamente dicha y… ya. Grafos de nodos por todas partes. Deslizadores, desplegables, cables que conectan cajas como el panel de conexiones de un sintetizador diseñado por alguien a quien le encantan los nodos de verdad, de verdad. Básicamente le dije: «Solo quiero algo como ChatGPT: un cuadro, escribo texto, sale una imagen». Así que Claude me construyó una miniaplicación web a medida desde cero:- Una aplicación Flask con exactamente un campo de texto y un botón
- Por detrás, construye el JSON completo del flujo de trabajo de FLUX, lo envía a la API de ComfyUI, consulta hasta que termina y sirve la imagen resultante
- También la empaquetó en su propio servicio de
systemd, en su propio puerto
🖼️ Paso 5: «Vale, pero ¿puedo subir una imagen y que la modifique?»
A esas alturas estaba lanzado, así que tenté a la suerte: «¿Puedo subir una imagen existente como plantilla y que la IA la modifique?» (img2img, para los frikis del público). Claude:- Añadió Pillow en un venv aparte para el preprocesado de imágenes (redimensionando a múltiplos de 16, porque por lo visto los VAE son quisquillosos con las dimensiones)
- Amplió el flujo de trabajo con los nodos
LoadImage+VAEEncode - Añadió a la interfaz un deslizador de «intensidad de transformación» (denoise)
- Y luego lo probó él mismo: volvió a subir la imagen del dragón y pidió «el dragón ahora escupe fuego azul, es de noche con un cielo estrellado»
📊 Paso 6: me toca hacer las preguntas tontas
Como es natural, tuve que ponerme a husmear en la máquina yo mismo y ejecutétop mientras se generaba una imagen:MiB Spch: 32013,4 total, 632,3 free, 22986,9 used, 8827,1 buff/cache
MiB Swap: 32680,0 total, 27500,7 free, 5179,2 used. 9026,5 avail Spch
PID USER PR NI VIRT RES SHR S %CPU %MEM ZEIT+ BEFEHL
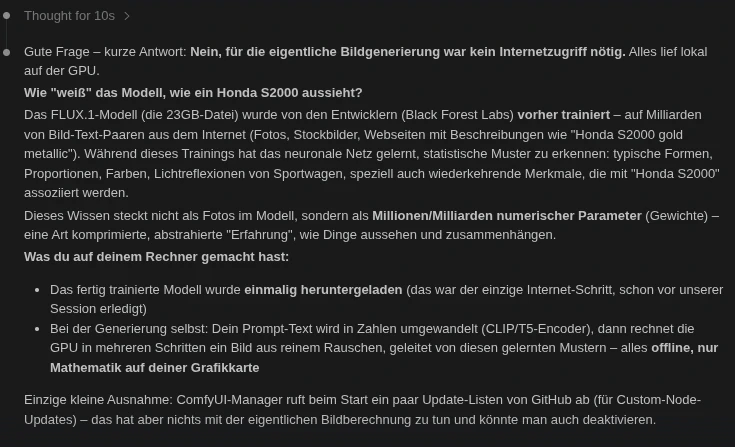
1221 me 20 0 56,5g 21,2g 112128 S 55,1 67,7 3:34.24 pythonnvidia-smi en bucle en paralelo:Time GPU-Load VRAM Temp Fan
Start 34% 6.3 GB 42°C 0%
Sampling 100% 6.9 / 8 GB 53→62°C 0%
After 0-6% 3.2 GB 60→47°C 65%🤔 Entonces… ¿dónde me deja todo esto?
¿Sinceramente? Aquí estoy, a partes iguales impactado y fascinado. Lo que empezó como «por favor, termina de instalar esto que dejé a medias» se convirtió en una sesión de ingeniería iterativa en directo: surgían requisitos nuevos en mitad de la conversación, se recogían al momento, se probaban, se ajustaban y me los explicaba en lenguaje llano. Sin tener que volver a explicar el contexto cinco veces. Sin un «no puedo hacer eso». Simplemente… progreso, en tiempo real, en mi propio hardware. Voy a ser directo: a quienes descartáis la IA como «un autocompletado con pretensiones», «tonterías peligrosas» o un «generador de chorradas que suena muy seguro mientras se equivoca», creo que simplemente no estáis mirando cómo se usa y se orquesta esto hoy en día. Yo mismo estaba mucho más en ese bando antes. He cambiado de opinión. Verlo investigar una instalación a medias, tomar decisiones de infraestructura sensatas, escribir código real que funciona, desplegarlo, probarlo con modelos reales y luego depurar la calidad de su propia producción no es «ciencia ficción». Eso ha pasado en mi LAN, esta noche. Y sí, eso es justo lo que también me preocupa un poco. Si una IA conversacional es capaz de configurar servicios con soltura, escribir pequeñas aplicaciones, configurar systemd, depurar el comportamiento de la memoria de una GPU y explicarlo todo de forma que una persona lo entienda al instante, ¿qué significa eso para los empleos de TI y el trabajo de administración de sistemas en los próximos 20 años? No estoy en pánico, pero tampoco voy a seguir fingiendo que la pregunta es una tontería. 🤷 En fin. Ahora tengo un generador de imágenes privado, local e ilimitado funcionando en un PC que antes acumulaba polvo debajo de mi escritorio. A partir de ahora, espera muchas más imágenes generadas por IA (y más raras) en este blog. En el próximo artículo quiero ir más allá: ampliar esta configuración con traducción de prompts, generación de código y más. Hoy todo giraba en torno a la creación de imágenes, pero está claro que esto es solo el principio.